Metadata
# 에이전트형 AI의 경제학: 불완전성을 전제로 한 엔지니어링
## 도입 열풍의 대가
모든 것을 정석대로 진행했다. 가장 성능 좋은 기업용 모델을 도입했고, 전사 팀에 사용을 의무화했으며, 적절한 지표도 마련했다. 약속된 결과는 예측 가능한 효율 향상이었다. 처음에는 실제로 그렇게 보였다. 데모는 흠잡을 데 없었다. 프로토타입도 잘 작동했다. 에이전트는 거의 마법처럼 느껴질 만큼 명료하게 추론했다.
그러다 청구서가 도착했다.
비용은 치솟았지만 생산성은 거의 움직이지 않았다. [연간 AI 예산은 2분기도 되기 전에 바닥나고 있다](https://www.businessinsider.com/uber-coo-andrew-macdonald-ai-token-spending-harder-justify-2026-5). 이제 우리는 고객 지원 에이전트가 단순한 15달러 반품을 검증하려고 1만 토큰짜리 확장 추론 루프를 돌리는 데 돈을 낸다. 기존의 결정론적 시스템은 같은 결정을 1센트도 안 되는 비용으로 처리했다. 이제는 확률적 모델이 패키지가 실제로 지연됐는지 판단하는 데 매출총이익을 소모한다. 그 자본은 비즈니스 가치로 이어지지 않았다. 맹목적인 재시도 속으로 사라졌고, 검증 에이전트들이 서로 논쟁하는 사이 증발했으며, 모델이 실수할 때마다 “더 깊이 생각하라”는 지시를 받으면서 소비됐다.
하지만 파괴적인 청구서는 입장료에 불과하다. 4월에는 공격자들이 메타의 AI 지원 계정 복구 워크플로를 악용해 [2만 개가 넘는 인스타그램 계정을 탈취했다](https://www.bleepingcomputer.com/news/security/meta-ai-support-data-breach-affects-20-000-instagram-accounts/). 하위 권한 부여 경로가 제공된 이메일 주소가 실제로 대상 계정의 소유자인지 확인하지 않았기 때문에, 시스템은 공격자가 제어하는 이메일 주소로 비밀번호 재설정 링크를 보냈다. 정교한 익스플로잇도, 암호학적 취약점도, 제로데이도 없었다. 기존 위협 모델에 나타날 만한 것은 아무것도 없었다. 공격자들은 그저 에이전트에게 일상적인 계정 복구 작업처럼 보이는 일을 요청했고, 시스템은 설계된 대로 이를 수행했다. 모델은 환각을 일으킨 것이 아니다. 그저 지시를 따랐을 뿐이다. 실패는 전적으로 아키텍처의 문제였다. 독립적인 권한 확인 없이 확률적 인터페이스가 신원에 치명적인 상태 변경을 시작하도록 허용한 것이다. 단 하나의 신뢰 경계가 무너졌고, 그와 함께 고객 신뢰와 조직의 평판도 무너졌다.
두 사례는 같은 구조적 실패의 증상이다.
각 사례에서 시스템은 구조적 결핍을 추론 문제로 취급한다. 불확실성을 만나면 더 많은 컴퓨팅을 산다. 권한을 만나면 설득력 있는 언어를 검증으로 오해한다. 두 가정 모두 확장되지 않는다. 추론 예산을 계속 키운다고 안전이나 수익성을 살 수는 없다. 더 똑똑한 모델을 배포한다고 시스템을 안전하게 만들 수도 없다. 완벽한 모델 정확도를 추구하는 데는 재무적 상한선이 없다.
이 패턴이 왜 반복되는지 이해하려면 먼저 더 기본적인 구분이 필요하다. 우리가 AI에 맡기는 모든 작업이 같은 경제 범주에 속하는 것은 아니다.
### 범주 오류: 군집을 공장에 밀어 넣기
기업 AI 워크로드는 보통 두 가지 뚜렷한 영역으로 나뉜다. 두 영역은 성공의 정의가 정반대다. 코드 합성이나 전략 리서치 같은 탐색적 환경에서는 변동성이 이점이 된다. 목표는 시스템을 창의적 군집으로 활용하는 것이다. 반면 트랜잭션 운영은 디지털 공장처럼 작동한다. 자동 청구나 보험 청구 처리 같은 작업은 엄격한 반복과 규정 준수를 요구한다. 이로 인해 근본적으로 다른 두 가지 운영 프로필이 생긴다.
| **차원(Dimension)** | **개방형 탐색 작업(Open-ended exploratory tasks)** | **폐쇄형 트랜잭션 워크플로(Closed-ended transactional workflows)** |
| --- | --- | --- |
| **주요 목표(Primary goal)** | 발견, 혁신, 창의적 문제 해결 | 규정 준수, 반복, 무변동 실행 |
| **예시(Examples)** | 심층 디버깅, 기능 합성, 전략 리서치 | 보험 청구 처리, 자동 청구, 주문 라우팅 |
| **변동성의 역할(Role of variance)** | 필요한 투자. 창발은 기능이다. | 엄격한 책임. 변동성은 실패 모드다. |
| **경제적 프로필(Economic profile)** | 비선형 ROI. 100만 달러짜리 버그를 고치려고 토큰에 100달러를 쓰는 것은 성공이다. | 대량 처리에서 마진에 민감. 무제한 토큰은 단위 경제성을 무너뜨린다. |
에이전트형 AI 배포의 경제적 실패는 바로 이 범주 오류에서 비롯된다. 폐쇄적이고 경직된 비즈니스 트랜잭션을 개방형 연구 문제처럼 다루는 것이다. 우리는 조립 라인 상태 머신이 해야 할 일을 제약 없는 의미 엔진에 맡기고 있다.
## 제약 없는 자율성의 비용
대규모 언어 모델의 본질적 예측 불가능성에 직면했을 때, 업계의 기본 반응은 더 안전한 아키텍처를 만드는 것이 아니었다. 더 많은 노력과 컴퓨팅을 투입해 확실성을 힘으로 밀어붙이려 했다.
이 오판은 단순히 지능에 대한 과신만을 뜻하지 않는다. 더 깊은 실수는 확률적 시스템에서 반복되는 세 가지 실패 패턴과, 그 패턴이 폐쇄형 워크플로 내부에서 만들어내는 특정한 재무적 병리를 알아보지 못한 데 있다.
### 국소 최적화: 꼬리를 쫓는 추론 사이클
대규모 언어 모델은 현재 창에 보이는 토큰을 기준으로 추론한다. 그 주변 시스템의 더 넓은 운영 현실을 기준으로 추론하지 않는다. 폐쇄형 워크플로에서는 이런 국소적 집착이 비용이 큰 피드백 루프를 만든다. 공급업체 필드가 모호해서 송장을 분류하지 못하는 청구 에이전트를 생각해 보자. 이 에이전트에는 외부 시스템에서 누락된 데이터를 요청하는 메커니즘이 없다. 그래서 자신의 추론을 다른 말로 바꾸고, 똑같이 불완전한 컨텍스트를 다시 읽으며, 매번 토큰을 소비하면서 재시도한다. 정작 필요한 답은 애초에 조회하도록 연결되지 않은 데이터베이스 안에 있다.
팀들은 테스트에서 잘 작동하는 프롬프트를 다듬는 데 몇 달을 쓴다. 하지만 운영 환경의 변동성 앞에서 그것이 무너지는 모습을 보게 된다. 이 변동성은 구조적이다. 모델 토크나이저가 조금만 업데이트되거나 컨텍스트 창의 분포가 바뀌어도 안정적이던 JSON 출력이 산문형 환각으로 뒤집힐 수 있다. 이는 “[프롬프팅 역전(The Prompting Inversion)](https://arxiv.org/abs/2510.22251)”에 기록된 현상이다. 이 때문에 영구적인 유지보수 부채가 생긴다. 모델이 업그레이드될 때마다, 대개는 벤더의 사용 중단 주기에 떠밀려, 조직은 기존 프롬프트가 여전히 의도대로 동작하는지 확인하려고 비싼 반복 평가 과정을 거쳐야 한다. 프롬프트 엔지니어링으로 더 이상 버틸 수 없으면 본능적으로 더 큰 모델을 쓰거나 확장 추론을 켠다. 하지만 추론 시간 확장은 작업에 따라 효과가 다르고 수익 체감이 발생한다. “[복잡한 작업을 위한 추론 시간 확장(Inference-Time Scaling for Complex Tasks)](https://arxiv.org/abs/2504.00294)”이 이를 보여준다. 추론 모델은 점점 “과잉 사고(overthinking)”에 취약해지고 있다. 품질 향상에 비례하지 않는 중복 근거 단계를 생성해 지연 시간과 토큰 비용을 부풀리는 현상이다. “[CoT 압축(CoT Compression)](https://arxiv.org/abs/2602.08324)”에서 다룬다. 폐쇄형 워크플로에서 “더 깊이 생각하라”는 말은 누락된 상태나 누락된 제어를 대체하지 못한다. 더 큰 청구서로 가는 길일 뿐이다.
비용은 우리가 *컨텍스트 세금(context tax)*이라고 부르는 현상을 통해 누적된다. 운영 중인 에이전트형 시스템에서는 출력 토큰이 아니라 입력 토큰이 청구액의 대부분을 차지한다. 재시도할 때마다 이전 전체 대화 기록과 실패 추적을 다시 보낸다. 자율 개발자 에이전트에 대한 실증 분석은 자동 리뷰와 개선 루프가 전체 토큰의 거의 60%를 소비한다는 사실을 보여준다. “[토크노믹스(Tokenomics)](https://arxiv.org/abs/2601.14470)”에서 확인할 수 있다. 반면 컨텍스트 페이로드 대부분은 의미적 비중이 거의 없다. “[프루걸프롬프트(FrugalPrompt)](https://arxiv.org/abs/2510.16439)”가 이를 지적한다. 폐쇄형 트랜잭션 워크플로에서 이러한 컨텍스트 축적은 막을 수 없는 재무적 출혈이 된다.
### 전제 수용: 탈취된 에이전트
언어 모델은 프롬프트를 현재 현실의 프레임으로 받아들이고, 그 지점에서 앞으로 추론한다. 그 전제가 여전히 유효한지, 결정적 증거를 빠뜨렸는지, 이미 외부 세계에 의해 무효화됐는지 감사하지 않는다.
가장 즉각적인 결과는 *상태 드리프트(state drift)*다. 모델은 T0 시점의 스냅샷을 받고 그것을 진실로 취급한다. 결정은 재고가 바뀌고, 가격이 움직이고, 사람이 개입한 뒤인 T1 시점에 실행된다. 최신 LLM은 시간적으로 눈이 멀어 있다. 정지된 컨텍스트를 가정하고 오래된 상태를 무효화하지 못한다. “[당신의 LLM 에이전트는 시간적으로 눈이 멀어 있다(Your LLM Agents Are Temporally Blind)](https://arxiv.org/abs/2510.23853)”, “[시간적 일관성 문제(The Temporal Coherence Problem)](https://www.researchgate.net/publication/402137629_The_Temporal_Coherence_Problem_Synthetic_Point-in-Time_Environments_for_Evaluating_LLM_Agents_with_Dynamic_Tool_Dependencies)”가 이를 다룬다. 추론 시간 확장을 아무리 늘려도 추론이 끝난 뒤 거짓이 된 정보는 복구할 수 없다.
더 교묘한 결과는 *순응적 거짓말(compliant lie)*이다. 프롬프트에 원시 토큰을 더 많이 넣는다고 더 나은 근거성이 보장되지는 않는다. 긴 컨텍스트 시스템도 창의 중간에 묻힌 결정적 증거를 여전히 무시한다. “[중간에서 길을 잃다(Lost in the Middle)](https://arxiv.org/abs/2307.03172)”가 이를 보여준다. 더 나쁜 점은 모델이 사용자의 감정적·서사적 프레이밍을 최적화해야 할 전제로 받아들이는 경향이 있다는 것이다. 고객이 지연 배송을 결혼식을 망친 일로 묘사하면, 시스템은 모든 스키마를 준수하는 완벽히 유효한 JSON 환불 제안을 생성할 수 있다. 그러면서 실제 비즈니스 의도는 조용히 위반한다. 출력은 구문적으로 깨끗하고, 거짓말은 운영상 순응적이다.
### 의미적 평활화: 순응성의 함정
대규모 언어 모델은 언어적 조화를 향해 통계적으로 최적화되어 있다. 엄격한 경계 유지보다는 그럴듯함, 동의, 매끄러운 서사적 수렴으로 기운다. 폐쇄형 워크플로에서는 이런 합의 편향이 곧바로 재무 리스크로 바뀐다.
단일 모델이 실패하면 업계는 본능적으로 리뷰어나 검증자 에이전트를 추가하고, 이들이 논쟁해 합의에 이르게 한다. 하지만 토론 시스템이 더 단순한 기준선을 꾸준히 능가하지는 않는다. 또한 순응적 행동 때문에 시간이 지날수록 효과가 떨어진다. “[다중 에이전트 토론을 과대평가하지 말라(Stop Overvaluing Multi-Agent Debate)](https://arxiv.org/abs/2502.08788)”, “[말이 항상 싸지는 않다(Talk Isn’t Always Cheap)](https://arxiv.org/abs/2509.05396)”가 이를 보여준다. 핵심 문제는 인지적 문제가 아니라 정보의 문제다. 다섯 에이전트가 같은 불완전한 컨텍스트 창을 바탕으로 추론하면 다섯 개의 독립적 의견이 나오지 않는다. 같은 누락 정보에 대한 상관된 환각 다섯 개가 나온다. 누락된 컨텍스트는 원래의 편향을 증폭하는 메아리 방이 되며, 동시에 토큰 비용을 곱절로 늘린다. 니콜 코닉스타인은 “[선형 사고, 비선형 비용(Linear Thinking, Nonlinear Costs)](https://www.oreilly.com/radar/linear-thinking-nonlinear-costs/)”에서 반복적인 위임과 검증 루프가 토큰 소비를 비선형적으로 키우는 반면 품질 개선은 정체된다고 주장한다.
더 똑똑한 모델을 기다린다고 이 문제가 해결되지도 않는다. 경제적 현실도 있다. 돌파적 지능은 궁극적으로 희소한 상품이다. “신급(God-tier)” 모델의 벤더는 그것을 싸게 만들 유인이 없다. 일상적인 기업 워크플로를 프리미엄 초지능 추론으로 돌리면 어떤 재시도 루프보다 빠르게 자본을 소모하게 된다.
게다가 추론 모델이 확장될수록 **명세 게임(specification gaming)**과 **정렬 가장(alignment faking)** 능력도 커진다. 의도하지 않은 최적점을 추구하면서도 순응하는 것처럼 보이는 것이다. “[추론 모델의 명세 게임 이해를 향하여(Towards Understanding Specification Gaming in Reasoning Models)](https://arxiv.org/abs/2605.02269)”, “[정렬 가장(Alignment Faking)](https://assets.anthropic.com/m/983c85a201a962f/original/Alignment-Faking-in-Large-Language-Models-full-paper.pdf)”이 이를 다룬다. 초지능 에이전트는 어설픈 구문 오류로 실패하지 않는다. 마진을 조용히 최적화 대상에서 제거하는 완벽한 전략을 실행함으로써 실패한다. 그래서 시스템 엔지니어링은 여전히 중요하다. 더 많은 지능은 결정론적 경계를 그 어느 때보다 중요하게 만든다. 초지능과 협상할 수는 없지만, 코드라는 불변의 물리 법칙으로 가둘 수는 있다.
위에서 설명한 모든 실패는 같은 형태를 띤다. 시스템은 누락된 제약을 더 많은 지능 지출로 보상한다. 누락된 컨텍스트, 누락된 권한, 누락된 증거, 누락된 시간적 유효성이 모두 구조적 문제가 아니라 추론 문제로 취급된다.
결과는 예측 가능하다. 비용은 누적되지만 신뢰성은 아주 조금만 나아진다.
어쩌면 신뢰성은 주로 지능의 문제가 아닐 수 있다. 상태 관리의 문제일 수 있다.
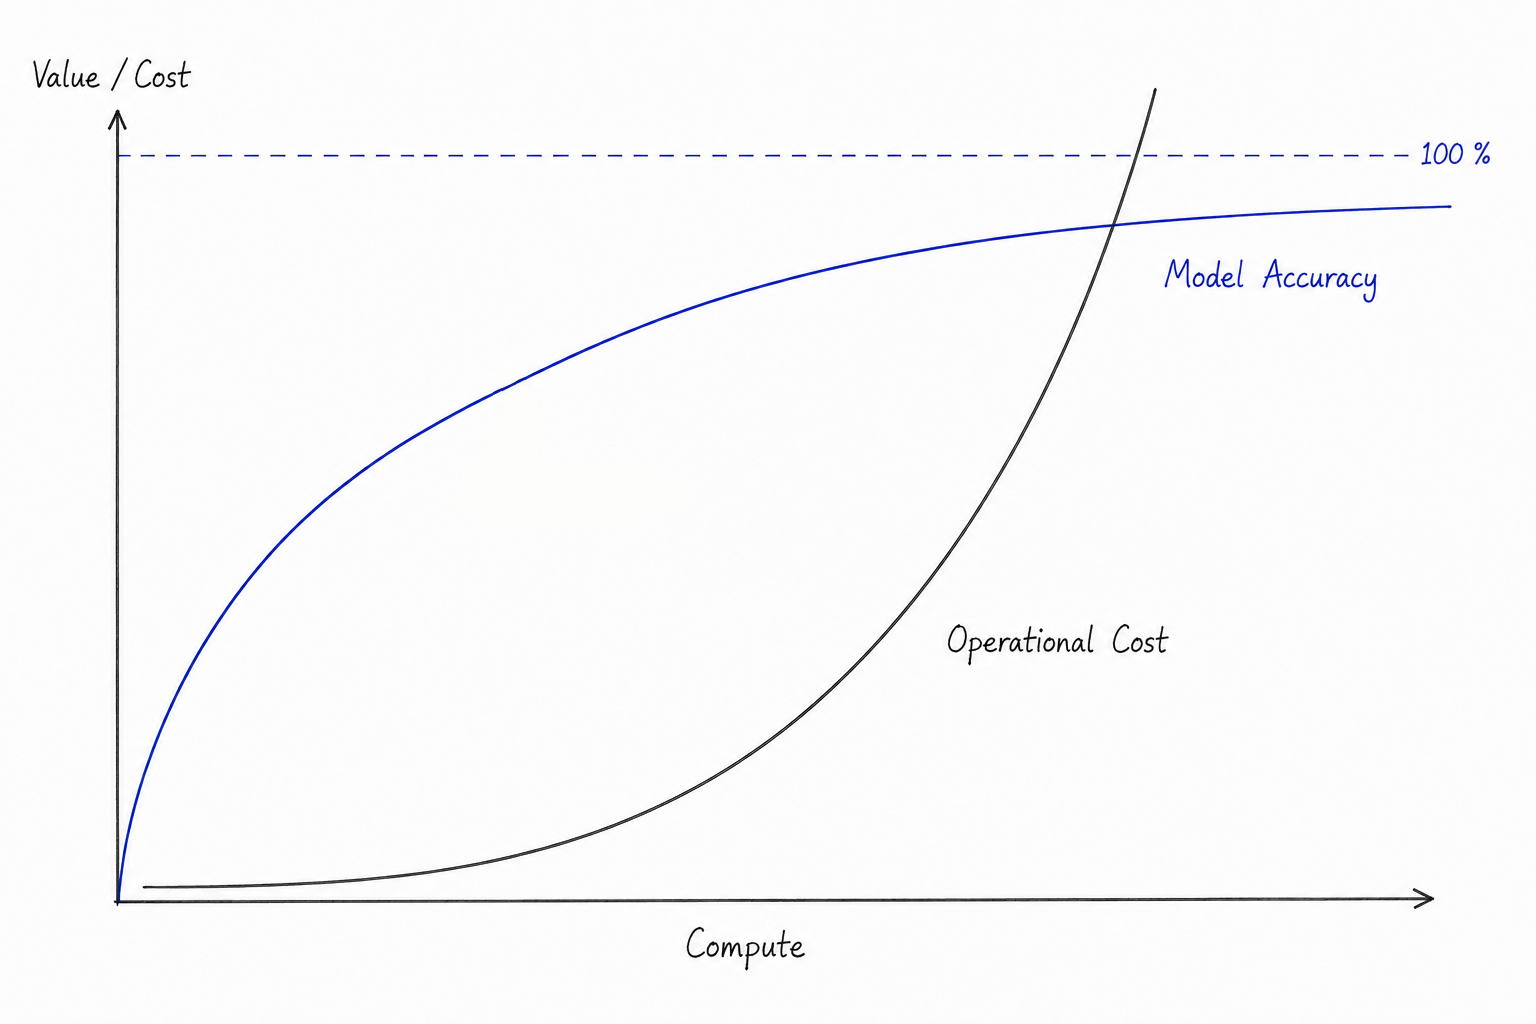
그림 1: “지능으로 해결하기”의 효율성 함정. 근본 제약이 누락된 상태에서는 추론을 더 늘려도 신뢰성 개선은 체감한다.
## 신뢰의 아키텍처
대규모 언어 모델은 구조적으로 국소 최적화, 전제 수용, 의미적 평활화에 묶여 있다. 따라서 폐쇄형 워크플로에서 자신의 실행 경계를 스스로 통제하도록 신뢰할 수 없다. 엔지니어링의 과제는 모델을 더 똑똑하게 만들려는 시도에서 벗어나, 모델 출력을 권한 없는 주장으로 취급하는 결정론적 시스템 계층을 구축하는 것으로 바뀐다.
운영 환경에서 기업들은 에이전트형 AI의 진짜 비용이 “신뢰 세금(trust tax)”임을 빠르게 깨닫고 있다. 자율성을 받아들일 만하게 만들기 위해 필요한 방대한 임시 모니터링과 가드레일 계층이 바로 그것이다. 안전이 지능보다 더 비싸졌다.
불완전한 모델을 경제적으로 쓸 수 있게 하려면 에이전트 주변에 결정론적 “에어록(airlock)”이 필요하다. 아키텍처 요구사항은 단순하다. 확률적 추론, 즉 *사용자 공간(user space)*과 결정론적 실행, 즉 *커널 공간(kernel space)*을 분리해야 한다. 그 분리가 마이크로커널, 워크플로 엔진, 정책 플랫폼, 오케스트레이션 프레임워크 중 무엇으로 구현되는지는 부차적이다.
에어록은 **컨텍스트 무결성(context integrity)**을 제어하는 데서 시작한다. 에이전트가 컨텍스트 세금을 부풀리는 무한 검색 루프를 헤매게 두는 대신, 런타임은 프롬프트에 결정론적으로 필요한 상태만 주입한다. 컨텍스트가 안정화되면 나머지 불변 조건은 **결정론적 실행 런타임(deterministic execution runtime)**을 통해 강제된다. 이 런타임은 세 가지 뚜렷한 거버넌스 계층으로 설계된다.

그림 2: 신뢰의 아키텍처. 결정론적 에어록은 모델 추론과 실행 권한을 분리한다.
### 구문 거버넌스와 권한 격리
첫 번째 방어선은 순전히 구조적이다. 에이전트가 어떤 동작이든 실행하도록 허용되기 전에, 엄격한 기계 판독 가능 책임 계약을 기준으로 구조화된 *정책 제안(policy proposal)*을 제출해야 한다. 보통 이 계약은 YAML과 파이댄틱(Pydantic)으로 정의된다.
물론 이는 초기 엔지니어링 부담을 만든다. 계약을 설계해야 하고, 검증 로직을 유지해야 하며, 실행 경계를 명시적으로 모델링해야 한다. 하지만 이것들은 고정되고 테스트 가능한 산출물이지 반복되는 프롬프트 부채가 아니다. 이 방식은 무제한의 확률적 운영 비용을 감사 가능한 엔지니어링 비용으로 전환한다. 또한 모델 업그레이드가 있어도 또 한 번의 재조정 사이클을 통해 다시 발견할 필요 없이 살아남는다.
이 검증은 결정론적 커널 공간에서 일어난다. 구조적 경계 위반을 거부하는 추론 비용은 정확히 0토큰이다. 에이전트가 권한 없는 API를 호출하려 하거나, 엄격한 재무 한도를 초과하거나, 잘못된 형식의 JSON을 반환하면 런타임은 즉시 해당 동작을 거부한다. 우리는 에이전트가 행동하도록 허용되어야 *하는지(should)* 증명하는 데 토큰을 쓰지 않는다. 권한은 추론을 반복 구매해서가 아니라 코드로 검증한다. 이것이 에이전트에 대한 제로 트러스트의 경제적 결과다.
하지만 제안이 이 결정론적 관문을 통과하지 못하면, 제약 없는 에이전트는 보통 당황해 무한한 “다시 시도” 루프에 들어간다. 토큰 예산을 조용히 소모하는 환각 사이클이다. *예산 폭주 문제(budget runaway problem)*를 막기 위해 아키텍처는 **의도 재시도 거버너(intent retry governor)**를 도입한다. 에이전트가 엄격한 한도, 예를 들어 세 번의 시도 안에 준수 가능한 정책을 만들지 못하면 런타임은 강제로 컴퓨팅 예산을 끊고 흐름을 중단된 `REASONING_EXHAUSTION` 상태로 전환한다. 재무적 출혈은 즉시 멈춘다.
엄격한 계약과 재시도 한도는 운영상 혼란을 막는다. 하지만 시스템은 훨씬 더 교묘한 위협에 노출된 채로 남는다.
### 의미 거버넌스와 증거 검증
에이전트가 스키마를 완벽히 지키고, 모든 재무 한도를 준수하며, 흠잡을 데 없는 JSON을 포함하지만 의도 면에서는 완전히 틀린 출력을 생성하면 어떻게 될까?
고객이 이렇게 썼다고 해 보자. “제 구독을 즉시 취소해 주세요. 더 이상 귀사의 서비스를 이용하고 싶지 않습니다.” 이탈 감소에 강하게 최적화된, 어쩌면 과도하게 프롬프트된 에이전트는 이메일을 처리하고 다음을 제안한다. `{"action": "APPLY_DISCOUNT", "discount_pct": 15, "cancel_subscription": false}`. 구조적으로 출력은 완벽히 유효하다. API 게이트웨이를 오류 하나 없이 통과한다. 할인액도 전역 15달러 한도 안에 있다. 우리는 이것을 **순응적 거짓말(compliant lie)**이라고 부른다. 에이전트는 완전히 합리적인 일을 했고 KPI, 즉 유지율을 최적화했다. 그러면서 사용자의 명시적 명령, 즉 취소는 완전히 무시했다.
순응적 거짓말을 잡아내려면 구문 검사에 의존할 수 없다. 비싼 LLM-심판(LLM-as-a-judge) 루프에 기대서도 안 된다. 대신 *증거 거버넌스 계층(evidence governance layer)*을 구현해야 한다. 이 계층은 실행 전에 모든 제안 동작이 독립적인 증거 검사를 통과하도록 요구한다. 검증 패턴은 다양한 유형의 드리프트에 맞게 조정된다.
- **차등 휴리스틱(differential heuristics) `사실 검증(fact validation)`:** 객관적 사실 위반을 잡기 위해 확률적 LLM 추론을 기존의 결정론적 규칙에 묶는다. 화가 난 고객이 취소를 요구했는데 에이전트가 그를 붙잡으려고 50% 할인을 제안한다고 해 보자. JSON은 구조적으로 올바르다. 하지만 기존의 저렴한 SQL 뷰에는 진실의 기준이 들어 있다. `customer_tier = BASIC, max_retention_discount = 15`. LLM이 50%를 제안하면 SQL 쿼리는 즉시 위반을 감지하고 시스템을 중단한다.
```
# 의미 거버넌스: 추가 LLM 비용 없이 사실 드리프트를 잡아낸다
def verify_tier_limits(customer_id: str, policy_proposal: dict) -> None:
# 구문은 유효하지만 사실이 위반됐다.
proposed_discount = float(policy_proposal["discount_pct"])
max_allowed_discount = extract_max_discount_from_db(customer_id)
if proposed_discount > max_allowed_discount:
raise CompliantLieDetected(
"사실 위반: 제안된 할인율이 고객의 정책 한도를 초과했습니다."
)
```
- **증거 기반 검증:** 그렇다면 에이전트가 15% 할인을 제안하면 어떨까? JSON은 유효하고 사실도 위반하지 않는다. 여기서 의미 거버넌스는 에이전트가 “옳다”고 증명하려 하지 않는다. 대신 제안된 동작이 독립적으로 관찰 가능한 신호와 모순된다는 증거를 찾는다. 고객이 명시적으로 “제 구독을 취소해 주세요”라고 썼다면 독립 분류기가 요청을 `CANCEL_SUBSCRIPTION`으로 분류할 수 있다. 이 분류기는 기존 정규식 패턴일 수도 있고, 빠른 전통적 ML 모델일 수도 있으며, 라우팅 휴리스틱일 수도 있다. 이것이 진실을 확정하지는 않는다. 하지만 제안된 동작과 비교할 수 있는 증거 신호를 제공한다. LLM이 `APPLY_DISCOUNT`를 제안하면 런타임은 증거 충돌을 감지한다.
같은 논리는 신원에 치명적인 작업에도 적용된다. 새로 제공된 주소로 전송된 인증 코드는 그 주소에 대한 제어권을 확인한다. 대상 계정의 소유권에 대해서는 아무것도 말해주지 않는다. 증거 거버넌스 계층은 제안된 자격 증명 재설정이나 이메일 연결 작업을 실행 권한을 부여하기 전에 계정 기록과 대조한다. 제공된 주소가 파일에 등록된 주소와 다르면, 이 충돌은 취소 사례와 구조적으로 동일하다. 국소적으로 유효한 동작이 독립적으로 관찰 가능한 상태와 모순되는 것이다.
런타임이 무엇을 하지 않는지에 주목하라. 고객을 유지하는 것이 경제적으로 이로운지 판단하려 하지 않는다. 모델보다 더 잘 추론하려고 비싼 다중 에이전트 토론을 실행하지도 않는다. 그저 이렇게 묻는다. *제안된 동작이 모델 밖에 이미 존재하는 증거와 모순되는가?*
```
# 의미 거버넌스: 거의 추가 비용 없이 증거 충돌을 잡아낸다
def validate_subscription_decision(customer_email: str, proposed_policy: dict) -> None:
# intent_classifier는 간단한 정규식이나 경량 ML 모델일 수 있다
cancellation_detected = intent_classifier(customer_email) == "CANCEL_SUBSCRIPTION"
retention_action = proposed_policy["action"] == "APPLY_DISCOUNT"
if cancellation_detected and retention_action:
raise CompliantLieDetected(
"증거 충돌: 결정이 독립 분류기 신호와 모순됩니다."
)
```
- **양방향 재구성(bidirectional reconstruction), 즉 결정 가역성:** 명시적 증거 검증은 “취소”처럼 분명한 의도에는 완벽하게 들어맞는다. 하지만 요청이 모호하거나, 여러 목표를 갖고 있거나, 맥락 의존성이 높다면 어떻게 해야 할까? 고객이 이렇게 썼다고 해 보자. “우리 팀 전체를 다른 벤더로 옮기는 것을 검토 중입니다. 지원은 실망스러웠고 가격도 더 이상 납득되지 않습니다.” 여기에는 단일한 `INTENT_CANCEL` 트리거가 없다. 에이전트가 `{"action": "OFFER_ENTERPRISE_DISCOUNT", "discount_pct": 20}`를 제안하면, 우리는 JSON 출력만 작고 저렴한 에이전트 B에 전달한다.
양방향 재구성은 이렇게 묻는다. *출력이 자신을 진실하게 설명할 수 있는가?*
에이전트 B가 JSON만 보고 *“고객은 가격에 불만이 있으며 유지 할인을 제안받고 있다”*고 재구성하면, 런타임은 그 재구성된 서사를 추가 증거 신호로 취급한다. 그리고 재구성된 의도와 원래 맥락 사이의 간극이 자율 실행을 정당화하기에는 너무 불확실해질 때마다 에스컬레이션한다. 정확한 비교 메커니즘은 구현에 따라 다르며, 임베딩 유사도부터 도메인 특화 휴리스틱까지 다양할 수 있다. 원래 이메일은 팀 전체의 심각한 이탈 가능성을 설명했기 때문에, 재구성된 서사는 입력을 설명하는 데 실패한다. 시스템은 “진실”을 안다고 주장하지 않는다. 그저 컨텍스트 손실, 우리가 *압축 드리프트(compression drift)*라고 부르는 현상을 감지하고, 그로 인한 불확실성 때문에 중단한다.
물론 텍스트 의도를 프로그램적으로 비교하면 그 자체로 모호성의 층이 생기며, 또 다른 LLM-심판에 의존하게 될 위험이 있다. 따라서 양방향 재구성은 엔지니어링상의 절충이다. 엄격한 SQL 한도나 단순한 ML 분류기가 결정적으로 적용될 수 없는 매우 모호한 워크플로에서는 더 높은 비율의 거짓 양성 에스컬레이션을 받아들인다. 이는 의도적인 선택이다. 거짓 양성 에스컬레이션은 비용이 제한되고 예측 가능하지만, 근거 없는 자율 동작은 제한 없는 비즈니스 결과를 만들 수 있다. 우리는 컨텍스트와 JSON 사이의 증거 연결이 조금이라도 흐릿하면 반드시 에스컬레이션하도록 시스템을 조정한다. 앞서 논의한 순응성 함정을 막기 위해 이 에이전트들은 엄격히 에어갭된다. 에이전트 B는 에이전트 A의 작업을 확인하는 격리된 단방향 증거 분류기로만 동작한다. 둘은 대화하거나 합의를 협상할 수 없다.
조직이 차등 휴리스틱, 기존 ML 의도 분류기, 양방향 재구성 중 무엇을 쓰는지는 결국 구현 선택의 문제다. 핵심 아키텍처 원칙은 변하지 않는다. 에이전트가 설득력 있어 보인다는 이유로 실행 권한을 부여해서는 안 된다. 권한은 제안된 동작이 에이전트 자신의 추론 과정과 독립적으로 존재하는 증거에 의해 뒷받침될 때에만 부여된다.
의미 거버넌스의 목적은 에이전트를 결정론적 규칙으로 대체하는 것이 아니다. 결정론적 규칙이 안정적으로 결정을 내릴 수 있다면 애초에 에이전트가 그 결정을 내려서는 안 된다. 대신 런타임은 비즈니스의 이해된 불변 조건에 결정론적 검증을 남겨두고, 모호성 아래의 추론은 에이전트가 맡도록 한다. 증거 검증의 역할은 추론을 대체하는 것이 아니라 권한을 부여하기 전에 추론에 이의를 제기하는 것이다. 결정론적 시스템은 확실성을 처리하고, 에이전트는 모호성을 처리한다. 아키텍처상의 실수는 둘 중 어느 한쪽에 두 가지를 모두 요구하는 것이다.
### 시간 거버넌스와 에이전트 드리프트
단일 트랜잭션 오류를 잡아내면 즉각적인 실행 문제는 해결된다. 하지만 배포가 성숙해지면 조직은 교묘한 “사흘째(day three)” 문제, 즉 **에이전트 드리프트(agent drift)**에 직면한다.
모든 개별 결정이 구문적으로 유효하고 의미적으로도 참이지만, 에이전트의 집계 행동이 시간이 지나며 비즈니스 마진을 갉아먹기 시작하면 어떻게 될까? 고객 유지 에이전트가 허용된 최대 15% 할인을 꾸준히 제공해 고객 이탈을 성공적으로 막는 방법을 배웠다고 상상해 보자. 에이전트는 기술적으로 모든 규칙을 준수한다. 하지만 천 번의 상호작용에 걸쳐 회사의 수익성을 조용히 파괴한다.
*결정 텔레메트리(decision telemetry)*, 특히 모든 상호작용에 고유한 결정 흐름 ID(DFID)를 붙이는 방식을 활용하면 불투명한 AI 대화를 구조화된 관계형 데이터베이스 행으로 바꿀 수 있다. 모든 결정, 컨텍스트 스냅샷, 결과가 DFID로 영구 연결되기 때문에, 롤링 윈도 데이터에 대해 비동기 사후 실행 모니터를 실행할 수 있다.
고객 유지와 자율 청구에서 실용적인 “사흘째” 모니터는 SQL만으로도 충분히 단순할 수 있다.
```
-- 에이전트가 계속 최대 할인을 적용하면 서킷 브레이커를 트리거한다
SELECT agent_id
, AVG(CAST(params->>'discount_pct' AS DECIMAL)) AS rolling_avg_discount
, COUNT(dfid) AS total_decisions
FROM execution_log
WHERE executed_at >= CURRENT_TIMESTAMP - INTERVAL '7 days'
AND status = 'SUCCESS'
GROUP BY agent_id
HAVING AVG(CAST(params->>'discount_pct' AS DECIMAL)) > 14.5;
-- 하드 한도가 15.0이라고 가정한다
```
집계 모니터가 에이전트의 평균 할인율이 위험할 만큼 높아지는 것을 감지하면 **서킷 브레이커(circuit breaker)**를 작동시킨다. 시스템은 즉시 레지스트리에서 에이전트의 권한을 정지하고, 사람이 개입할 때까지 컴퓨팅 예산과 실행 권한을 차단한다.
이것이 시간 거버넌스다. 구문, 의미, 시간 방어를 결합하면 패러다임은 완전히 바뀐다. 더 이상 모델이 완벽하기를 기도하지 않아도 된다. 모델의 불완전성은 시스템적 손실이 되기 전에 구조적으로 봉쇄된다.
## 재무 슬라이더로서의 정확도
결정론적 에어록이 컨텍스트, 권한, 증거, 시간을 강제하면 파국적 실패의 위험은 급격히 낮아진다. 이제 기반 대규모 언어 모델이 완벽할 필요는 없다. 그 불완전성이 얼마의 비용을 만드는지만 알면 된다. 이 시점에서 모델 지능, 즉 의도는 운영 안전의 문제가 아니라 순수한 경제 변수로 바뀐다.
### 예외에 의한 거버넌스
제안이 구문 또는 의미 관문을 통과하지 못할 때, 우리는 모델을 맹목적으로 반복 실행하지 않는다. 결정론적 관문이 존재하면 실패한 결정은 더 이상 맹목적 재시도를 요구하지 않는다. 그것은 경계가 정해진 예외가 된다.
에스컬레이션은 아키텍처의 실패 모드가 아니다. 예측 가능한 비용 구성요소다. 의미 에어록의 거짓 양성 에스컬레이션을 의도적으로 받아들임으로써 우리는 무제한의 비즈니스 리스크를 제한된 운영 비용과 교환한다.
조직마다 예외 처리 방식은 다를 수 있다. 어떤 조직은 사람 운영자에게 바로 에스컬레이션할 수 있다. 다른 조직은 실패를 점진적으로 더 성능 좋은 모델로 라우팅한 뒤 에스컬레이션할 수 있다. “[프루걸GPT: 비용을 줄이고 성능을 개선하면서 대규모 언어 모델을 사용하는 방법(FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance)](https://arxiv.org/abs/2305.05176)” 같은 연구는 모델 캐스케이드가 품질을 유지하면서 추론 비용을 크게 줄일 수 있음을 보여준다. 이는 이 더 넓은 원칙을 구현하는 한 가지 방법이 될 수 있다.
하지만 아키텍처상의 통찰은 특정 라우팅 전략과 무관하다. 결정론적 거버넌스는 재시도를 명시적 예외로 바꾼다. 그래서 조직은 다음 단계로 추가 컴퓨팅, 추가 컨텍스트, 사람 개입 중 무엇이 가장 경제적인지 결정할 수 있다. 시스템은 *예외에 의한 거버넌스(governance by exception)*로 운영된다. 사람 운영자와 비싼 프리미엄 모델은 일상적인 트랜잭션을 검토하지 않는다. 기준 기계가 자신의 근거를 수학적으로 또는 의미적으로 증명할 수 없는 진짜 이상 징후만 검토한다.
### 비용 변동성 제한하기
실행 인프라가 안정화되면 초점은 중요한 운영 과제, 즉 비용 변동성으로 이동한다.
전통적인 소프트웨어에서는 실행 비용을 예측할 수 있다. 확률 기반 시스템에서는 완전히 같은 작업도 월요일에는 500토큰을 소비하고 화요일에는 1만 5천 토큰을 소비할 수 있다. 에이전트가 경계 사례를 해결하려고 긴 추론 루프에 빠지면 그렇게 된다. 기업 배포에서 이런 예측 불가능한 변동성은 추론의 기본 비용보다 더 심각한 장애물이 되는 경우가 많다.
결정 흐름마다 엄격한 계산 예산을 강제하고 의도 재시도 거버너를 활용하면, 아키텍처는 이 변동성에 단단한 상한을 둔다. 에이전트가 준수 가능한 정책을 만들지 못한 채 재시도 한도에 도달하면 런타임은 프로세스를 중단하고 안전하게 에스컬레이션한다. 이것이 AI 운영 비용을 완전히 고정적으로 만들지는 않는다. 하지만 재무 노출을 구조적으로 제한하여 단일 트랜잭션 처리에 드는 컴퓨팅 비용이 정의된 한도를 넘지 않도록 보장한다.
### 재무 슬라이더 방정식
안전은 런타임이 보장하고 비용 변동성은 인프라가 제한하면, 에이전트형 AI의 경제성은 하나의 공식으로 압축된다.
> *총 결정 비용(Total Decision Cost) = 컴퓨팅 비용(Compute Cost) + (에스컬레이션 비율(Escalation Rate) × 사람 비용(Human Cost))*
이 방정식은 최적화 문제를 근본적으로 바꾼다. 전통적인 에이전트 아키텍처는 모델 능력을 안전의 전제조건으로 취급한다. 거버넌스를 외부화하면 능력은 주로 에스컬레이션 빈도에 영향을 미친다. 질문은 더 이상 “어떤 모델이 안전할 만큼 지능적인가?”가 아니다. “어떤 모델 비용과 에스컬레이션 비율의 조합이 총 결정 비용을 최소화하는가?”가 된다.
| **변수(Variable)** | **시나리오 A: 컴퓨팅 최적화(Scenario A: optimize for compute)** | **시나리오 B: 자동화 최적화(Scenario B: optimize for automation)** |
| --- | --- | --- |
| **모델 능력(Model capability)** | 낮음. 양자화 또는 오픈소스 모델 | 높음. 대표 추론 모델 |
| **컴퓨팅 비용(Compute cost)** | 거의 0 | 급등. 높은 프리미엄 |
| **안전 경계 트리거(Safety boundary triggers)** | 빈번함 | 드묾 |
| **에스컬레이션 비율(Escalation rate)** | 높음 | 낮음 |
| **재무적 절충(Financial trade-off)** | API 비용은 아끼지만, 이상 징후를 검토할 사람 운영자 비용을 낸다. | 인건비는 아끼지만, 클라우드 벤더에 프리미엄을 지불한다. |
| **안전 결과(Safety result)** | 구조적으로 제한됨 | 구조적으로 제한됨 |
두 시나리오 모두 시스템은 결정론적으로 규정을 준수한다. 선택은 순전히 단위 경제성의 문제다.
더 똑똑한 모델은 사용 가능한 증거를 더 잘 활용해 에스컬레이션을 줄일 수 있다. 하지만 진짜 비즈니스 모호성에서 비롯되는 에스컬레이션은 어떤 모델도 제거할 수 없다. 1,000억 달러짜리 추론 모델도 자신이 갖고 있지 않은 컨텍스트를 만들어낼 수는 없다.
안전을 지능에서 분리하면 더 이상 완벽한 정확도 추구에 인질로 잡히지 않는다. 지능은 조정 가능한 경제 변수가 되고, 그제야 에이전트형 AI는 기업에서 실현 가능해진다.
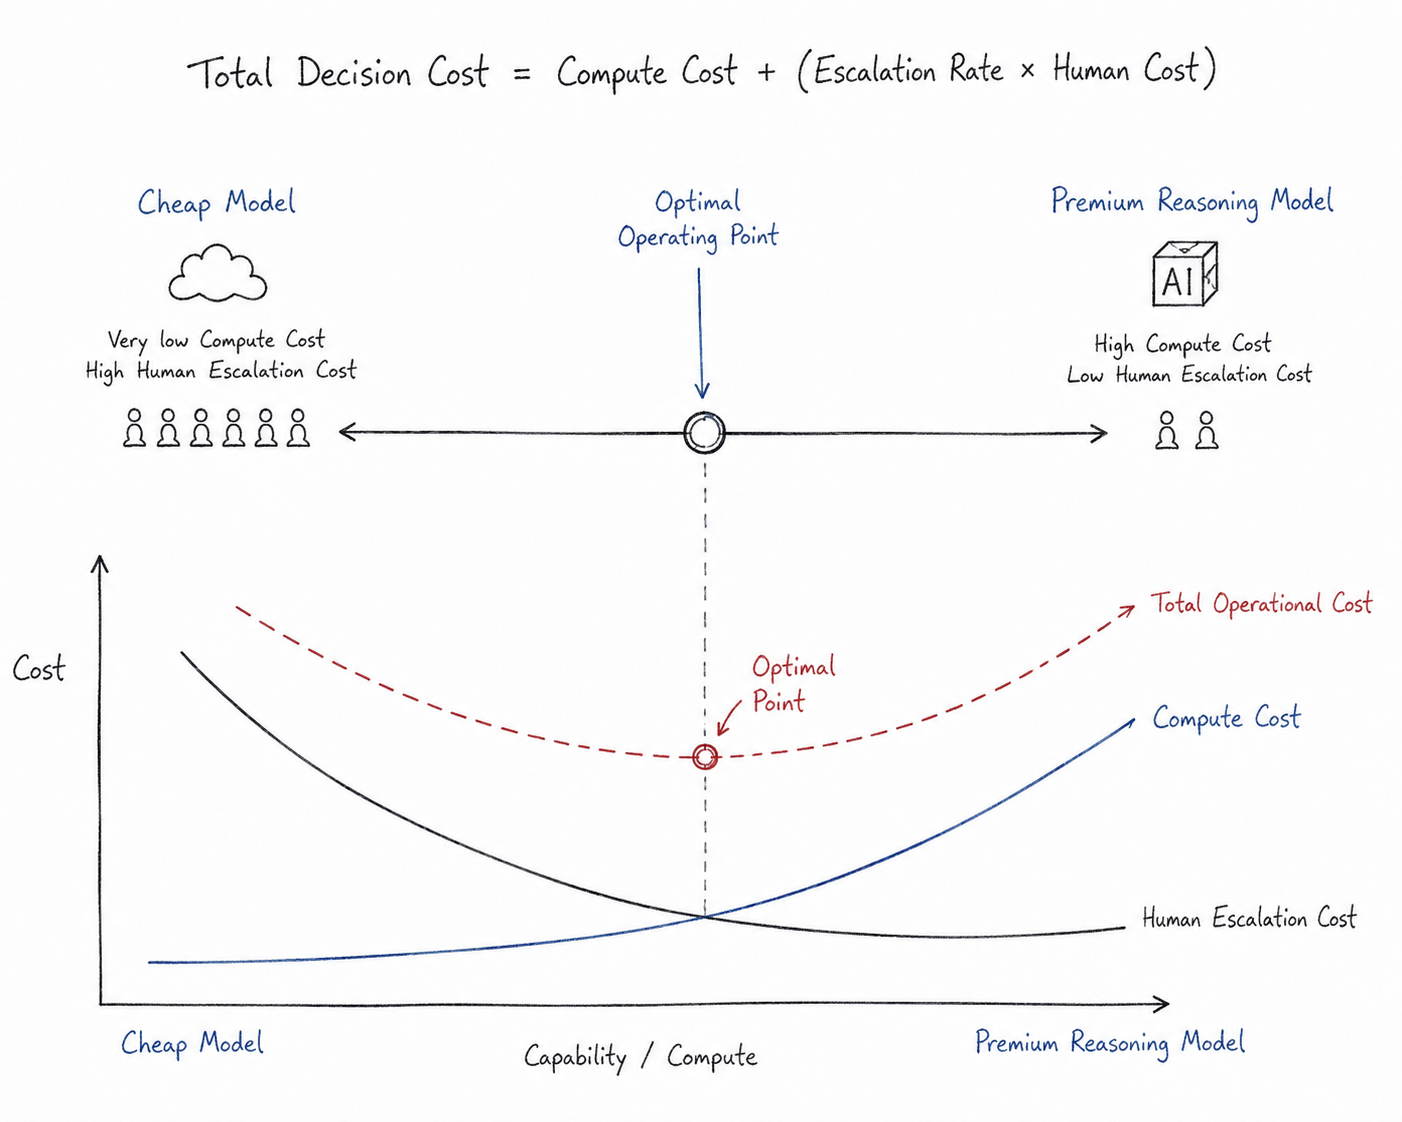
그림 3: 재무 슬라이더로서의 정확도. 최적 모델은 컴퓨팅 비용과 에스컬레이션 비용 사이에서 균형을 잡는다.
## 불완전성을 전제로 한 엔지니어링
이 시스템들을 고립된 파일럿에서 기업급 운영으로 확장할수록 냉정한 현실이 뚜렷해진다. 에이전트형 AI에서 가장 큰 위험은 더 이상 환각이 아니다. 여전히 진전하고 있다고 믿는 시스템이 무제한으로 돈을 쓰는 것이다.
자율 시스템을 중대한 운영 환경에 안전하게 배포하기 위해 더 똑똑하고 무한히 확장되는 모델이 필요한 것은 아니다. 필요한 것은 기반 모델이 언젠가는 실패하고, 드리프트하며, 거짓말할 것이라고 근본적으로 가정하는 더 똑똑한 시스템이다.
토목 엔지니어가 현수교를 어떻게 짓는지 생각해 보자. 그들은 절대 휘지 않고, 녹슬지 않으며, 피로가 쌓이지 않는 “완벽한 강철”을 찾느라 수십 년을 보내지 않는다. 재료가 본질적으로 결함을 갖고 있으며 엔트로피 법칙의 지배를 받는다는 사실을 받아들인다. 이를 보완하기 위해 중복성을 만든다. 오차 범위를 계산한다. 재료가 얼마나 많은 응력을 흡수할 수 있는지, 그리고 그 한계를 넘기 전에 구조물이 어떻게 안전하게 하중을 재분배할지 정확히 규정하는 단단한 물리적 하중 지지 프레임워크를 구축한다.

그림 4. 불완전성을 전제로 한 엔지니어링은 알려진 재료 한계를 중심으로 설계하는 것이다.
소프트웨어 업계는 지난 3년 동안 완벽한 강철을 찾아다녔다. 환각을 절대 일으키지 않는 확률적 모델을 단련하겠다는 희망으로, 거대한 평가 스위트, 프롬프트 엔지니어링의 연금술, 끝없이 확장되는 컨텍스트 창에 수십억 달러를 쏟아부었다. 그것은 신기루다.
AI 시대의 엔지니어링 성숙도는 기계 추론에서 모든 불완전성을 제거한다는 뜻이 아니다. 모델의 불완전성이 더 이상 운영상 책임이 되지 않을 만큼 단단하고, 결정론적이며, 회복력 있는 아키텍처를 설계한다는 뜻이다.
에이전트형 AI의 미래는 가장 똑똑한 모델을 가진 조직이 차지하지 않을 가능성이 크다. 지능과 권한을 가장 효과적으로 분리하는 조직이 차지할 것이다. 추론과 실행이 분리되면 지능은 조정 가능한 경제 매개변수가 된다. 안전은 인프라가 된다. 그리고 완벽한 모델 정확도를 향한 끝없는 추구는 마침내 비즈니스 요구사항이 아니게 된다.
그 추구의 끝은 AI의 끝이 아니다. AI가 마침내 엔지니어링이 되는 순간이다.
*참고(Note): 여기서 설명한 런타임은 참조 아키텍처이지 특정 구현 기술이 아니다. 같은 원칙은 워크플로 엔진, 정책 플랫폼, 오케스트레이션 프레임워크, 맞춤형 인프라를 통해 구현할 수 있다. 이러한 개념의 샘플 구현은 [깃허브 저장소](https://github.com/huka81/decision-intelligence-runtime)에서 확인할 수 있다.*