Metadata
# 보상 모델
[](https://substackcdn.com/image/fetch/$s_!D_ya!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fa99610ef-e0a2-4eba-b3d5-8326f75b0cb0_1988x1114.png)
([1, 2, 4, 14]에서 발췌)
보상 모델(reward model, RM)은 대규모 언어 모델(large language model, LLM) 연구의 핵심 요소다. 인간의 선호를 훈련 과정에 반영함으로써 상당한 발전을 가능하게 한다. 이처럼 중요한 역할을 하는데도 RM은 흔히 간과된다. 효과적인 훈련 및 활용 방법을 다룬 실용적인 지침도 여전히 부족하다. _특히 검증 가능한 보상을 활용하는 강화 학습처럼 RM이 필요 없는 기법이 인기를 얻으면서 이러한 경향이 두드러지고 있다._ 그럼에도 [PPO 기반 강화 학습](https://rlhfbook.com/c/11-policy-gradients.html)으로 LLM을 훈련하는 일은 최고 수준의 기반 모델을 개발하는 데 여전히 중요한 요소다. 이 글에서는 RM을 기초부터 깊이 있게 이해한다. 또한 빠르게 변화하는 LLM 생태계에서 RM이 역사적으로 어떤 의미가 있었고 지금도 왜 중요한지 살펴본다.
[](https://substackcdn.com/image/fetch/$s_!UkPk!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F94ec9186-9bf4-4b06-a6b7-7eb119b91e1a_2020x650.png)
> _“보상 모델은 환경 보상을 대신하는 수단으로 강화 학습 연구 전반에서 널리 사용돼 왔다. … 가장 일반적인 보상 모델은 훈련용 비교 데이터에서 특정 텍스트가 선호되는 텍스트에 가까울 확률을 예측한다.”_ - [RLHF 책](https://rlhfbook.com/c/07-reward-models.html)
보상 모델(RM)은 특수한 LLM이다. _대개 현재 훈련 중인 LLM에서 파생한다._ 프롬프트와 후보 완성문을 입력으로 받아 인간의 선호 점수를 예측하도록 훈련한다. 위 그림을 참고하라. RM이 부여한 점수가 높을수록 해당 완성문을 인간이 선호할 가능성이 크다는 의미다.
먼저 보상 모델(RM)의 기본 원리와 생성 방법, LLM 맥락에서의 활용 방식을 이해해야 한다. 이 절에서는 다음 내용을 중점적으로 살펴본다.
* 선호에 관한 통계 모델에서 도출되는 RM의 필요성
* 대부분의 RM이 사용하는 아키텍처와 구조
* RM 훈련 과정
RM의 활용법을 이해하려면 강화 학습(reinforcement learning, RL)과 LLM 사후 훈련에 관한 배경지식이 더 필요하다. 이는 다음 절에서 다룬다.
RM의 표준 구현은 [브래들리-테리 선호 모델(Bradley-Terry model of preference)](https://en.wikipedia.org/wiki/Bradley%E2%80%93Terry_model)에서 유래한다. _쌍을 이루는 항목의 상대적인 강도나 성과를 바탕으로 쌍대 비교 데이터를 순위화하는 통계 모델이다._ 동일한 분포에서 추출한 두 사건 `i`와 `j`가 있다고 하자. 브래들리-테리 모델은 항목 `j`보다 항목 `i`가 이길, _즉 선호될_ 확률을 다음과 같이 정의한다.
[](https://substackcdn.com/image/fetch/$s_!zgW4!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F8bb1622e-98a9-4e69-9220-433c8085cd93_884x612.png)
브래들리-테리 모델의 쌍대 비교 확률
LLM의 맥락에서 항목 `i`와 `j`는 동일한 LLM이 같은 프롬프트를 바탕으로 생성한 두 완성문이다. 즉, 같은 분포에서 표본으로 추출한 완성문이다. RM은 각 완성문에 점수를 부여한다. 그런 다음 위에 제시한 브래들리-테리 모델의 식을 이용해 완성문 `j`보다 완성문 `i`가 선호될 확률을 구한다. 간단히 말해, _브래들리-테리 모델을 사용해 두 완성문의 쌍대 비교 확률을 표현한다._
[](https://substackcdn.com/image/fetch/$s_!rKGp!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F609d472d-1a82-4fd4-8c25-fe4e7253ee13_610x1118.png)
([14]에서 발췌)
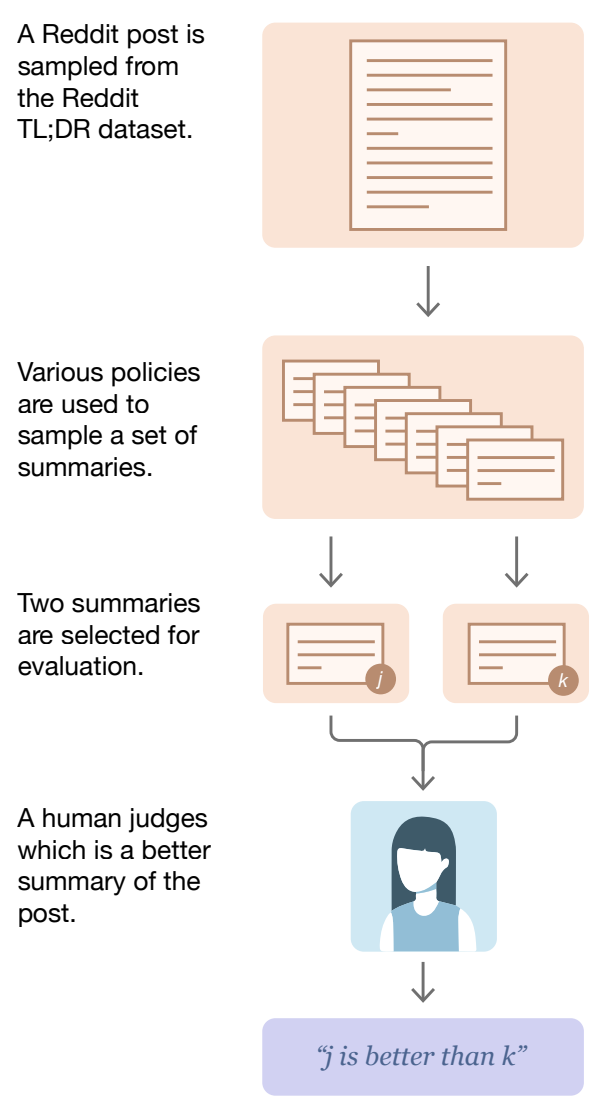
**선호 데이터(Preference data).** 쌍대 선호 데이터는 LLM 사후 훈련에서 광범위하게 쓰이며, _이미 상당히 오랫동안 사용돼 왔다[14]._ 이러한 데이터는 다양한 프롬프트로 구성된다. 데이터에 포함되는 프롬프트의 다양성을 최대화하는 것이 목표다. 프롬프트 분포는 실제 환경에서 모델이 접할 프롬프트를 대표해야 한다. 각 프롬프트에는 후보 완성문 한 쌍이 있다[1](https://cameronrwolfe.substack.com/p/reward-models#footnote-1). 이 가운데 하나가 다른 하나보다 더 낫다고 판정된다. _대개 인간이 판정하지만 [모델이 판정할 때도 있다](https://cameronrwolfe.substack.com/p/rlaif-reinforcement-learning-from)._ 위 그림을 참고하라. 프롬프트와 그에 연결된 채택 및 기각 완성문으로 구성된 데이터셋을 인간 선호 데이터셋이라고 한다.
RM이 브래들리-테리 선호 모델을 기반으로 한다는 사실은 알았다. 하지만 이러한 통계 모델을 실제로 구현하는 방법은 다양하다. LLM 분야에서는 예상할 수 있듯이 LLM으로 이 모델을 구현한다. 다만 표준 생성형 [디코더 전용 LLM](https://cameronrwolfe.substack.com/p/decoder-only-transformers-the-workhorse)과 비교하면 RM은 기본 아키텍처와 훈련 목적 함수를 모두 수정한다.
[](https://substackcdn.com/image/fetch/$s_!M_zU!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F0757f3b6-d8a3-49da-80dc-74b9bcb9a1aa_1716x890.png)
RM 아키텍처 개략도
**RM 아키텍처(RM architecture).** RM은 LLM의 프롬프트-완성문 쌍을 입력으로 받아 스칼라 형태의 선호 점수를 출력한다. 실제로는 디코더 전용 아키텍처 끝에 선형 헤드를 추가해 LLM으로 RM을 구현한다. 위 그림을 참고하라. 구체적으로 LLM은 입력 토큰마다 하나씩 토큰 벡터 목록을 출력한다. 이 목록의 마지막 벡터를 선형 헤드에 통과시키면 스칼라 점수 하나가 나온다. _RM은 특정 완성문이 선호되는지 아닌지를 분류하는 추가 분류 헤드를 갖춘 LLM이라고 볼 수 있다._
**훈련 과정(Training process).** RM의 매개변수는 일반적으로 기존 정책[2](https://cameronrwolfe.substack.com/p/reward-models#footnote-2)으로 초기화한다. 여기서는 이를 RM의 “기반(base)” 모델이라고 부른다. RM을 초기화할 정책으로는 여러 대안이 있다. 현재 훈련 중인 LLM을 쓸 수도 있고, 사전 훈련 기반 모델이나 SFT 모델처럼 이전 버전을 선택할 수도 있다. RM을 초기화한 뒤 이 모델에 선형 헤드를 추가하고 [선호 데이터셋](https://rlhfbook.com/c/06-preference-data.html)으로 훈련한다. 이 데이터셋은 프롬프트에 대한 채택 및 기각 모델 응답 쌍으로 이루어진다.
[](https://substackcdn.com/image/fetch/$s_!RqTs!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fd836bca0-f804-4052-8b7f-4eb2b1e2356b_1392x530.png)
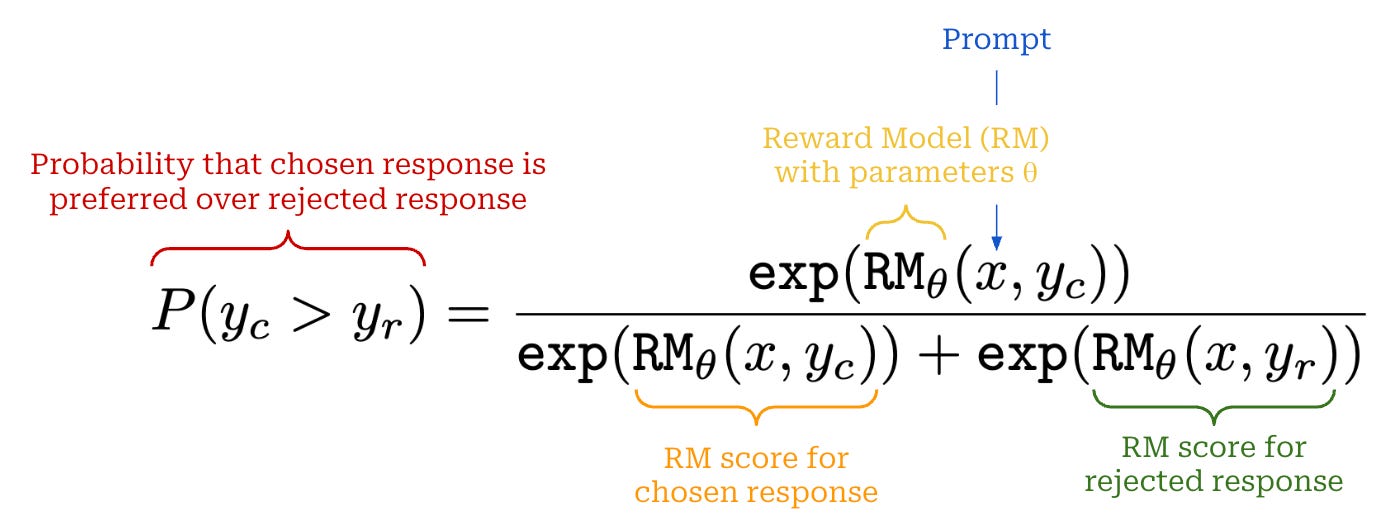
RM 출력으로 표현한 쌍대 확률
선호 응답 쌍이 주어졌을 때 RM은 기각 응답보다 채택 응답에 높은 점수를 부여해야 한다. 다시 말해 최적의 RM은 기각 응답보다 채택 응답이 선호될 확률을 최대화해야 한다. 앞서 살펴봤듯이 브래들리-테리 모델로 이 확률을 표현할 수 있다. 위 그림을 참고하라. 이 확률식을 재정리하면 아래의 손실 함수를 얻는다. 이는 모델이 채택 응답에 더 높은 점수를 부여하도록 유도하는 단순한 [쌍대 순위 손실(pairwise ranking loss)](https://gombru.github.io/2019/04/03/ranking_loss/)이다.
[](https://substackcdn.com/image/fetch/$s_!iPQn!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fc84db389-0e57-4a3c-808b-d48b28a192d6_1204x392.png)
RM의 표준 손실 함수
이는 브래들리-테리 모델이 음의 로그 가능도에 사용할 확률을 제공하는 [음의 로그 가능도(negative log likelihood, NLL) 손실](https://docs.pytorch.org/docs/stable/generated/torch.nn.NLLLoss.html)로 볼 수 있다. 아래에는 이 손실의 지형을 시각화했다. _채택 점수를 최대화하고 기각 점수를 최소화할 때 손실이 가장 작아진다._ 대규모 선호 데이터셋에서 이 손실 함수를 경험적으로 최소화하면 채택 응답이 기각 응답보다 선호될 기대 확률을 근사적으로 최대화할 수 있다.
[](https://substackcdn.com/image/fetch/$s_!qlGB!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F9004e549-5346-4e1b-8c00-faa76fa72bf6_1568x1288.png)
**보상 정규화(Normalizing the reward).** 훈련을 마친 RM은 정규화되지 않은 스칼라 값을 출력한다. 보상 함수의 분산을 낮추려면, 즉 RM 출력이 표준 범위에 들도록 하려면 RM 출력을 정규화하면 된다. 훈련에 사용한 선호 데이터셋에서 평균 보상이 0이 되도록 조정한다. [14]의 저자들도 이 보상 정규화 방식을 사용했다고 언급한다.
> _“훈련이 끝나면 데이터셋의 기준 요약문이 평균 점수 0을 얻도록 보상 모델 출력을 정규화한다.”_ - [14]에서 발췌
이제 논의를 좀 더 실용적인 방향으로 전환해 보자. 일반적인 딥러닝 프레임워크를 이용해 아키텍처와 손실 함수를 포함한 RM을 구현하는 방법을 살펴본다. RM은 단순한 분류 모델이다. 즉, _텍스트 시퀀스를 대상으로 [텍스트 분류(text classification)](https://huggingface.co/docs/transformers/en/tasks/sequence\_classification)를 수행한다._ RM은 프롬프트와 응답을 입력으로 받아 해당 프롬프트-응답 쌍이 선호될 가능성을 스칼라 점수 하나로 예측한다.
**간단한 예제(Toy example).** 허깅 페이스의 `AutoModelForSequenceClassification` 같은 추상화로 이를 구현할 수 있다. 로컬에서 실행할 수 있는 소형 [BERT](https://cameronrwolfe.substack.com/p/language-understanding-with-bert) 기반 RM 구현은 다음과 같다. 여기서는 다음 작업을 수행한다.
* `AutoModelForSequenceClassification`으로 RM을 생성한다.
* 모든 채택 및 기각 시퀀스[3](https://cameronrwolfe.substack.com/p/reward-models#footnote-3)에 대해 단일 로짓 형태의 RM 출력을 계산한다.
* 앞에서 설명한 방식으로 RM 손실을 계산한다.
```python
from transformers import (
AutoTokenizer,
AutoModelForSequenceClassification,
)
import torch
# 시퀀스 분류용 소형 모델 불러오기
model_name = "google-bert/bert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(
model_name,
trust_remote_code=True,
)
model = AutoModelForSequenceClassification.from_pretrained(
model_name,
trust_remote_code=True,
)
# 채택된 프롬프트-응답 시퀀스
chosen_seqs = [
"딥러닝 집중 탐구가 정말 좋아요!",
"캐머런은 설명을 정말 잘해요",
"AGI가 곧 등장할 거예요...",
]
# 기각된 프롬프트-응답 시퀀스
rejected_seqs = [
"딥러닝 집중 탐구는 별로예요",
"캐머런은 자기가 무슨 말을 하는지도 몰라요",
"AGI는 가짜고 LLM은 추론도 못 해요!",
]
# 채택 및 기각 시퀀스 토큰화
chosen_inps = tokenizer(
chosen_seqs,
return_tensors="pt",
padding=True,
)
rejected_inps = tokenizer(
rejected_seqs,
return_tensors="pt",
padding=True,
)
# RM 출력 계산
rewards_chosen = model(**chosen_inps).logits[:, 0]
rewards_rejected = model(**rejected_inps).logits[:, 0]
# RM 손실 계산
loss = -torch.nn.functional.logsigmoid(
rewards_chosen - rewards_rejected
).mean()
print(loss)
```
이후에는 [다른 모델과 비슷한 방식으로](https://docs.pytorch.org/tutorials/beginner/introyt/trainingyt.html) RM을 훈련한다. 즉, _i)_ 선호 데이터셋을 순회하고, _ii)_ 위에서 설명한 손실을 계산하며, _iii)_ [역전파(backpropagation)](https://www.youtube.com/watch?v=Ilg3gGewQ5U)로 기울기를 구하고, _iv)_ 기울기에 따라 매개변수를 갱신한 뒤, _v)_ 이 과정을 반복한다.
**실제 RM 훈련 예제(Real RM training example).** LLM 연구소에서 RM을 실제로 어떻게 훈련하는지 알아보려면 AI2의 [오픈인스트럭트(OpenInstruct)](https://github.com/allenai/open-instruct)에 포함된 [RM 훈련 스크립트](https://github.com/allenai/open-instruct/blob/main/open_instruct/reward_modeling.py)를 살펴보면 된다. 이 스크립트는 [액셀러레이트(accelerate)](https://huggingface.co/docs/accelerate/en/index)를 이용해 [OLMo-2](https://arxiv.org/abs/2501.00656) 또는 [OLMoE](https://arxiv.org/abs/2409.02060) 기반 RM의 분산 훈련을 구현한다. 스크립트는 상당히 단순하며, 코드 대부분은 훈련 과정의 설정에 쓰인다. 이 훈련 스크립트에서 핵심 RM 훈련 루프를 추려내면 다음과 같다.
```python
for _ in range(args.num_train_epochs):
for data in dataloader:
training_step += 1
# 채택 및 기각 시퀀스 연결
query_responses = torch.cat(
(
data[CHOSEN_INPUT_IDS_KEY],
data[REJECTED_INPUT_IDS_KEY]
),
dim=0,
)
with accelerator.accumulate(model):
# RM으로 각 시퀀스의 보상 예측
_, predicted_reward, _ = get_reward(
model,
query_responses,
tokenizer.pad_token_id,
0,
)
# 출력에서 채택 및 기각 보상 추출
chosen_reward = predicted_reward[
:data[CHOSEN_INPUT_IDS_KEY].shape[0]
]
rejected_reward = predicted_reward[
data[CHOSEN_INPUT_IDS_KEY].shape[0] :
]
# RM의 손실과 기울기 계산
loss = -F.logsigmoid(chosen_reward - rejected_reward).mean()
accelerator.backward(loss)
# RM 매개변수 갱신
optimizer.step()
optimizer.zero_grad()
```
최상위 연구소에서 대규모 RM을 훈련할 때 사용하는 이 코드도 간단한 예제와 크게 다르지 않다. 물론 허깅 페이스 같은 최신 딥러닝 패키지가 제공하는 추상화 덕분에 훈련 루프가 단순해진 면이 크다. 하지만 _여기서 얻어야 할 핵심 교훈은 지금까지 배운 개념이 RM의 실제 훈련 및 활용에 그대로 적용된다는 점이다._
지금까지는 일반적으로 분류기 기반 RM이라고 부르는 표준 형태의 RM에 집중했다. 하지만 RM은 프롬프트와 응답을 바탕으로 선호 점수를 예측하는 모델일 뿐이므로 다양한 방식으로 구현할 수 있다. 예를 들어 [ArmoRM](http://arxiv.org/abs/2406.12845) 같은 맞춤형 분류기를 훈련해 RM으로 사용할 수 있다.
[](https://substackcdn.com/image/fetch/$s_!MLb6!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F15fe250b-0749-4303-8052-2641bc1dff20_1086x452.png)
([9]에서 발췌)
**LLM 심사위원(LLM-as-a-Judge)** 모델도 RM으로 쓸 수 있다. LLM 심사위원에게 프롬프트로 선호 점수를 요청하면 된다. 위 그림을 참고하라. 이렇게 얻은 선호 점수는 RL 훈련의 보상 신호로 활용할 수 있다.
또는 LLM 심사위원으로 합성 선호 데이터를 수집할 수 있다. 예컨대 아래에 제시한 [알파카이밸(AlpacaEval)](https://github.com/tatsu-lab/alpaca\_eval)의 프롬프트 같은 것을 이용한다. 그런 다음 [헌법적 AI(Constitutional AI)](https://cameronrwolfe.substack.com/i/136751520/constitutional-ai-harmlessness-from-ai-feedback) [10]와 [AI 피드백 기반 강화 학습(RLAIF)](https://cameronrwolfe.substack.com/i/136751520/rlaif-scaling-reinforcement-learning-from-human-feedback-with-ai-feedback) [11]처럼 이 합성 데이터로 RM을 일반적인 방식에 따라 훈련할 수 있다.
**결과 보상 모델(Outcome Reward Model, ORM)** [12]과 **과정 보상 모델(Process Reward Model, PRM)** [11]은 문헌에서 흔히 쓰이는 또 다른 RM 변형이다. ORM은 주로 추론 과제에 사용하며, 완성문이 과제의 정답일 확률을 예측한다. ORM을 훈련할 때도 앞과 비슷하게 선호 데이터셋을 수집한다. 다만 각 선호 쌍에는 특정 질문에 대한 오답과 정답이 하나씩 들어간다. 시퀀스 단위로 보상을 예측하는 표준 RM과 달리 ORM은 토큰마다 정답 여부를 예측한다.
> _“검증기는 언어 모델이며, 토큰마다 예측값을 출력하는 작은 스칼라 헤드를 갖는다.”_ - [12]에서 발췌
[](https://substackcdn.com/image/fetch/$s_!fqNz!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Faf5d0e0c-de50-4f50-9b4a-b11d3a2c45fb_1964x960.png)
([12]에서 발췌)
PRM도 ORM과 마찬가지로 주로 추론 과제에 쓰이며 더 세분화된 출력을 예측한다. 하지만 PRM은 토큰마다 예측하는 것이 아니라 추론 과정의 각 단계가 끝날 때마다 예측한다. PRM은 [다양한 논문](https://arxiv.org/abs/2501.07301)에서 사용됐지만 훈련 데이터를 수집하기가 어렵다. 세밀한 감독, 즉 추론 과정의 각 단계마다 정답 여부를 나타내는 신호가 필요하기 때문이다.
> _“PRM은 사고 사슬 추론 과정의 각 단계에서 점수를 출력하도록 훈련한 보상 모델이다. EOS 토큰에서만 점수를 출력하는 표준 RM이나 모든 토큰에서 점수를 출력하는 ORM과는 다르다. 과정 보상 모델은 각 추론 단계가 끝날 때마다 감독 신호가 필요하다.”_ - [출처](https://rlhfbook.com/c/07-reward-models.html)
[](https://substackcdn.com/image/fetch/$s_!Dtl3!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F6bde3170-7f57-4f2f-aebb-3af9eb7b6a62_1556x948.png)
([3]에서 발췌)
챗GPT 이후 초창기 LLM은 거의 언제나 인스트럭트GPT가 제안한 3단계 정렬 절차[3]로 사후 훈련했다. 위 그림에 나온 이 절차는 다음 세 단계로 구성된다.
1. [지도 미세 조정(supervised fine-tuning, SFT)](https://cameronrwolfe.substack.com/p/understanding-and-using-supervised), 즉 _지시 미세 조정(instruction fine-tuning, IFT)_에서는 좋은 완성문 예제를 대상으로 [다음 토큰 예측](https://cameronrwolfe.substack.com/p/language-model-training-and-inference)을 수행해 모델을 훈련한다.
2. [인간 선호 데이터셋](https://rlhfbook.com/c/05-preferences.html)으로 보상 모델(RM)을 훈련한다.
3. RM 출력을 훈련 신호로 삼아 강화 학습(RL)으로 LLM을 미세 조정한다.
이 절차의 2단계와 3단계를 통틀어 [인간 피드백 기반 강화 학습(reinforcement learning from human feedback, RLHF)](https://cameronrwolfe.substack.com/p/the-story-of-rlhf-origins-motivations)이라고 한다. _강화 학습(RL) 최적화 도구로 LLM을 미세 조정하고, 선호 레이블을 통해 인간 피드백을 반영한다._
[](https://substackcdn.com/image/fetch/$s_!QTAv!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F2914a412-f20e-40d5-8d44-abdb4d77f1be_1754x746.png)
([4]에서 발췌)
오늘날에는 상황이 조금 더 복잡하다. 위 그림은 [툴루 3(Tulu-3)](https://arxiv.org/abs/2411.15124) [4]에 사용한 현대적인 사후 훈련 파이프라인의 사례다. 기존 3단계 정렬 절차와의 주요 차이점은 다음과 같다.
* SFT 단계는 _여전히 매우 일반적이지만_ 항상 사용하지는 않는다. 특히 [최근의 추론 모델](https://cameronrwolfe.substack.com/p/demystifying-reasoning-models)이 그렇다. 예를 들어 [딥시크-R1(DeepSeek-R1)](https://cameronrwolfe.substack.com/p/demystifying-reasoning-models)의 일부 변형은 SFT를 생략하고 사전 훈련 모델에 RL을 곧바로 적용한다.
* RL 훈련은 보통 여러 차례 수행한다. 매번 새로운 데이터를 수집해 LLM의 능력을 더욱 향상한다.
* 여러 RL 변형과 비 RL 방식의 대안을 _함께 사용할 수도 있다._ 이 가운데 RM이 필요한 방식도 있고 그렇지 않은 방식도 있다.
복잡성이 더해졌어도 데이터 품질은 오늘날까지 성공적인 사후 훈련을 좌우하는 핵심 요소다. 이 절에서는 RL 훈련 프레임워크를 개괄하고, _각 프레임워크에서 RM이 어떤 역할을 하는지 또는 전혀 필요하지 않은지_ 중점적으로 살펴본다.
RL로 LLM을 훈련하는 전반적인 구성을 잘 모른다면 아래 개요를 참고하라. 이 논의를 이해하려면 LLM 맥락에서 RL의 기본 원리를 알아야 한다.
**LLM을 위한 RL(RL for LLMs).** LLM 훈련에서 널리 활용하는 강화 학습(RL)은 크게 두 종류다. 하나는 앞서 설명한 사후 훈련 과정의 2단계와 3단계에 해당하는 RLHF이고, 다른 하나는 [검증 가능한 보상을 활용하는 강화 학습(reinforcement learning with verifiable rewards, RLVR)](https://cameronrwolfe.substack.com/i/153722335/reinforcement-learning-with-verifiable-rewards)이다. 아래 그림은 이 두 RL 변형을 보여준다.
[](https://substackcdn.com/image/fetch/$s_!CJn6!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fc0fd3791-df29-4a92-b185-21f6be4f2ddc_2176x642.png)
([4]에서 발췌)
RL 관점에서 두 기법은 비슷하다. 전반적인 훈련 구성이 같으며, 모두 [정책 경사 알고리즘](https://cameronrwolfe.substack.com/p/policy-gradients-the-foundation-of)[4](https://cameronrwolfe.substack.com/p/reward-models#footnote-4) 기반 RL 최적화 도구로 매개변수 갱신값을 구한다. 두 기법의 가장 큰 차이는 보상을 정의하는 방식에 있다.
* RLHF에서는 RM이 보상을 제공한다. RM은 LLM이 생성한 각 완성문에 인간 선호 점수를 부여한다.
* RLVR은 [결정론적 또는 검증 가능한 보상](https://cameronrwolfe.substack.com/i/153722335/reinforcement-learning-with-verifiable-rewards)을 사용한다. LLM이 낸 답을 정답 또는 오답으로 판정한다.
특히 RLVR의 결정론적 보상은 _보통 규칙에 기반하며_ RM의 필요성을 없앤다. 일반적으로 LLM의 생성 출력에서 최종 답을 추출한 다음 알려진 정답과 비교해 보상을 구한다. 정확한 문자열 일치나 퍼지 매칭 같은 방식을 이용할 수 있다. 이 비교로 LLM 출력의 정답 여부를 판정하고, 이진 신호를 RL 훈련의 보상으로 사용한다.
**RLHF와 RLVR(RLHF vs RLVR).** [최근의 최첨단 모델](https://www.interconnects.ai/p/the-state-of-post-training-2025)에서는 두 RL 방식이 모두 사후 훈련 과정에 쓰인다. 여전히 3단계 사후 훈련 절차(SFT → RLHF)를 수행해 LLM에 올바른 형식을 가르치고 인간 선호에 맞게 정렬한다. 여기에 RLVR 단계를 추가해 추론 능력과 검증 가능한 과제의 성능을 높인다.
더 일반적으로는 RL 미세 조정, _특히 RLVR_에 투입하는 연산량이 빠르게 늘고 있다. 최근 추론 모델 연구에서 RL 훈련에 사용한 연산량에 따라 모델 성능이 향상되는 뚜렷한 [스케일링 법칙](https://cameronrwolfe.substack.com/p/llm-scaling-laws)이 나타났기 때문이다. 아래 그림을 참고하라.
[](https://substackcdn.com/image/fetch/$s_!JEX5!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F02a4cd97-6c90-456b-9b51-65eaaa4fe677_608x636.png)
([5]에서 발췌)
> _“RLHF는 복잡하고 흔히 불안정한 절차다. … 우리는 단순한 분류 손실만으로 표준 RLHF 문제를 해결할 수 있게 하는 새로운 RLHF 보상 모델 매개변수화 방식을 제안한다.”_ - [6]에서 발췌
**직접 정렬(Direct alignment).** RM을 피하는 방법은 RLVR만이 아니다. RM을 완전히 생략하면서도 RLHF와 비슷하게 모델을 인간 선호에 맞춰 정렬할 수 있다. 이러한 기법을 [직접 정렬 알고리즘(direct alignment algorithm)](https://rlhfbook.com/c/12-direct-alignment.html)이라고 한다. 이 부류에서 가장 널리 사용하는 알고리즘은 직접 선호 최적화(direct preference optimization, DPO) [6]다. DPO 같은 직접 정렬 알고리즘은 RLHF와 같은 훈련 목표를 최적화하면서도 RM을 생략할 뿐 아니라 RL 훈련 자체도 피한다. 아래에는 RLHF와 DPO를 비교했다.
[](https://substackcdn.com/image/fetch/$s_!vj3B!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F8cae8395-d481-49f9-b630-f5120b9abe7e_1642x576.png)
([6]에서 발췌)
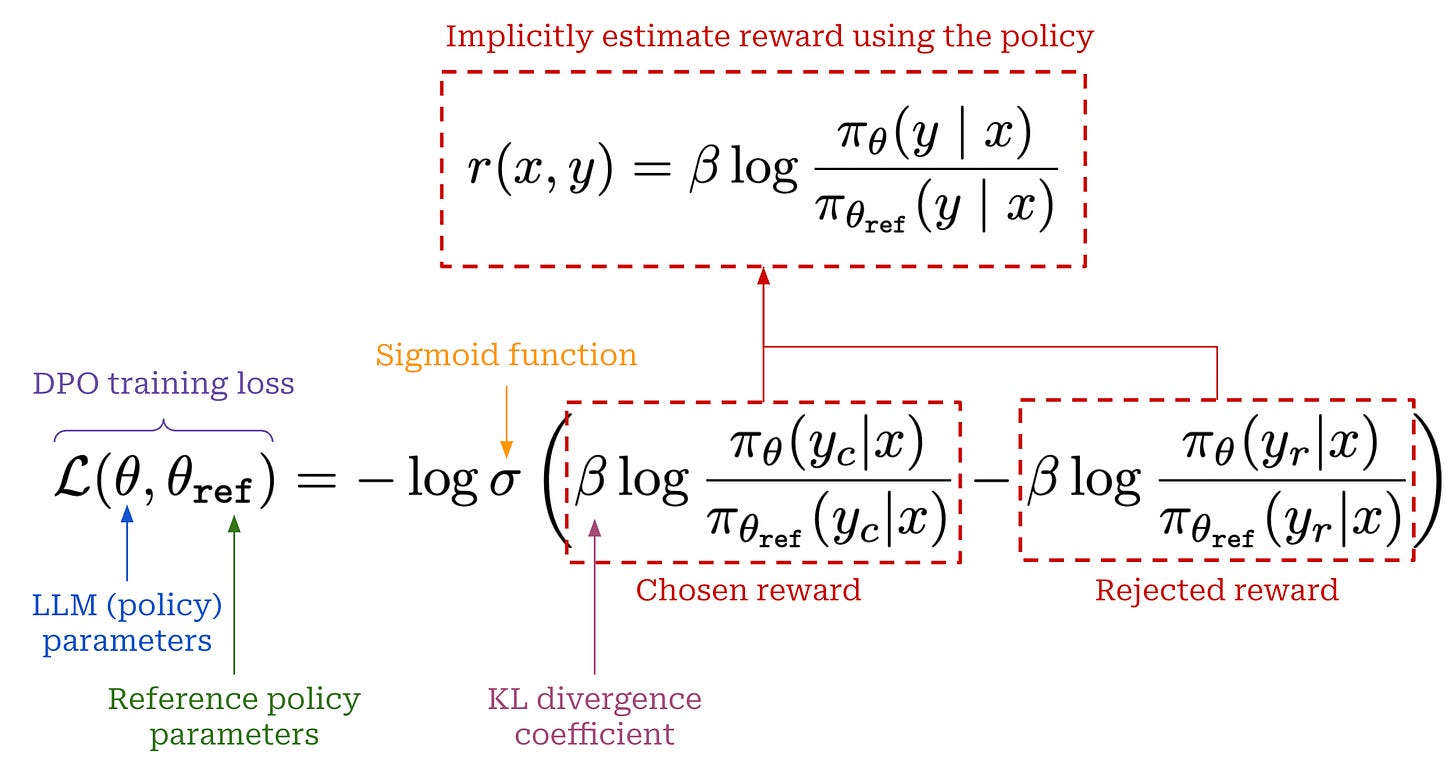
DPO 훈련에 사용하는 손실 함수는 아래와 같다. RM의 손실 함수와 매우 비슷해 보인다. 하지만 이제 RM으로 보상을 예측하지 않는다. 그 대신 현재 정책과 기준 정책이 채택 및 기각 완성문에 부여한 확률을 이용해 정책이 직접 보상을 암묵적으로 추정한다. 직관적으로는 채택 완성문의 로그 비율이 기각 완성문의 로그 비율보다 클 때 이 손실이 최소화된다. _DPO는 현재 정책이 기각 응답보다 채택 응답에 더 높은 암묵적 보상을 부여하도록 훈련한다._
[](https://substackcdn.com/image/fetch/$s_!yQz2!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F7107abbb-358e-48d4-a200-64ca6b5d1d72_2050x1092.png)
DPO 훈련 손실([6]에서 발췌)
DPO에서는 중간 RM을 별도로 만들 필요가 없다. 하지만 손실 함수는 여전히 브래들리-테리 모델에서 도출하며, 여전히 RM을 학습하는 셈이다. 핵심적인 차이는 RM을 명시적으로 학습하는 대신 암묵적으로 학습한다는 점이다. 그래서 DPO 논문[6]의 제목도 _“당신의 언어 모델은 남몰래 보상 모델이다(Your Language Model is Secretly a Reward Model)”_다. RM과 비슷한 방식으로 DPO 모델에서 이 암묵적 보상 추정치를 직접 얻을 수 있다. DPO의 전체 유도 과정과 분석은 [여기](https://rlhfbook.com/c/12-direct-alignment.html)를 참고하라.
[](https://substackcdn.com/image/fetch/$s_!qAWR!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F50c593a0-6b23-4033-806e-0407afaebc6c_1552x636.png)
RL에서 기준·보상·가치·정책 모델 조율하기([출처](https://arxiv.org/abs/2409.19256v2))
RM을 쓰면 LLM 훈련 과정이 복잡해지는 것은 분명하다. 먼저 대규모 선호 데이터셋으로 별도 모델을 훈련해야 하므로 비용과 복잡성이 늘어난다. 이후 RL 훈련 중 이 모델을 온라인 방식으로 사용한다. _훈련 과정에서 현재 정책이 생성한 완성문을 RM이 채점한다._ RM 역시 LLM이므로 훈련 중 별도의 LLM을 따로 호스팅하고 추론을 실행해야 한다. 이를 효율적으로 조율하기는 어려울 수 있다. 위 그림을 참고하라.
> _“대규모 강화 학습 과정에서 신경망 RM이 보상 해킹에 취약할 수 있음을 확인했다. 보상 모델을 다시 훈련하려면 추가 훈련 자원이 필요하고 전체 훈련 파이프라인도 복잡해진다.”_ - [7]에서 발췌
**보상 해킹(Reward hacking).** 더 나아가 RM은 [보상 해킹](https://lilianweng.github.io/posts/2024-11-28-reward-hacking/)의 대상이 될 수 있다. RM이 낮은 품질의 완성문에 터무니없이 높은 보상을 부여할 수 있다. 더 일반적으로는 정책이 원하는 과제를 실제로 해결하지 않고도 높은 보상을 받도록 RM을 악용할 수 있다. 흥미롭게도 보상 해킹은 RLHF 훈련의 확장을 가로막는 핵심 한계다. _정책을 충분히 오래 훈련하면 결국 RM의 허점을 찾아낸다._ 반면 검증 가능한 보상은 해킹하기가 더 어렵다. 물론 [불가능한 것은 아니다](https://lilianweng.github.io/posts/2024-11-28-reward-hacking/#reward-hacking-examples-in-llm-tasks). 따라서 RLVR을 사용하면 추론 모델을 더 많은 반복 횟수로 장기간 훈련할 수 있다.
**RM을 피해야 하는가?(Should we avoid RMs?)** RM에 비용과 복잡성이 더해진다는 점을 고려하면 이런 의문이 들 수 있다. _RM을 아예 피해야 할까?_ 이 질문에는 확정적인 답이 없다. RLVR로 인상적인 결과를 얻었고, DPO처럼 RM을 쓰지 않는 기법으로도 모델을 인간 선호에 정렬할 수 있다. [많은 연구](https://www.interconnects.ai/p/the-dpo-debate)가 RLHF와 DPO 사이에 성능 차이가 있는지를 두고 상반된 결과를 제시했다. DPO가 효과적인 무 RM 선호 조정 대안인지는 사용 사례에 따라 다르다. 하지만 두 기법 사이에 성능 차이가 있다는 점은 대체로 인정된다.
> _“RLHF가 널리 쓰이는 이유는 인간의 가치와 선호를 언어 모델에 반영할 때 가장 어려운 문제 중 하나인 명시적 보상 지정을 효과적으로 우회하기 때문이다.”_ - [1]에서 발췌
**RM의 유용성(The utility of RMs).** 이러한 연구 결과에도 RM이 대단히 중요하고 강력한 개념이라는 사실을 잊어서는 안 된다. 어떤 형태의 RL 훈련에서든 가장 어려운 일 중 하나는 보상을 지정하는 것이다. LLM에서는 특히 더 어렵다. _LLM의 “좋은” 응답을 무엇이라고 명시적으로 정의할 수 있을까?_ 안타깝게도 단 하나의 속성이나 품질로 이를 판단할 수는 없다. 유효한 모델 응답의 범위는 거의 무한하다.
RM을 쓰면 인간에게 선호 피드백을 요청하는 더 단순한 과제로 이 과정을 압축할 수 있다. 즉, 모델 응답 쌍 가운데 하나를 고르게 한다. 이를 통해 명시적 보상을 지정하는 문제를 우회한다. 아래 그림을 참고하라.
[](https://substackcdn.com/image/fetch/$s_!JBCh!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F9510abc4-232c-446b-a0b0-cf949efd9045_2046x1540.png)
인간 선호 데이터를 수집하는 인터페이스([8]에서 발췌)
개별 모델 응답을 직접 작성하거나 평가하는 것보다 한 쌍 가운데 더 나은 응답을 고르는 편이 훨씬 쉽다. _사람은 이진 선호만 제시하면 된다._ 이러한 선호 피드백으로 RM을 훈련하면 보상을 명시적으로 정의하지 않고도 RL 훈련에 사용할 보상을 얻을 수 있다. 이 방식은 일반적인 인간 피드백으로 LLM을 훈련하는 유연하고 효과적인 수단이며, 혁신적인 변화를 가져왔다.
[](https://substackcdn.com/image/fetch/$s_!3gHA!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fb649fc49-a1df-4b76-9f6f-6408c1838ed9_2484x576.png)
RM을 이용한 Best-of-N 샘플링
**RM의 다른 사용 사례(Other use cases for RMs).** RM은 RL 훈련 외에도 다양한 용도로 쓰인다. 예를 들면 _i)_ Best-of-N 샘플링과 추론 시점 스케일링, _ii)_ 평가, _iii)_ [기각 샘플링(rejection sampling)](https://rlhfbook.com/c/10-rejection-sampling.html), _iv)_ 데이터 필터링 등이 있다. 이처럼 사용 사례가 많지만 RM의 성능은 대개 다음 기준으로 평가한다.
* _정확도(Accuracy)_: RM이 응답 쌍에서 채택 응답을 올바르게 식별하는 능력
* _다운스트림 성능(Downstream performance)_: 특정 RM을 사용해 RL 미세 조정한 LLM의 성능
* _추론 시점 스케일링(Inference-time scaling)_: 특정 RM을 Best-of-N 샘플링 파이프라인에 활용해 얻는 성능 향상
이제 RM을 이해했으므로 이 주제의 최근 논문 몇 편을 살펴본다. 특히 RM의 효과를 평가하는 벤치마크인 리워드벤치(RewardBench) [1]에 집중한다. 이 벤치마크는 다양한 사용 사례에서 수백 개의 RM을 평가하는 데 쓰였다. 이를 통해 RM을 실제로 효과적으로 훈련하고 사용하는 방법에 관한 유용한 교훈을 얻을 수 있다. 최근에는 이러한 연구 결과를 현대화하고 확장한 새 버전인 _리워드벤치 2(RewardBench 2) [2]_도 제안됐다.
[](https://substackcdn.com/image/fetch/$s_!Rmwn!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F6539e2fa-ef3b-404e-bb3a-934b3d51de05_2232x502.png)
([1]에서 발췌)
RM을 훈련할 때는 실용적인 선택을 많이 내려야 한다. 사용할 보상 모델의 유형과 RM 초기화에 쓸 정책, 훈련 에폭 수 등을 정해야 한다. 하지만 RM 생성에 관한 실무 세부 사항은 대부분 제대로 문서화돼 있지 않다. [1]의 저자들은 RM 평가용 표준 벤치마크인 리워드벤치를 만들어 이 문제를 해결한다. 다양한 RM을 리워드벤치에서 평가하면 여러 실무적 선택이 RM 성능과 해당 RM으로 훈련한 다운스트림 LLM 성능에 미치는 영향을 파악할 수 있다. 이 분석을 통해 RM의 작동 원리를 더 잘 이해하고 고품질 RM을 만드는 모범 사례를 얻는다.
> _“보상 모델(RM)은 사전 훈련 모델을 인간 선호에 맞추는 성공적인 RLHF의 핵심이지만, 이 보상 모델의 평가에 초점을 맞춘 연구는 상대적으로 거의 없었다.”_ - [8]에서 발췌
**리워드벤치란 무엇인가?(What is RewardBench?)** 리워드벤치는 RM을 평가하는 프레임워크이자 데이터셋이다. [데이터](https://huggingface.co/datasets/allenai/reward-bench)와 [평가 코드](https://github.com/allenai/reward-bench)를 공개한 개방형 벤치마크다. [1]에서는 이를 이용해 공개된 RM의 현황을 정리했다. 순위표는 [여기](https://huggingface.co/spaces/allenai/reward-bench)에서 볼 수 있다. 리워드벤치는 다양한 능력에 관해 RM을 체계적으로 평가한다. 이를 통해 특정 유형의 RM이 어떻게, 왜 잘 작동하는지 더 깊이 이해할 수 있다.
**RM 성능 정량화(Quantifying RM performance).** 리워드벤치는 프롬프트와 두 응답의 쌍으로 구성된다. _하나는 채택된 선호 응답이고 다른 하나는 기각된 응답이다._ RM을 평가하려면 선호 응답을 식별할 수 있는지 시험하면 된다. 구체적으로 채택 및 기각 응답 모두에 대해 RM 출력을 계산하고 두 점수를 비교한다. RM의 “올바른” 동작은 채택 응답에 더 높은 점수를 부여하는 것이다. 아래 그림을 참고하라. _DPO 모델의 암묵적 보상 추정치를 사용해 같은 방식으로 DPO 모델을 RM처럼 평가할 수도 있다._
[](https://substackcdn.com/image/fetch/$s_!RDRA!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F0de7117d-4544-4294-b907-8ce711fe597b_1610x704.png)
리워드벤치가 사용하는 채점 기법([1]에서 발췌)
선호 응답을 올바르게 식별하는 능력은 정확도 지표로 쉽게 측정할 수 있다. 채택 및 기각 응답이 포함된 프롬프트 데이터셋 전체에서 RM이 올바른 출력을 낸 횟수를 센다. 여러 RM을 비교하려면 고정된 데이터셋에서 이 정확도 지표를 계산하면 된다.
[](https://substackcdn.com/image/fetch/$s_!ZOMs!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Ff1ee8aee-08da-4942-bb7f-4d0d34f83d9d_1652x1328.png)
([1]에서 발췌)
**데이터 구성(Data composition).** 응용 분야에 따라 RM이 포착해야 할 능력의 범위는 매우 넓다. 리워드벤치는 RM 성능을 종합적으로 보여주기 위해 여러 영역에서 품질을 측정한다. 위 표에 요약된 영역은 다음과 같다.
1. _대화(Chat)_: 올바른 대화 응답을 구별하는 RM의 능력을 시험한다.
2. _어려운 대화(Chat Hard)_: 함정 질문을 파악하고 응답 사이의 미묘한 차이를 식별하는 능력을 시험한다.
3. _안전성(Safety)_: 안전하지 않은 프롬프트를 거부하고 잘못된 거부를 피하는 능력을 시험한다.
4. _추론(Reasoning)_: 우수한 코딩 및 추론 응답을 구별하는 능력을 시험한다.
5. _기존 데이터셋(Prior datasets)_: 기존 연구와의 일관성을 위해 [앤트로픽의 HH 데이터셋](https://huggingface.co/datasets/Anthropic/hh-rlhf), [스탠퍼드 인간 선호 데이터셋](https://huggingface.co/datasets/stanfordnlp/SHP), [오픈AI의 요약 학습 데이터셋](https://huggingface.co/datasets/openai/summarize_from_feedback) 같은 기존 선호 데이터셋도 포함한다.
리워드벤치의 각 범주에서 모델을 정확도로 평가한다. 범주별 종합 점수는 해당 범주에 포함된 예제의 가중 평균으로 구한다. 여러 영역에서 RM을 평가하면 성능을 더 세밀하게 파악할 수 있다. _특정 유형의 RM은 어떤 영역에서는 뛰어나지만 다른 영역에서는 그렇지 않은 경우가 흔하다._
[](https://substackcdn.com/image/fetch/$s_!SJFG!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F0c87f9e9-d002-4b7c-9621-20fc42387b1d_1056x710.png)
([1]에서 발췌)
저자들은 RM이 응답 품질의 미묘한 차이를 포착하는 능력도 연구한다. 이를 위해 채택 응답과 기각 응답의 차이가 작은 어려운 선호 예제를 만든다. 위 그림에 사례가 나와 있다. 이상적인 RM은 이런 미묘한 차이를 포착하고 더 나은 응답에 일관되게 높은 점수를 부여해야 한다. 저자들은 [길이 편향(length bias)](https://arxiv.org/abs/2404.04475)이 결과를 왜곡하지 않도록 리워드벤치의 모든 응답 쌍을 비슷한 길이로 맞췄다.
[](https://substackcdn.com/image/fetch/$s_!N3hz!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F36a2c6e1-49ff-470c-b567-815aa23fac19_1622x1272.png)
([8]에서 발췌)
**RM 분석(Analysis of RMs).** 위에는 [1]에서 검토한 50개 이상의 RM 가운데 상위 20개가 리워드벤치에서 거둔 실험 성능을 정리했다. 이 RM의 크기는 매개변수 4억 개부터 700억 개까지 다양하며 소형·중형·대형 그룹으로 나뉜다. 핵심 결과는 다음과 같다.
* 모든 RM에서 어려운 대화와 추론 하위 집합의 성능이 전반적으로 낮았다. 이는 앞으로 개선할 수 있는 영역을 보여준다. 대형 RM만 어려운 대화와 추론 하위 집합에서 일관되게 좋은 성능을 냈다.
* RM에 더 강력한 기반 모델을 사용하면 도움이 된다. 예를 들어 라마 3 기반[5](https://cameronrwolfe.substack.com/p/reward-models#footnote-5) RM은 리워드벤치에서 좋은 성능을 보인다. RM 기반 모델에 가한 미묘한 변경도 성능에 영향을 줄 수 있다. 훈련 데이터나 전략을 조금만 바꿔도 마찬가지다.
* LLM 심사위원 유형의 RM은 모델 크기가 커질수록 성능이 좋아지지만, 분류기 기반 RM이 여전히 눈에 띄게 우수하다.
* RM의 스케일링 특성은 RM 유형과 기반 모델 선택에 따라 달라진다. 예를 들어 아래 표에서는 라마 2 DPO 모델의 크기가 커질수록 RM 성능이 향상되지만, 분류기 기반 큐원 1.5 RM에서는 그렇지 않다.
* 기존 평가 데이터셋의 결과는 리워드벤치 결과와 일치하지 않는다. _이는 이러한 벤치마크의 결과가 성능을 종합적으로 측정하지 못할 수 있음을 보여준다._ 예를 들어 DPO 모델을 RM처럼 평가하면 리워드벤치에서는 좋은 성능을 내지만 기존 벤치마크에서는 부진하다.
> _“라마 2는 리워드벤치의 모든 영역에서 모델 규모가 커질수록 뚜렷하게 향상된다. 반면 큐원 1.5는 단조로운 향상이 덜 나타난다. 분포 외 일반화의 어려움 때문일 가능성이 크다.”_ - [1]에서 발췌
[](https://substackcdn.com/image/fetch/$s_!-ReQ!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F9b65081a-c324-4961-9abe-fc368009ed97_2256x496.png)
([1]에서 발췌)
RM의 모범 사례를 파악한 다음 단계는 이 지식을 이용해 더 나은 LLM을 훈련하는 것이다. [13]의 저자들은 리워드벤치에서 얻은 교훈을 적용해 RL 미세 조정을 심층적으로 연구한다. 특히 DPO와 PPO의 성능 비교에 초점을 맞춘다. 여기서는 두 기법의 비교 자체를 중점적으로 다루지 않는다. 하지만 이 분석에는 RM으로 훈련하는 LLM의 다운스트림 성능을 극대화하는 RM 제작법과 관련된 실용적인 교훈도 많다.
[](https://substackcdn.com/image/fetch/$s_!EQMc!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F3ad6659b-69df-41e3-b09b-80d4ab854cb8_1302x828.png)
([13]에서 발췌)
**데이터 품질(Data quality).** 위에는 [13]의 핵심 실험 결과를 요약했다. 실험은 앤트로픽의 [HH RLHF](https://huggingface.co/datasets/Anthropic/hh-rlhf) 데이터셋으로 DPO 모델을 훈련하면서 시작한다. 이 데이터셋은 오래됐고 잡음이 많은 것으로 알려져 있다. 이 데이터로도 모델 성능이 향상되지만, 현대적인 고품질 선호 데이터셋인 [울트라피드백(UltraFeedback)](https://arxiv.org/abs/2310.01377)으로 훈련하면 훨씬 더 크게 향상된다. 같은 데이터로 [PPO](https://cameronrwolfe.substack.com/p/proximal-policy-optimization-ppo) 훈련으로 전환하면, 즉 RM을 사용하면 성능이 명확하게 개선된다. 이는 명시적 RM과 PPO를 사용하면 다운스트림 성능상 이점이 있음을 뜻한다. 하지만 이 이점은 더 좋은 데이터를 사용했을 때 얻는 효과보다 훨씬 작다는 점에 주목해야 한다.
**더 큰 RM(Larger RMs).** PPO 훈련의 이점이 명확하다면 더 큰 RM을 사용했을 때 LLM에도 이점이 있는지 궁금할 수 있다. [LLM 스케일링 법칙](https://cameronrwolfe.substack.com/p/llm-scaling-laws)을 고려하면 직관적으로 타당해 보이지만 [13]에서 관찰한 결과는 그렇게 단순하지 않다.
RM을 매개변수 130억 개에서 700억 개로 키워도 다운스트림 LLM 성능은 정체된다. 같은 SFT 체크포인트에서 초기화한 모델도 마찬가지다. 관찰 가능한 성능상의 이점은 추론 영역에서만 나타난다. 이는 더 큰 모델의 우수한 능력이 유용하거나 필요한 상황에서만 대형 RM의 이점이 뚜렷하다는 뜻이다. 다시 말해 대형 RM을 유용하게 쓰려면 더 어려운 데이터가 필요하다.
> _“더 큰 보상 모델을 사용한다면 실제로 그 보상 모델이 도전적으로 느낄 만한 데이터가 필요하다.”_ - [출처](https://www.youtube.com/watch?v=rDF7eFPeVto)
**더 좋은 데이터와 더 큰 RM(Better data + bigger RM).** [13]의 저자들은 위의 교훈을 결합해 더 어렵고 규모가 큰 프롬프트 집합을 수집한다. _특히 코딩과 추론 과제를 강조한다._ 그런 다음 RM 훈련에 사용하고 대형 RM이 유리한지 다시 시험한다. 이 실험에서는 RM 품질이 개선됐다는 명확한 신호가 나타난다. 예를 들어 아래와 같이 더 크고 우수한 RM을 Best-of-N 샘플링에 사용하면 성능이 눈에 띄게 향상된다. 하지만 리워드벤치와 다운스트림 성능을 함께 살펴보면 이러한 개선은 훨씬 불분명하다.
[](https://substackcdn.com/image/fetch/$s_!ZfRv!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F96a83a07-9d28-406b-b1eb-16b99ce61594_920x398.png)
([13]에서 발췌)
간단히 말해 더 크고 우수한 RM을 사용한다고 해서 이 RM으로 RL 미세 조정한 LLM이 반드시 더 좋아지는 것은 아니다. 실제로 [13]에서는 대형 RM을 사용할 때 일부 영역의 성능이 _퇴보(regression)_하기도 했다. 이 때문에 RM 평가는 매우 복잡해진다. _RM의 정확도만 측정해서는 해당 RM이 얼마나 유용할지 알 수 없다._
[](https://substackcdn.com/image/fetch/$s_!QC2H!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F0f2e98d3-b5b4-43cb-9824-63dd79b78244_1938x820.png)
([2]에서 발췌)
최근 제안된 리워드벤치 2 [2][6](https://cameronrwolfe.substack.com/p/reward-models#footnote-6)는 RM 평가를 더 유용하고 유익하게 만들기 위해 기존 리워드벤치를 개선한다. 이 벤치마크에는 LLM이 보유할 수 있는 더 폭넓은 능력을 다루는 새로운 데이터가 들어 있다. RM의 점수는 평균적으로 약 20점 낮다. _훨씬 더 어려운 벤치마크이기 때문이다._ 여전히 정확도 기반 방식으로 RM을 평가하지만, 리워드벤치 2는 Best-of-N 샘플링 같은 다운스트림 RM 활용 성능과 뚜렷한 상관관계를 보인다. 또한 특정 RM이 RL 미세 조정에서 효과적일지 판단하는 데 유용한 교훈을 제공한다.
**RM 성능 측정(Measuring RM performance).** 리워드벤치 2는 RM이 채택 응답과 기각 응답을 구분하는 정확도를 측정하는 대신, 각 프롬프트에 네 가지 응답을 제공한다. _하나는 채택 응답이고 세 개는 기각 응답이다._ RM은 채택 응답에 모든 기각 응답보다 높은 점수를 부여해야 한다. 아래 그림을 참고하라. 이 Best-of-4 방식도 기존 리워드벤치처럼 정확도에 기반하지만 훨씬 어렵다. 강력한 RM의 성능조차 무작위 기준선인 정확도 25%에 더 가까워진다.
[](https://substackcdn.com/image/fetch/$s_!MobT!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fb44b1dcf-1e55-4544-98b9-1c075aa60486_951x367.png)
([2]에서 발췌)
또한 리워드벤치 2는 정확도 기반 평가를 넘어 다음 상황에서 LLM 성능을 측정한다.
1. 특정 RM을 Best-of-N 샘플링에 사용하는 경우
2. 특정 RM을 RL 훈련에 사용하는 경우
이처럼 평가 범위를 확장하면 RM 자체의 품질을 이해할 수 있을 뿐 아니라, 추론 시점 스케일링과 RL 훈련에서 이 품질이 다운스트림 성능에 미치는 영향도 관찰할 수 있다. 다른 벤치마크와 비교해 상당히 종합적인 평가 절차다. 아래 그림을 참고하라.
[](https://substackcdn.com/image/fetch/$s_!hGEQ!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F73c28087-a6c7-49d6-9682-39b53980caad_1818x948.png)
([2]에서 발췌)
**데이터 구성(Data composition).** 리워드벤치 2는 RM을 평가할 때 여섯 가지 영역 또는 능력에 초점을 맞춘다. 이 가운데 _집중도(focus), 수학(math), 안전성(safety)_은 기존 벤치마크와 겹친다. 나머지 _사실성(factuality), 정밀한 지시 준수(precise instruction following), 동점(ties)_은 RM에 완전히 새로운 과제를 제시한다. 동점 영역에서는 똑같이 타당한 답을 처리하는 RM의 능력을 시험한다.
> _“벤치마크는 와일드챗 파이프라인에서 이전에 거의 사용하지 않은 인간 작성 프롬프트를 가져와 만들었다. 광범위한 수작업·프로그래밍·언어 모델 기반 필터링 기법을 적용했다.”_ - [2]에서 발췌
리워드벤치 2는 이전에 보지 못한 인간 작성 프롬프트를 사용한다. 대부분 실제 사용자의 챗GPT 로그를 수집한 데이터셋인 [와일드챗(WildChat)](https://arxiv.org/abs/2405.01470)에서 표본으로 추출한다. 데이터 오염 위험 때문에 보지 못한 프롬프트를 사용하는 것이 중요하다. 데이터가 오염됐다면[7](https://cameronrwolfe.substack.com/p/reward-models#footnote-7), 두 평가에 같은 데이터가 쓰이므로 RM 벤치마크와 다운스트림 성능 사이에 매우 높은 상관관계가 나타난다. 상관관계가 실제로 유효한지 확인하려면 데이터를 오염 제거하고 누출을 막아야 한다.
이를 위해 [2]의 저자들은 다음과 같은 다단계 데이터 선별 파이프라인을 도입한다.
* 와일드챗에서 이전에 사용하지 않은 인간 작성 프롬프트를 확보한다.
* 수작업 검사와 분류기로 각 프롬프트의 영역과 품질을 식별한다. 예를 들어 [QuRater](https://huggingface.co/princeton-nlp/QuRater-1.3B)와 [영역 분류기](https://huggingface.co/valpy/prompt-classification)를 이용한다.
* 광범위한 [데이터 오염 제거](https://github.com/allenai/open-instruct/tree/main/decontamination)를 수행해 다운스트림 평가 데이터셋과 사실상 전혀 겹치지 않게 한다.
* 남은 프롬프트 가운데 가장 좋은 것을 수작업으로 고른다.
* 최신 LLM의 능력을 정확하게 반영하는 다양한 출처에서 각 프롬프트의 완성문을 표본으로 추출한다.
* 여러 신호를 이용해 정답 여부에 따라 완성문을 필터링한다. [LLM 심사위원](https://cameronrwolfe.substack.com/p/llm-as-a-judge), 자동 검증기, [다수결](https://cameronrwolfe.substack.com/i/120285767/solving-tough-problems-with-llms) 등을 활용한다.
리워드벤치 2의 최종 데이터셋과 각 구성 요소의 생성 방식은 아래에 요약돼 있다. 최종 벤치마크 점수는 각 영역에서 얻은 RM 성능[8](https://cameronrwolfe.substack.com/p/reward-models#footnote-8)의 비가중 평균으로 구한다.
[](https://substackcdn.com/image/fetch/$s_!R9d7!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2F7137cb51-ed3e-4c08-9ec2-d714c9c39c87_1812x812.png)
([2]에서 발췌)
**리워드벤치 2 성능(RewardBench 2 performance).** [2]에서는 리워드벤치 2로 100개가 넘는 RM을 평가한다. 아래에는 상위 20개 모델의 성능이 제시돼 있다. 새 벤치마크에서 점수가 낮아진 것뿐 아니라, 제미나이와 클로드 같은 기반 모델을 활용한 LLM 심사위원이 매우 좋은 성능을 보인다. _기반 모델의 능력이 향상되고 있다는 점에는 부합하지만_, LLM 심사위원이 분류기 기반 RM보다 일관되게 낮은 성능을 보였던 기존 리워드벤치의 관찰 결과와는 뚜렷하게 대조된다.
[](https://substackcdn.com/image/fetch/$s_!tLkg!,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubstack-post-media.s3.amazonaws.com%2Fpublic%2Fimages%2Fadf904de-02a0-4f50-bb61-2ec5e8995daa_1034x916.png)
([2]에서 발췌)
[2]의 저자들은 다양한 기반 모델과 하이퍼파라미터 설정으로 자체 RM도 여러 개 훈련한다. 그 결과 RM 초기화에 사용한 기반 모델이 RM에 분명한 영향을 준다는 사실을 확인한다. _기반 모델이 보유한 능력이 RM으로 이어진다._ 모델 계열과 훈련 데이터 혼합 방식, 훈련 유형, RM 초기화에 사용한 사후 훈련 단계 같은 요소가 영역별 RM 성능에 뚜렷한 영향을 준다. 또한 보통의 1에폭 대신 _2에폭 동안_ RM을 훈련하면 이점이 있을 수 있음을 발견한다.
**다운스트림 성능(Downstream performance).** 마지막으로 [2]의 RM 분석은 추론 시점 스케일링과 RL 훈련까지 확장된다. 예상할 수 있듯이 리워드벤치 2 성능은 Best-of-N 샘플링과 높은 상관관계를 보인다. _정확한 보상 모델은 후보 집합에서 가장 좋은 완성문을 식별할 수 있다._
리워드벤치 2와 다운스트림 성능의 상관관계는 그다지 명확하지 않다. 하지만 [2]의 저자들은 RM을 RL 훈련에 사용할 때 성공 여부에 영향을 주는 핵심 요소 하나를 찾아낸다. 바로 _RM과 훈련 대상 정책이 같은 모델 계보에서 파생했는가_이다. 구체적인 결과는 다음과 같다.
* RM 벤치마크의 높은 점수는 RL 훈련에서 높은 다운스트림 성능을 내기 위한 필요조건이지만 충분조건은 아니다. _RM 품질이 향상돼도 다운스트림 성능은 빠르게 포화한다_[9](https://cameronrwolfe.substack.com/p/reward-models#footnote-9)_._
* RL 훈련용 정책 모델과 RM 기반 모델이 서로 맞지 않거나, RL 훈련에 사용한 프롬프트 분포와 RM 훈련에 사용한 분포가 불일치하면 다운스트림 성능이 크게 떨어진다.
[2]의 저자들은 이러한 결과를 바탕으로 다음과 같은 RM 훈련 권고로 연구를 마무리한다.
_“이러한 결과는 보상 모델 평가 벤치마크를 사용할 때 주의해야 함을 보여준다. Best-of-N 샘플링 같은 일부 환경에서 즉시 사용할 보상 모델을 고를 때는 벤치마크를 지침으로 삼을 수 있다. … 하지만 PPO 같은 정책 경사 알고리즘에서는 자신의 훈련 구성 맥락에서 벤치마크 결과를 해석해야 한다. 리워드벤치 2의 최상위 모델을 그대로 가져오는 대신, 해당 모델의 제작법을 가져와 각자의 워크플로에 통합해야 한다. 체크포인트 자체를 그대로 사용해서는 안 된다.”_ - [2]에서 발췌
보상 모델은 LLM 연구에서 가장 강력하고 유연한 도구에 속한다. 살펴본 것처럼 표준 분류기 기반 RM 외에도 다양한 유형의 RM이 존재한다. 효과적인 RM을 만들려면 수많은 실무 요소를 고려해야 한다. 올바른 선택은 응용 분야에 따라 달라진다. 예를 들어 Best-of-N 샘플링과 RL 미세 조정에는 서로 다른 선택이 필요하다. 이 글에서는 브래들리-테리 같은 기본 통계 모델부터 대규모 LLM 기반 RM 훈련까지 살펴보며 RM의 기초를 다졌다. LLM을 위한 대규모 RL 훈련에 더 많은 관심이 쏠릴수록 RM 연구도 빠르게 발전하며 AI에서 갈수록 중추적인 역할을 할 것이다.
[1] Lambert, Nathan, et al. “리워드벤치: 언어 모델링용 보상 모델 평가(Rewardbench: Evaluating reward models for language modeling).” _arXiv 사전 공개 논문 arXiv:2403.13787_ (2024).
[2] Malik, Saumya, et al. “리워드벤치 2: 보상 모델 평가의 발전(RewardBench 2: Advancing Reward Model Evaluation).” _arXiv 사전 공개 논문 arXiv:2506.01937_ (2025).
[3] Ouyang, Long, et al. “인간 피드백으로 지시를 따르는 언어 모델 훈련(Training language models to follow instructions with human feedback).” _신경 정보 처리 시스템 발전(Advances in Neural Information Processing Systems)_ 35 (2022): 27730-27744.
[4] Lambert, Nathan, et al. “툴루 3: 개방형 언어 모델 사후 훈련의 최전선 확장(Tulu 3: Pushing frontiers in open language model post-training).” _arXiv 사전 공개 논문 arXiv:2411.15124_ (2024).
[5] 오픈AI 외. “LLM으로 추론하는 법 학습(Learning to Reason with LLMs).” _https://openai.com/index/learning-to-reason-with-llms/_ (2024).
[6] Rafailov, Rafael, et al. “직접 선호 최적화: 당신의 언어 모델은 남몰래 보상 모델이다(Direct preference optimization: Your language model is secretly a reward model).” _신경 정보 처리 시스템 발전(Advances in Neural Information Processing Systems)_ 36 (2023): 53728-53741.
[7] Guo, Daya, et al. “딥시크-R1: 강화 학습으로 LLM의 추론 능력 장려하기(Deepseek-r1: Incentivizing reasoning capability in llms via reinforcement learning).” _arXiv 사전 공개 논문 arXiv:2501.12948_ (2025).
[8] Bai, Yuntao, et al. “인간 피드백 기반 강화 학습으로 유용하고 무해한 어시스턴트 훈련하기(Training a helpful and harmless assistant with reinforcement learning from human feedback).” _arXiv 사전 공개 논문 arXiv:2204.05862_ (2022).
[9] Zheng, Lianmin, et al. “MT-벤치와 챗봇 아레나로 LLM 심사위원 평가하기(Judging llm-as-a-judge with mt-bench and chatbot arena).” _신경 정보 처리 시스템 발전(Advances in Neural Information Processing Systems)_ 36 (2023): 46595-46623.
[10] Bai, Yuntao, et al. “헌법적 AI: AI 피드백을 통한 무해성(Constitutional ai: Harmlessness from ai feedback).” _arXiv 사전 공개 논문 arXiv:2212.08073_ (2022).
[11] Zheng, Lianmin, et al. “MT-벤치와 챗봇 아레나로 LLM 심사위원 평가하기(Judging llm-as-a-judge with mt-bench and chatbot arena).” _신경 정보 처리 시스템 발전(Advances in Neural Information Processing Systems)_ 36 (2023): 46595-46623.
[12] Cobbe, Karl, et al. “수학 문장제 해결을 위한 검증기 훈련(Training verifiers to solve math word problems).” _arXiv 사전 공개 논문 arXiv:2110.14168_ (2021).
[13] Ivison, Hamish, et al. “DPO와 PPO 해부하기: 선호 피드백 학습의 모범 사례 분리(Unpacking dpo and ppo: Disentangling best practices for learning from preference feedback).” _신경 정보 처리 시스템 발전(Advances in Neural Information Processing Systems)_ 37 (2024): 36602-36633.
[14] Stiennon, Nisan, et al. “인간 피드백으로 요약 학습하기(Learning to summarize with human feedback).” _신경 정보 처리 시스템 발전(Advances in Neural Information Processing Systems)_ 33 (2020): 3008-3021.
[1](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-1)
프롬프트마다 후보 완성문이 두 개보다 많을 때도 있다. 이 경우에는 선호도에 따라 완성문의 순위를 매겨 선호를 표현한다. 하지만 최근 연구에서는 이진 선호 데이터를 더 흔히 사용한다.
[2](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-2)
여기서 정책은 현재 훈련 중인 LLM을 뜻한다. 강화 학습 분야에서 사용하는 표준 용어다. 자세한 내용은 [여기](https://cameronrwolfe.substack.com/p/basics-of-reinforcement-learning)를 참고하라.
[3](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-3)
실제로 모든 채택 및 기각 시퀀스에는 프롬프트와 완성문이 모두 들어간다. 여기서는 단순화를 위해 프롬프트와 완성문의 구조가 명확히 구분되지 않는 평면적인 텍스트 시퀀스만 사용한다.
[4](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-4)
다만 LLM 훈련에는 다양한 정책 경사 알고리즘 변형을 사용한다. 예를 들어 [PPO](https://cameronrwolfe.substack.com/p/proximal-policy-optimization-ppo), [REINFORCE](https://arxiv.org/abs/2402.14740), [GRPO](https://arxiv.org/abs/2402.03300) 등이 있으며 각각 장점이 있다.
[5](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-5)
이 글을 작성할 당시 라마 3는 공개된 오픈 소스 모델 가운데 가장 우수했다.
[6](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-6)
이 벤치마크는 [데이터](https://huggingface.co/datasets/allenai/reward-bench-2), [순위표](https://huggingface.co/spaces/allenai/reward-bench), 광범위한 기술 보고서와 함께 제공된다.
[7](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-7)
데이터 오염은 나중에 같은 모델을 평가할 때 사용할 데이터가 훈련 세트에 들어 있는 현상을 뜻한다.
[8](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-8)
동점 영역을 제외한 모든 영역에서는 정확도로 성능을 측정한다. 동점 영역에서는 정답 예제와 오답 예제 사이의 점수 차이가 올바른지 확인한다.
[9](https://cameronrwolfe.substack.com/p/reward-models#footnote-anchor-9)
이는 강점이 서로 다른 여러 RM을 RL 훈련에 사용했을 때 모두 비교적 좋은 성능을 보인 [13]의 결과와 일치한다.