Metadata
# 신경망은 이미 정돈되어 있다
## 요약
신경망의 본질에 관해 좋은 소식이 있다고 생각한다.
몇 달 동안 이미지 모델과 언어 모델의 뉴런과 회로를 연구한 끝에, 나는 신경망 자체의 메커니즘이 이해 가능한 구성 요소이며 기계적 해석 가능성의 전망도 내가 우려했던 것보다 훨씬 밝을 수 있다고 믿게 됐다. 나를 포함해 이 분야의 많은 연구자가 신경망이 개념을 임의로 한데 욱여넣는다고 확신하게 만든 다의성과 중첩의 대표적 증거는 잘못 해석됐다. 임의로 욱여넣은 것처럼 보였던 현상은 대부분 내가 *재귀적 일반화(recursive generalization)*라고 부를 패턴이었고, 이는 훨씬 덜 우려스러운 현상이다. 따라서 신경망을 먼저 풀어헤치지 않고도 직접 연구할 수 있다. 신경망은 이미 정돈되어 있다.
기계적 해석 가능성에 접근하는 길은 적어도 두 가지다. 첫째는 신경망 자체를 대상으로 신속하게 [정상과학](https://en.wikipedia.org/wiki/Normal_science)을 수행하는 것이다. 뉴런과 회로를 살피고, 그 관계와 데이터 흐름을 연구하며, 에이전트를 대규모로 투입해 설명을 검증한다. 둘째는 가정한 특징의 목록에서 출발해 이를 모두 추출하려는 길이다. 이 과정에서 점점 정교한 재구성 목표를 설계하고 대개 원래 신경망은 무시한다.
이 분야는 첫 번째 길에서 출발했다. 하지만 신경망이 얽힌 매듭처럼 보이자 두 번째 길로 물러섰다. 하나의 뉴런이 서로 무관한 여러 일을 하거나 이해하기 불가능해 보이는 현상을 통틀어 *다의적 뉴런(polysemantic neuron)*이라고 하는데, 우리에게는 그 대표적 사례가 있었다. 가장 유명한 이미지 모델의 뉴런은 고양이 얼굴과 자동차 앞부분 모두에 반응했다. 초기 연구의 표준 모델이었던 인셉션V1의 마지막 층에는 임의적인 혼합이 가득한 듯했다. 거의 어느 뉴런도 쉽게 해석할 수 없어 어떻게 연구해야 할지조차 불분명했다.
다의성을 설명하는 가장 유력한 이론은 *중첩(superposition)*이었다. 이 이론은 새로운 학습 원리를 제안했다. 신경망에 뉴런이 부족해지면 관련 있는 것들을 묶는 대신, 서로 간섭하지 않는다는 이유만으로 무관한 것들을 한데 접어 넣기 시작한다는 것이다. 그 결과 일종의 매듭이 생긴다. 신경망이 거의 같은 효과를 내는 수많은 방식으로 대상을 접어 넣을 수 있으므로, 한 뉴런에 무엇이 함께 묶였는지는 거의 아무것도 알려주지 않는다. 무언가를 연구하려면 먼저 매듭을 풀어야 한다. 실제로는 희소 오토인코더 같은 분해 모델을 따로 학습시켜, 매듭이 풀린 신경망의 모습을 근사하고 그것을 연구한다. 신경망이 정말 매듭처럼 얽혀 있다면 다른 방법이 없을지도 모른다.
이 글의 주요 결론 중 하나는 인셉션V1을 설명하는 데 중첩 이론이 틀렸다는 것이다. 아키텍처의 문제 때문에 뒤쪽 층에 과부하가 걸렸다. 미흡한 해석 도구는 이 문제를 증폭해 뒤쪽 층이 앞뒤가 맞지 않는 것처럼 보이게 했다. 이후 깊은 층의 학습을 개선하려고 도입한 아키텍처 변경은 의도치 않게 해석 가능성까지 높였다. 처음 인셉션V1을 연구했을 때는 마지막 층에서 해석 가능한 뉴런을 거의 찾지 못했다. 하지만 모델 크기나 학습 데이터를 바꾸지 않고 이러한 일반적인 개선만 적용하자 마지막 층 뉴런의 99~100%를 쉽게 해석할 수 있었다. 모델 전체도 대체로 읽어낼 수 있게 됐다. 내가 대부분 이해한다고 느끼는 최초의 비자명한 신경망이며, [여기서 직접 살펴볼 수 있다](https://already-clean.goodfire.com/microscope/medium.html). 크기가 최대 300배까지 다른 버전들을 학습시켰는데 모든 규모에서 대체로 읽어낼 수 있었다. 공간이 부족해져도 신경망은 무관한 것들을 한데 접지 않는다. 하나의 자동차 뉴런이 여러 종류의 자동차를 아우르듯, 뉴런이 더 거친 수준의 개념을 다룰 뿐이다. 공간이 넉넉해지면 그 뉴런은 다양한 자동차를 구별하는 여러 뉴런으로 분화한다. 문제는 두 번째 학습 원리가 존재한다는 데 있지 않았다. 첫 번째 원리가 제대로 학습되지 않은 평범한 문제였고, 고치기도 쉽다.
시각 모델에서 다의성과 중첩을 보여준다는 대표적 사례도 잘못 해석됐다. 2019년 크리스 올라와 나는 [「회로 들여다보기」](https://distill.pub/2020/circuits/zoom-in/)에서 처음 중첩 현상으로 소개한 회로를 발견했다. 자동차 특징이 무관한 개 뉴런 여러 개로 퍼져 들어가는 듯한 회로였다. 우리가 제시한 유일한 사례였고, 내가 본 유일한 사례이기도 하다. 우리는 신경망이 자동차를 고차원 공간의 은신처에 넣어 두었다가 뒤쪽 뉴런이 다시 꺼내 쓴다고 해석했다. 하지만 그 조합을 읽어 내는 것은 아무것도 없었다. 숨겨 둔 것이 아니라 평범한 일반화와 조합이었다. 내가 아는 한, 같은 형태를 갖춘 두 번째 회로가 발표된 적은 없다.
현대의 언어 모델도 일반적인 인식보다 훨씬 해석하기 쉽다. 앤트로픽이 2023년 발표한 [「단일 의미성에 다가서기」](https://transformer-circuits.pub/2023/monosemantic-features/index.html)는 작은 단일 층 모델을 연구하면서, 뉴런의 해석 가능성을 평가한 14점 만점 기준에서 중앙값이 0점이라고 보고했다. 평가자가 어떤 가설도 세울 수 없었다는 뜻이다. 같은 해 내가 오픈AI에서 시작한 [자동 해석 가능성 프로젝트](https://openaipublic.blob.core.windows.net/neuron-explainer/paper/index.html)에서는 가장 관대한 기준으로도 해석 가능한 뉴런이 약 1.7%였다.
도구가 좋아지고 모델이 발전한 지금은 상황이 매우 다르다. 큐원3-32B를 예비 조사한 결과, 뉴런 극의 약 90%에는 주된 역할이 하나 있고, 대개 관련된 작은 곁가지가 딸려 있다고 추정한다. 약 7%에는 서로 관련된 역할 두 가지가 있으며, 아직 이해하지 못한 것은 약 2~4%뿐이다. 이 수치는 약한 활성화를 어디까지 셀지, 뉴런의 깊이와 하위 회로의 밀도를 어떻게 고려할지, 무엇을 ‘하나의 역할’로 볼지에 따라 달라진다.
약한 활성화를 어디까지 살펴볼지는 특히 중요하다. 아래에서 이를 따로 다룬다. 범위를 넓히면 뉴런을 이해할 수 있는지보다 그 뉴런에 ‘관련된 것’이 몇 가지인지가 더 크게 달라진다. 예를 들어 트럼프 뉴런의 약한 활성화에는 마가(MAGA) 모자와 그와 관련된 인물들이 들어온다. 타이타닉 뉴런에는 더 일반적인 항해 이야기나 증기기관을 비롯한 당대의 기술이 들어온다.
활성화의 백분위수를 볼 것인지, 가장 강한 활성화에 대한 비율을 볼 것인지도 문제다. 나는 대체로 뉴런이 학습한 바를, 자연스러운 희소성과 활성화 범위까지 포함해 신뢰해야 한다고 생각한다. 예전에는 대부분 그렇게 생각하지 않았다! 모든 뉴런을 한 기준으로 표준화하려는 시도에는 다소 반대한다. 오늘날에는 백분위수를 더 흔히 쓰는데, 이해하기 쉽기 때문인 듯하다.
반대 방향의 오류도 있다. 타이타닉 뉴런의 ‘무관한 역할’을 들여다보면 다음에 ‘boat’가 올 것을 감지하는 경우가 많다. 도구가 문맥을 판단할 때 앞부분만 살폈기 때문에 이를 놓쳤다. 이런 ‘무관한 역할’을 자세히 조사하면 거의 언제나 이와 비슷한 사정이 드러난다. 불완전한 도구를 만드는 일은 쉽다.
결국 하나의 점수를 산출하는 일이 그리 중요하다고 생각하지 않는다. 다만 점수를 빼자 초기 검토자들은 대략적인 수치조차 없어 판단의 기준을 잡기 어렵다고 느꼈다. 내가 좀 더 면밀히 살펴본 소규모 표본에서는 강한 활성화를 기준으로 임의적인 혼합이 아닌 비율이 97%에 가깝다.
따라서 모든 것을 하나의 ‘정돈 정도’ 점수로 압축하더라도, 그 점수는 신경망이 대체로 어떤 상태에 있는지 가리키는 참고치로 받아들여야 한다. 직접 최적화할 정밀한 목표나 지나치게 고수할 기준은 아니다. 이 글은 오히려 뉴런과 회로마다 패턴, 깊이, 역할에 따라 다르게 살피며 과도한 단순화를 피하려는 시도다. 그래도 대략적인 수치는 유용할 수 있다.
밀집 모델과 전문가 혼합 모델은 대체로 비슷해 보인다. 키미 K3처럼 매개변수가 수조 개인 모델에서도 유사한 결과를 얻었으며, 자세한 내용은 함께 발표할 기술 논문에서 다룰 예정이다. 이 비율들은 고차원적인 양상을 몇 개의 숫자로 압축한 것이다. 두 언어의 밀접하게 관련된 관용구를 하나로 묶을지처럼, ‘하나의 것’에 대한 기준을 어디에 두느냐에 따라 정확한 값은 달라진다. 해석 가능성 연구에서 그 질문에 크게 좌우되는 것은 없다고 생각한다. 훨씬 중요한 것은 애초에 왜 여러 대상이 뉴런 하나를 공유하는가다.
남아 있는 다의성의 대부분은 내가 *재귀적 일반화(recursive generalization)*라고 부르는 패턴으로 보인다. 원리는 단순하다. 나뭇가지에서 잔가지가 돋듯, 뉴런이 성장하면서 곁가지가 뻗는다. 예를 들어 ‘iy’를 감지하던 뉴런이 ‘diy’를 감지하고, 이어 ‘iy’가 전혀 들어 있지 않은 ‘do it yourself’까지 감지하게 됐다. 이 아이디어는 내가 참여한 2021년 논문 [「다중양식 뉴런」](https://distill.pub/2021/multimodal-neurons/)의 잊힌 소절에 처음 등장했다. 당시에는 학습 과정에서 뉴런이 자라는 모습을 관찰하지 못했다. 이제는 관찰하기가 쉬워졌고, 내가 본 모든 곳에서 이 설명이 들어맞는다. 원래 인셉션V1조차 매듭처럼 얽힌 것은 아니었다. 여전히 뒤쪽 층이 어수선해지는 원래 아키텍처로 다시 학습시킨 뒤 가장 알아보기 어려운 뉴런의 변화를 추적했다. 그러자 이들은 주변의 타당하고 인접한 영역으로 국지적으로 지나치게 자라난 것으로 드러났다.
결국 다의성을 설명하는 이론이 두 가지 있었고, 나는 둘 다 제안하는 데 기여했다. 어떤 면에서는 정반대의 이론이다. 일반화는 비슷한 것들을 묶고, 중첩은 무관한 것들을 묶는다. 이 분야가 선택한 것은 중첩이었고 얼마 전까지 나도 그랬다. 하지만 이제는 재귀적 일반화가 기본적으로 옳았다고 생각한다. 그렇다면 학습 원리는 결국 하나다. 여전히 일반화이며, 다만 일반화가 프랙털 구조를 이룬다는 사실이 드러난 것이다. 이는 훨씬 덜 우려스럽다. 일반화로 묶인 방식에서는 배울 점이 있지만, 중첩으로 함께 놓인 두 대상에서는 배울 것이 없다. 일반화 자체가 프랙털 구조이므로 설명도 그렇게 할 수 있다. 기본적인 설명에서 시작해 더 알고 싶을 때 확대해서 들여다보면 된다. 그런 의미에서 충분히 자세히, 특히 학습 과정에서 어떻게 성장했는지 살펴보면 신경망의 거의 모든 부분을 해석할 수 있다.
왜 이전의 평가와 지금의 평가 사이에 이토록 큰 차이가 났을까? 평범한 문제 몇 가지가 겹쳤다고 생각한다. 2023년의 설명 모델은 추측과 검증을 반복하지 못했다. 도구와 평가 지표도 미흡해서, 옳은 설명이 아니라 [활성화를 모사할 수 있는 설명](https://already-clean.goodfire.com/#on-simulation-scores)에 보상을 줬다. 둘은 흔히 일치하지 않는다. 어떤 언어 뉴런 패턴을 예상해야 하는지 아무도 몰랐고, 사람들은 대체로 잘못된 대상을 찾았다. 대부분의 연구는 작거나 단순화된 모델을 사용했다. 그런 모델은 어떤 의미에서 실제로 공간이 부족했으므로 중첩이 자연스러운 설명처럼 보였다. 하지만 공간이 부족한 신경망이 학습 원리를 바꾸지는 않는다. 작은 시각 모델에서처럼 뉴런이 더 넓은 범위를 담당할 뿐이다. 넓은 범위를 담당하는 뉴런도 무엇을 찾아야 할지 알면 대개 쉽게 분석할 수 있다. 그런 지식이 없고 도구까지 초보적인 상황에서는 임의적인 혼합처럼 보인다.
해석 가능성 연구에는 놀라울 만큼 강한 추진력이 있다. 직소 퍼즐이나 십자말풀이처럼, 하나를 이해하면 시스템의 나머지 부분에 대한 가능성이 좁혀진다. 처음에는 뉴런 하나만 본다. 그것을 이해하지 못하면 다른 정보도 별 도움이 되지 않는다. 회로나 기여도 그래프도 아직 이해하지 못한 다른 뉴런을 통해 그 뉴런을 설명할 뿐이다. 그래서 시작이 어렵다. 하지만 지도가 조금씩 채워지면 뜻밖에도 일이 잘 풀린다. 뉴런이 정확히 무슨 일을 하는지 모르더라도 연결 대상, 주변 생태계, 그리고 전문가 혼합 모델이라면 해당 전문가의 전문 분야를 살펴볼 수 있다. 퍼즐 조각이 맞춰지듯 각 부분에는 단서가 여럿 딸려 있고, 그 단서들은 잘 구조화되어 실험으로 검증하기도 쉽다. 지도가 거의 비었거나 대부분 채워진 상태가 흔한 것은 놀라운 일이 아니다. 두 상태가 자연스러운 안정점이기 때문이다.
‘싼값에 산 물건이 비싼 대안보다 더 잘 작동한다는 사실을 알았을 때 느끼는 정당함’을 추적하는 뉴런을 생각해 보자. 이런 감정이나 사회적 신호를 추적하는 뉴런은 우리가 발견한 것 중에서도 가장 흔한 축에 속한다. 언어 뉴런의 패턴에 대한 지식도 없고, 주변 뉴런의 설명이 거의 없어 참고할 회로도 없는 상태에서 이 뉴런을 발견했다고 상상해 보자. 대부분의 사람과 에이전트는 뉴런이 명사를 만나면 발화해 그 명사를 감지한다고 예상하지만, 대개 그렇지 않다. 이 뉴런이 가장 강하게 발화하는 곳을 보면 서로 무관해 보이는 쉼표가 잔뜩 나온다.
이제 지도가 대부분 채워졌다고 상상해 보자. 미묘한 감정이나 사회적 맥락을 감지하는 뉴런이 많다는 사실을 안다. 그런 뉴런은 감정을 표현하는 단어 자체보다, 모델이 문장의 의미를 요약하는 쉼표 같은 문장부호나 다음 내용을 예측하는 데 그 감정이 중요해지는 지점 바로 앞 단어에서 자주 발화한다는 것도 안다. 따라서 주변 문장을 읽고, 뉴런을 강화했을 때 모델이 무엇을 쓰는지 살피는 조향 효과를 확인한다. 둘은 긴밀하게 맞아떨어진다. 뉴런이 어떻게 구성됐는지 상류를 살피고, 무슨 일을 하는지 하류를 보아도 들어맞는다. 강한 음의 활성화를 일으키는 음의 극을 확인하면 같은 신호의 미묘한 변형이나 사회적 맥락이 끝나는 순간이 나온다. 어느 매장 브랜드에 반응하는지처럼 구체적인 시험도 할 수 있다. 이런 시험 중 어느 하나라도 설명을 무너뜨릴 수 있지만, 결과는 계속 같은 방향을 가리킨다. 이 뉴런을 이해하면 더 넓은 패턴도 선명해진다. 미묘한 감정과 사회적 맥락을 감지하는 뉴런 수천 개를 살펴본 뒤에는 다음 뉴런에서 무엇을 예상할지 알게 된다. 지도를 채울수록 더 빨리 채워지는 이유 중 하나다.
도구에도 같은 원리가 적용된다. 신경망의 2%만 볼 수 있다면 도구가 어디서 고장 났는지 알 수 없다. 대부분을 볼 수 있다면 설명되지 않은 나머지 부분이 바로 그 결함을 가리킨다. 동료들과 나는 그렇게 SwiGLU 뉴런에서 이중 음수 영역을 발견했다. 우리가 아는 한 이전에는 아무도 알아채지 못한 현상이며, 여러 뉴런을 섞는 분해 방식이었다면 숨겨졌을 가능성이 크다.
현대 신경망의 나쁜 소식은 규모가 엄청나다는 것이다. 좋은 소식은 그 엄청난 규모가 도움이 된다는 점이다. 지도가 채워질수록 각각의 설명은 주변의 모든 것에 의해 엄격하게 제약된다. 또한 큰 모델일수록 처음부터 알아보기 쉬운, 더 좁은 범위의 뉴런을 학습한다.
그런 의미에서 가장 관심 있는 부분만 이해하기보다 신경망 전체를 이해하는 편이 더 쉬울 수 있다. 첫째, 신경망을 자세히 연구하지 않고서는 신경망처럼 생각하는 법을 알기 어렵다. 예를 들어 ‘기만’은 출발점으로 유용한 틀이지만, 모델의 기만적 행동에 기여하는 구성 요소에는 정렬과 관련된 미세 구조가 있을 것이다. 직접 들여다보지 않으면 이를 알기 어렵다. 둘째, 소수의 메커니즘만 겨냥하는 것은 거의 빈 십자말풀이의 한 줄만 푸는 것과 같다. 가능하고 성공할 수도 있지만, 교차하는 단어가 없으면 정답인지 판단하기 어렵다. 전체를 풀거나, 적어도 해당 메커니즘과 연결된 신경망의 더 넓은 부분을 푸는 편이 쉬울 수 있다.
현대 합성곱 신경망에 이 과정을 적용했을 때는 대체로 잘 작동했다. 에이전트는 뉴런과 회로의 지도를 만들고, 탐색 가능한 현미경을 구축해 살펴보고, 설명을 철저히 시험하며, 수십만 개의 기여도 그래프를 추적할 수 있다. 신속한 [정상과학](https://en.wikipedia.org/wiki/Normal_science)이 막히는 지점은 한 번도 없었다. 이제 나는 이 모델들을 기본적으로 이해한다고 느낀다. 적어도 어떤 질문이 생겨도 어디서부터 물어야 할지는 안다. 결국 십자말풀이가 채워진 것이다. 지금까지는 매개변수가 수조 개인 언어 모델에서도 통했다. 크기가 워낙 커서 해석을 끝내려면 한참 멀었지만, 이 과정을 확대할 수 있으리라고 낙관한다.
이 모든 경험으로 나는 오래된 희망으로 돌아왔다. 신경망을 먼저 고치거나 풀어헤치려 하지 않고, 메커니즘과 그 사이를 흐르는 데이터를 연구해 직접 이해할 수 있다는 희망이다. 논지를 종합하면 네 단계다.
1. 신경망은 두 가지가 아니라 하나의 학습 원리를 따른다. 모든 곳에서 그렇지 않더라도 연구에 지장을 주지 않을 만큼 거의 모든 곳에서 그렇다. 따라서 신경망 자체에 대한 통상적인 과학 연구를 시작하는 데 장애물이 없다.
2. 현대 모델과 도구를 쓰면 그 연구는 대부분의 예상보다 훨씬 잘 진행된다.
3. 이해는 축적되므로 지도가 채워질수록 연구가 쉬워진다. 따라서 최소한 신경망 자체의 메커니즘은 연구 도구에 포함되어야 한다.
4. 매우 추측적인 전망이지만, 이것만으로도 필요한 것의 대부분을 얻을 수 있을지 모른다. 해석 가능성 연구는 우리가 가정했던 것보다 훨씬, 어쩌면 가까운 미래에 충분히 다룰 수 있는 문제일지도 모른다.
딥러닝 전반에서 나타난 양상도 이와 같다. 터무니없는 규모로 확장한 단순한 방식이 영리한 방식을 이긴다. 리치 서턴은 이를 [‘씁쓸한 교훈’](http://www.incompleteideas.net/IncIdeas/BitterLesson.html)이라고 불렀다. 해석 가능성에도 씁쓸한 교훈이 있을지 모른다. 영리한 새 분해법을 설계하는 것보다 통상적인 탐구를 확장하는 편이 낫다는 것이다.
함께 발표할 기술 논문에서는 언어 모델 뉴런 실험을 더 자세히 설명할 예정이다. 현대 모델의 여러 비선형성이 보이는 작동 영역과 깊이에 따라 나타나는 회로 패턴 등이 그 내용이다. 이 글에서는 여러 지점을 훑으며 그 모든 것이 가리키는 방향을 추측한다.
## 자동차와 동물
가장 유명한 다의적 뉴런은 인셉션V1의 4e:55다. 고양이와 자동차가 임의로 뒤섞인 것처럼 보였다. 2017년의 [「특징 시각화」](https://distill.pub/2017/feature-visualization/)부터 [「회로 들여다보기」](https://distill.pub/2020/circuits/zoom-in/)까지, 이 분야에서 널리 읽힌 여러 논문은 이 뉴런을 뉴런이 적절한 연구 단위가 아닐 수 있다는 증거로 들었다. 내가 공동 집필한 「회로 들여다보기」에서는 이 뉴런이 “자동차와 고양이 얼굴의 공통점에 반응하는 것이 아니다”라고 단언했다. 하지만 「다중양식 뉴런」에서는 진실에 거의 다가갔다. “고양이 눈과 자동차 전조등이 비슷하게 보이기 때문일 수도 있다”며 공통 특징을 찾으려 했다. 그러나 특징 시각화에 나타난 수염과 크롬 장식을 보고 ‘진짜로 고양이 또는 자동차’라고 결론 내렸다. 공통된 형태를 찾으려 한 것은 옳았지만 일반화가 얼마나 멀리 뻗는지는 과소평가했다. 공통 특징은 V자였다. 높은 수준의 패턴 내부에서 일반화가 일어난다는 점 때문에 수염에 현혹된 듯하다. V자 뉴런은 실제로 고양이 회로의 입력을 받는다. 특징 시각화는 활성화를 높이는 것이 목적이므로 고양이 경로를 찾으면 그 경로가 가져오는 모든 것을 더한다. 뉴런이 수염을 ‘원하지’ 않아도 수염이 따라오는 것이다. 하류의 자동차 판독 뉴런도 V자 뉴런을 통해 약간의 고양이 신호를 받지만, 출력까지는 거의 전달되지 않는다. 여러 뉴런이 함께 작동하므로 고양이 감지 뉴런 하나가 발화해도 별 영향이 없고, 신경망은 이를 상쇄할 음의 가중치가 필요하지 않다. 공통 패턴을 보려면 뉴런 자체가 아니라 뉴런 입력들의 공통점을 시각화해야 한다.
정돈된 뉴런을 몇 달 동안 본 뒤, 초기의 유명한 다의성과 중첩 사례를 우리가 잘못 해석한 것은 아닐까 하는 생각이 들었다. 대표적인 다의적 뉴런은 확인해 보기 좋은 출발점이었다. 그래서 수백 번은 보았던 고양이와 자동차 이미지 격자를 다시 열고, 한 번도 해 보지 않은 일을 했다. 이것이 하나의 무엇일지 몇 초 동안 생각해 본 것이다. 거의 즉시 답이 분명해졌다. 고양이와 자동차 뉴런이 아니라 V자 형태 뉴런이었다.
회로 연결을 살폈다. V자 모양의 불꽃, 소방정에서 뿜어져 나오는 V자 물줄기, V자 모양의 여우 얼굴이 있었다. 음의 극에는 V자의 뾰족한 부분과 대조되는 둥근 O자가 있었다. 고양이와 자동차의 임의적인 혼합이라면 불꽃과 그토록 강하게 연결될 이유가 무엇인가?
입력
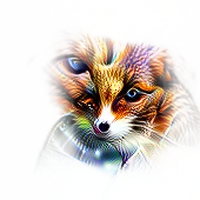
4d:493 여우 주둥이
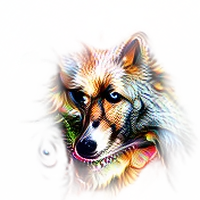
4d:477 늑대 얼굴
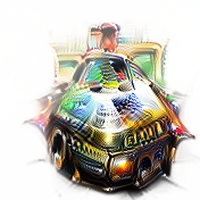
4d:201 승합차 앞부분
4e:55
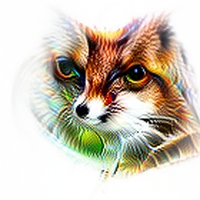**뾰족함(Pointed)**_일반형(generic)_
**둥긂(Round)**_일반형(generic)_
판독 뉴런
5a:94 불꽃
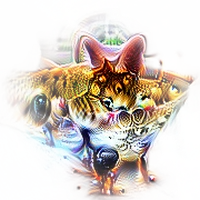
5a:352 코요테 얼굴
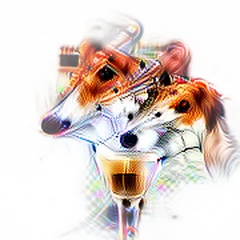
5a:317 마티니 잔
**뾰족함(Pointed)**은 발화를 일으킨다
1. 개
2. 여우
3. 고양이
4. 자동차
5. 당구대
6. 고속열차
**둥긂(Round)**은 음의 활성화를 일으킨다
1. 개
2. 개
3. 달팽이
4. 골프공
5. 테니스공
6. 시계
위에는 가장 강한 입력과 판독 뉴런을 선의 굵기로 연결 강도를 나타내고 일반형 렌더링을 함께 제시했다. 아래에는 사진마다 이 뉴런이 무엇을 보는지 나와 있다. 명칭이 무엇이든 뾰족한 것은 활성화를 높이고 둥근 것은 음의 방향으로 민다.
다음으로 2019년에 처음 발견한 대표적인 중첩 회로를 다시 살폈다. 처음 회로 인터페이스를 만들던 중 발견한 것으로, 당시 인터페이스에는 특징 시각화와 뉴런 사이의 연결 가중치만 있었다. 나는 크리스 올라에게 이 회로를 보여주며 자동차가 왜 이런 식으로 개 뉴런들에 들어가는지 물었다. 우리는 일종의 접어 넣기가 일어난다고 결론 내리고 이를 중첩이라고 불렀다. 눈에 보이는 현상을 설명하기에 직관적이어서 도구를 더 깊이 살펴보지 않았다. 그랬다면 특징 시각화의 보상 해킹을 비롯한 여러 문제를 발견했을 것이다. 고차원 공간에 놓였다는 설명은 그럴듯하게 느껴졌다. V자 뉴런과 이 회로는 「회로 들여다보기」가 제시한 두 주요 사례였다. 거의 모든 뉴런도 진지하게 살펴보면 이해할 수 있다는 이 논문의 관점이 ‘지나치게 낙관적’일 수 있음을 보여주려는 사례였다.
회로는 자동차가 서로 무관한 여러 개 뉴런으로 들어가는 것처럼 보였다. 나중에 필요할 때 자동차를 복원할 수 있도록 개 뉴런을 고차원 저장 공간으로 쓰는 듯했다.
하지만 자동차가 하고 있던 일은 그것이 아니었다. 자동차와 개가 함께 묶인 것은 자세가 비슷하기 때문이었다. 인셉션V1에는 이렇게 일반화된 자세 뉴런이 백 개 넘게 있다. 각각 자동차와 개, 그 밖의 물체가 공유하는 자세를 분명하게 감지한다. 내가 아는 한 이를 알아챈 사람은 없었다. 뒤쪽 층도 모델 끝까지 이 뉴런을 토대로 발전한다. 자동차는 정체 모를 곳에 저장되지 않았고, 그 조합을 직접 읽어 내는 것도 없다. 오히려 반대다. 뉴런은 자동차 전문가와 더 세밀한 자세로 계속 분화한다.
원인 중 하나는 일반화된 자세 뉴런을 몰랐다는 점이다. 또 하나는 이미지 아이콘을 그릴 때 사용하는 특징 시각화가 깊은 층에서 보상 해킹에 빠진다는 점이다. 이 기법의 목적은 뉴런을 최대한 활성화하는 이미지를 찾는 것이다. 하지만 경사 하강법으로 이미지를 찾으면서 가장 쉬운 경로를 택하는데, 인셉션V1에서는 그 경로가 흔히 개로 이어진다. 학습 데이터에 개가 많고 개 뉴런도 많기 때문에, 최적화 초기에 개 쪽으로 빠져든 뒤 벗어나지 못한다. 상위 이미지가 택하는 자연스러운 경로 쪽으로 아주 약하게 유도하기만 해도 대부분 자동차가 나타난다. 자세를 공유하기 때문에 개와 자동차가 함께 나타나는 경우도 있다.
우리가 생각한 모습
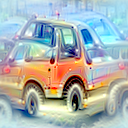
임의적인 저장 공간

실제 일어나는 일

자동차만
자동차와 개가 공유하는 자세

우리는 자동차가 개 뉴런 사이에 숨었다가 나중에 읽힌다고 생각했지만, 시각화 방식이 잘못됐다. 자동차 경로를 통해 시각화하면 둘은 자동차 뉴런이고 다른 둘은 자동차와 개가 공유하는 자세를 나타낸다.
개와 자동차가 함께 나타나는 이유는 공간이 부족하기 때문이라고 여기며 이 일반화를 가볍게 넘기고 싶을 수 있다. 신경망이 ‘정말 원한’ 것은 개의 자세 뉴런과 자동차의 자세 뉴런을 따로 두는 것이고, 더 큰 모델이라면 분리했을지도 모른다. 큰 모델일수록 좁은 범위의 뉴런이 많아지는 경향은 사실이다. 하지만 규모가 커질 때 신경망은 직관에 반하는 방식으로 변하기도 한다.
크기가 열 배 넘고 아키텍처도 약 10년 뒤에 나온 [디노v2](https://arxiv.org/abs/2304.07193)를 보면 자세 뉴런이 더 많지만, 그중 상당수는 여전히 일반화되어 있다. 규모와 관계없이 내가 살펴본 모든 시각 모델에서 이런 현상을 보았다.
디노v2: 인셉션V1의 12배
대형 콘브넥스트: 인셉션V1의 4배
중형 콘브넥스트: 인셉션V1과 같은 크기
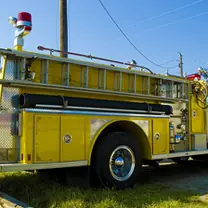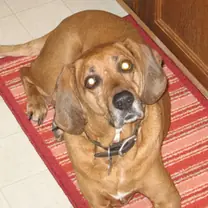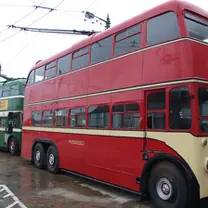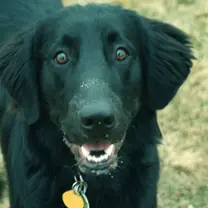
소형 콘브넥스트: 인셉션V1의 1/75 크기
디노v2와 중·대형 콘브넥스트에는 같은 뉴런이 나타난다. 카메라를 바라보는 방향에 따라 개와 차량을 묶는 뉴런이다. 가장 작은 모델에는 자세 구분 없이 자동차와 개를 함께 묶는 거친 형태만 있다.
사람과 자동 해석 시스템 모두 뉴런을 V자 같은 공통 패턴의 감지기가 아니라 고양이·자동차 같은 명사 집단의 감지기로 묘사하는 데 강한 편향이 있는 듯하다. 뉴런이 실제로 명사 집단에 반응할 때도 있다. 그러나 내 경험상 공통 패턴에 반응하는 경우가 더 많고, 뉴런을 명사보다 동사로 이해하는 편이 낫다. 뉴런의 일은 입력에 무엇이 있는지 이름 붙이는 것이 아니라 하류 뉴런이 사용할 구별을 만드는 것이다. 양의 극과 음의 극에서 미묘한 두 패턴, 여기서는 V자와 O자를 구별하고 그에 따라 활성화의 흐름을 서로 다른 뉴런 쪽으로 밀어 준다.
뉴런을 이해하기 어려울 때 나는 종종 이렇게 묻는다. 명사 집단을 전혀 사용할 수 없다면 이 뉴런을 다른 사람에게 어떻게 설명할까? 대개 공통 패턴이 곧 드러나고, 다른 명사 집단에서도 쉽게 시험할 수 있다. V자의 경우 신칸센과 당구대를 시험하면 된다. 중간 층 뉴런의 다의성을 잘못 판단하는 가장 큰 원인이 이것이라고 생각한다. 다의적이라고 설명된 뉴런 가운데 상당수는 내게 하나의 패턴을 명사 목록으로 묘사한 것처럼 보인다.
두세 가지를 뜻하는 뉴런은 몇 가지 의미를 묶은 하나의 뉴런으로 다뤄야 한다. 신경망에는 그 묶음이 문제가 아니었을 가능성이 크다. 신경망의 관점에서 의미들이 비슷하므로 함께 놓인 것이다. 따라서 묶인 방식은 신경망이 어떻게 생각하는지 알려주는 단서다. 이 단서를 따라가면 여기서 고양이와 자동차가 보여준 것처럼 우리가 몰랐던 일반화를 발견할 수 있다. 자세히 살펴보면 추가적인 의미가 사실은 사소하고 활성화도 드물어 사라지는 경우도 많다. 의미처럼 보이는 것 중에는 도구가 부정확해서 생긴 것도 있다. 이 글에서 다루는 SwiGLU의 이중 음수 영역, 잔차 스트림의 시각화를 방해하는 읽히지 않는 현저성 조절값, 앞서 본 특징 시각화의 보상 해킹이 그 예다. 원래 뉴런을 통째로 유지하면 이런 오류도 계속 드러나 수정할 수 있다. 최적화를 통해 더 깔끔한 목록을 얻었다면 이런 단서들을 많이 잃었을지도 모른다.
## 현미경 오류의 역사
내가 보기에 해석 가능성 연구의 역사는 대체로 현미경 아래의 대상이 생각보다 나았다는 사실을 알아낸 역사다. 현미경의 조정이 잘못됐을 뿐이며, 필요한 조정은 종종 아주 미묘했다.
현대 신경망 해석 가능성 연구는 뉴런이 가장 강하게 반응하는 대상을 인공 이미지로 그리는 특징 시각화에서 시작했다고 할 수 있다. 그 유명한 환각적인 그림들이다. 한동안 결과가 별로 좋지 않았다. 뉴런이 무언가를 학습했지만 명료한 것은 아니라고 결론 내려도 이상하지 않았다. 알고 보니 이 방법에는 변환에 대한 강건성이 빠져 있었다. 연구자들이 이를 추가하자 같은 뉴런에서 선명한 이미지가 나왔다.
하지만 그것만으로 모델 깊숙한 곳까지 볼 수는 없었다. 뒤쪽 층에서는 특징 시각화가 다시 무너졌다. 자동차 회로에서 본 보상 해킹과 적절하지 않았던 정규화가 원인이었다. 해결하는 데 특별한 기법은 필요하지 않았다. 합리적인 설정을 조금 섬세하게 손보자 신경망의 훨씬 깊은 곳까지 볼 수 있게 됐다. 뉴런은 그대로였고 현미경이 좋아진 것이다.
2009년 방식 2017년 방식 2026년 방식 가장 강하게 반응한 사진들 중간 층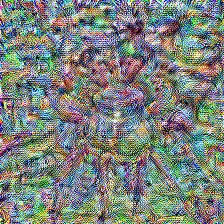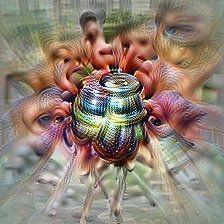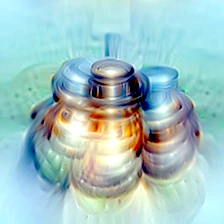
가장 강하게 반응한 사진들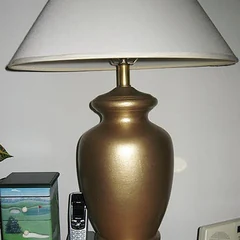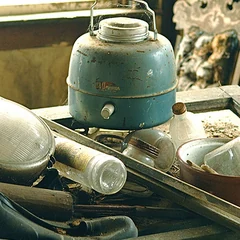
뒤쪽 층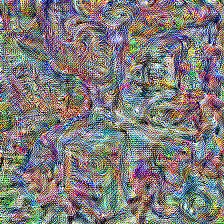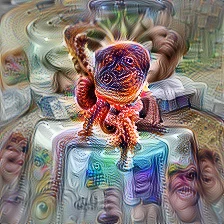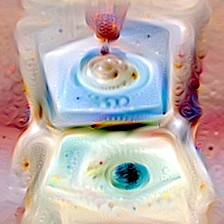
가장 강하게 반응한 사진들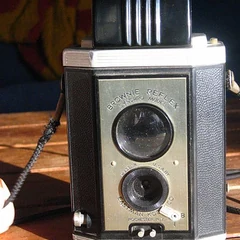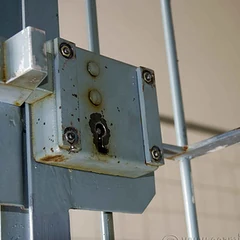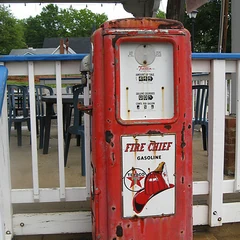
같은 인셉션V1 뉴런 두 개를 가장 강하게 반응한 사진 옆에 놓았다. 정규화를 조금씩 조정하자 중간 층 뉴런이 먼저, 뒤쪽 층 뉴런이 그다음으로 선명해졌다.
하지만 문제가 전부 현미경에만 있던 것은 아니다. 모델도 조정해야 했다. 이 분야의 초기 표준 모델인 인셉션V1의 뒤쪽 층은 전혀 해석할 수 없는 것으로 여겨졌다. [한 평가](https://livgorton.com/inceptionv1-mixed5b-sparse-autoencoders/)는 “내가 아는 한 인셉션V1의 마지막 층에는 사실상 해석 가능한 뉴런이 없다”고 했다. 내 기억과도 비슷하지만, 나는 아마 5% 정도라고 말했을 것이다. 당시에는 뉴런이 이렇게 보였다.
특징 시각화 데이터셋 예시
최적화한 이미지와 자연 이미지로 본 인셉션V1의 뒤쪽 층 뉴런.
내가 알기로 당시의 유력한 설명은 이랬다. 상위 층에서 표현해야 할 특징은 많은데 뉴런과 매개변수가 부족하다. 그래서 서로 충돌하지 않는 무관한 특징들을 임의로 욱여넣기 시작했다는 것이다. 초기 층이 단일 의미적인 이유는 표현해야 할 초기 층 특징이 그만큼 많지 않기 때문이라고 했다.
하지만 그것은 올바른 설명이 아니었다. 매개변수 수와 데이터셋은 같되 잔차 연결, 레이어 정규화와 몇 가지 개선 사항을 적용한 최신 합성곱 신경망을 보자. 마지막 층은 아름다울 만큼 명료하다.
무당벌레 · 뉴런 127
이미지 5만 장 가운데 각 뉴런이 가장 강하게 반응한 20장을 순서대로 나열했다. 다른 분류에 속한 이미지에는 분류명을 표시했다.
따라서 두 가지가 필요했다. 첫째, 신경망이 잘 학습해야 했다. 이를 위해 해석 가능성에는 관심 없이 오직 학습 성능에 집중한 사람들이 설계한 아키텍처를 사용했다. 잔차 스트림이 한 예다. 더 깊은 신경망의 학습을 돕기 위해 도입됐는데, 관련이 있을지도 모를 이유로 깊은 층의 개념도 명료하게 만드는 듯하다. 둘째, 이를 또렷이 볼 만큼 좋은 도구가 필요했다.
인셉션V1의 마지막 층은 신경망이 무관한 것들을 겹쳐 학습하므로 근본적으로 해석하기 어렵다는 주장의 핵심 증거 중 하나였다. 뉴런을 다른 단위로 대체하는 것만이 방법처럼 보였다. 당시 도구로 나는 약 5%, 다른 연구자들은 약 0%를 해석할 수 있다고 봤다. 더 나은 해석 도구, 이를테면 수정된 특징 시각화와 기여도를 시각화하는 방법을 적용하면 같은 신경망에서도 약 50%가 된다. 여기까지는 체크포인트와 학습 세부 정보가 세월 속에 사라진 2014년 모델을 사용한 결과다. 같은 아키텍처를 더 합리적인 현대식 정규화로 다시 학습시키면 약 70%가 된다. 크기가 같은 콘브넥스트에서는 약 99%다. [여기에서 살펴볼 수 있다](https://already-clean.goodfire.com/microscope/medium.html).
## 재귀적 일반화
마지막 층을 고칠 수 있다는 것은 보였다. 그렇다면 고치기 전에는 무엇을 하고 있었을까? 아키텍처를 개선하기 전에도 무언가를 임의로 묶고 있지는 않았다. 모델을 다시 학습시키면서 뉴런이 형성되는 과정을 보니, 처음에는 가끔 개가 함께 찍힌 노란 꽃 사진에 반응했다. 이후 그 사진의 여러 측면을 따라 성장했다. 다른 자연물로, 공처럼 초록색인 물체로, 꽃이 전혀 없는 사진의 개로 뻗어 갔다. 내가 살펴본 뉴런 모두가 그랬다. 개선된 아키텍처에서도 같은 패턴이 나타나지만 그 정도가 훨씬 약하다.
각 행 뒤의 회색 띠는 해당 뉴런이 가장 강하게 반응한 이미지 가운데 그 범주가 차지하는 비율이다.
같은 데이터로 학습한 인셉션V1 뉴런과 콘브넥스트 뉴런은 모두 유채밭에서 출발했다. 둘 다 초기에 공과 과일 쪽으로 뻗었다. 콘브넥스트는 그쪽을 놓고 유채밭에 머무르지만, 인셉션V1은 개와 브로콜리로 계속 퍼져 나가 결국 유채밭은 거의 남지 않는다.
우리는 이를 재귀적 일반화라고 부른다. 뉴런이 하나 이상의 축을 따라 일반화하면서, 한 축을 따라 먼저 자란 뒤 국지적으로는 쉽게 추적할 수 있는 방향으로 곁가지를 뻗는 현상이다. 그 결과 마지막에는 ‘단일 의미적’이지 않게 된다.
예를 들어 언어 모델의 한 뉴런은 ‘미야자키’ 안의 ‘iy’를 포함해 ‘iy’에 반응한다. 이어 ‘diy’에 반응하고, 마침내 ‘iy’가 전혀 없는 ‘do it yourself’에도 반응한다.
**재귀적 일반화(Recursive generalization).** ‘iy’ 뉴런은 여러 방향으로 자란다. ‘diy’에서 ‘iy’가 전혀 없는 ‘do it yourself’까지 뻗는다. 개념도다.
이미지 모델과 언어 모델 어디에나 이런 사례가 있다. 지질학 뉴런이 지질학용 자바스크립트 라이브러리인 세슘(Cesium)으로 일반화되는 것이 한 예다.
대개 무슨 일이 일어났는지 너무 뻔해서, 이를 그냥 일반적인 일반화라고 부르면 안 될 이유가 있는지 고민하게 된다. 적에 관한 러시아 시에서 발화하는 적 뉴런이 그렇다. 덜 분명하지만 그럴듯한 사례도 있다. 스리니바센 뉴런은 유니프로트 단백질 데이터베이스에도 약하게 반응한다. 이 프로젝트와 관련된 스리니바센이라는 사람이 여럿 있지만 정확한 이유는 확언하기 어렵다.
상위 8개 발화 사례
1. `String is a scalar string or 1-element string array, then STR S PLIT returns an array containing` 72
2. `determine the average of the values 0 to 9:↵SP AWN, ’test _pipe’, UNIT` 62
3. `Set this keyword to make the "Cancel" button the default selection for the dialog. The default selection` 61
4. `Stage,↵ Model Experimental Scene Mesh Primitive,↵} from "../../../Source/C esium.js";↵↵describe("Scene` 59
5. `of K REE P-rich rock at the base of the crust left by the original crystall ization of the` 54
6. `Highlands are older than the Northern Low lands, based on the larger number of impact cr aters seen covering` 54
7. `ers during their final days. The dramatic footage was taken on December 1 4,2 0` 54
8. `in the night sky, it's really easy to see the difference between the dark low land plains called` 54
상위 100개 사례를 유입 경로의 비중에 따라 묶은 결과
1. 달과 화성의 지각 44% · _L31_의 화성·행성에서 유입
2. 달 탐사 42% · _L28_의 달에서 유입
3. 오래된 충돌 흔적·화성 6% · _L30_의 다른 행성 생명체에서 유입
4. 세슘과 IDL 코드 8% · _L6_의 세슘 같은 이름에서 유입
달과 화성의 지각
고지대, 달의 앞면과 뒷면, 남극–에이킨 분지
_L31_ 화성·행성과 _L28_ 달을 통해 유입
_↑ L34_ 중국의 달 탐사 계획과 _↑ L37_ 오랜 지질학적 시간을 활성화
고지대·뒷면·충돌 흔적 쪽으로 민다
달 탐사
달 궤도를 돌며 촬영하거나 달 표면에 충돌하는 우주선
_L28_ 달과 _L7_ 초기 달을 통해 유입
_↑ L36_ 우주선·임무와 _↑ L37_ 표면 충돌을 활성화
달·뒷면·분화구·위성 쪽으로 민다
오래된 충돌 흔적·화성
헬라스, 마리네리스 협곡, 초기 지구. 발화 강도는 약하다
_L30_ 다른 행성의 생명체와 _L32_ 큰 화산을 통해 유입
평원·분지·화성 쪽으로 민다
세슘과 IDL 코드
세슘JS 지구본 라이브러리와 IDL/ENVI 이미지 처리 문서
_L6_ 세슘 같은 이름과 _L32_ 소프트웨어 문서의 숫자를 통해 유입
_↑ L37_ 자바스크립트 라이브러리를 활성화하고 _↓ L37_ 우주 뉴스를 억제
`.js` 객체·소프트웨어·시각 자료 쪽으로 민다
행성 지질학 뉴런이 가장 강하게 발화한 사례에는 달 지각과 IDL·세슘 코드가 섞여 있다. 입력을 보내는 회로별로 묶으면 행성 표면이라는 하나의 중심에서 나온 세 갈래와, 별도 경로로 들어온 코드라는 곁가지 하나로 나뉜다.
재귀적으로 일반화된 이 곁가지와 그 중요성은 [언어 모델 절](https://already-clean.goodfire.com/#language-models)에서 다시 다룬다. 여기서는 이 패턴이 무엇인지만 이야기하겠다.
우리는 [「다중양식 뉴런」](https://distill.pub/2021/multimodal-neurons/#feature-properties)에서 이를 ‘결합된 특징(conjoined features)’이라고 부르며 처음 암시했다. 재귀적 일반화를 몇 달간 연구하다가 이 분야의 유명 모델들을 다시 살펴보기 전까지는 나도 잊고 있었다. 내 기억이 맞다면 인셉션V1의 마지막 층이 왜 문제였는지 등을 설명하는 일반 이론이 될 수 있다고 제안한 사람은 나를 포함해 아무도 없었다. 당시에는 학습 체크포인트가 없어 형성 과정을 볼 수 없었지만, 설명 자체는 기본적으로 옳았다. 새 이름이 더 정확하다고 생각하는 이유는 [부록](https://already-clean.goodfire.com/#conjoined-features)에서 설명한다.
## 중첩
재귀적 일반화는 그다지 대담한 설명이 아니다. 일반적인 일반화에서 예상해야 할 현상이라고도 할 수 있다. 하지만 다의성에는 훨씬 대담한 설명, 즉 새로운 학습 원리가 제안되어 왔다.
어디에서나 확인되는 주된 학습 원리는 일반화다. 일반화에서는 발전시켜 활용하기 좋은 공통 패턴이 있기 때문에 대상들이 한곳에 모인다. 중첩에서는 무관한 대상들이 서로 간섭하지 않기 때문에 한곳에 놓인다. 두 이론의 예측은 반대다. 일반화는 가까운 대상들 사이에서 일어나야 하지만, 중첩은 아주 다른 대상들을 나란히 놓으려 할 것이므로 비국지적으로 일어나야 한다.
일반화라면 여러 각도와 유형의 조금씩 다른 축 처진 귀를 묶는 ‘귀가 축 처진 개’ 뉴런을 선호할 것이다. 중첩이라면 ‘귀가 축 처진 개 + 라틴 시’ 뉴런을 선호할 것이다.
임의로 욱여넣기
무관한 대상들이 뉴런 하나를 공유한다
일반화
비슷한 대상들이 뉴런 하나를 공유한다
뉴런
뉴런당 대상 8개
개념도다. 두 그림에 같은 대상 32개가 등장하며, 색과 형태가 비슷할수록 서로 비슷한 대상이다. 뉴런 수가 줄면 일반화하는 뉴런의 구분이 거칠어질 뿐, 조각나지는 않는다. 뉴런 위에 마우스를 올리거나 탭하면 양쪽 그림에서 그 뉴런에 속한 대상을 볼 수 있다.
여기서 정의가 뒤엉킨다. [「회로 들여다보기」](https://distill.pub/2020/circuits/zoom-in/)는 중첩과 함께 특징을 신경망의 근본 단위로 보는 관점을 도입했다. 어떤 설명을 보느냐에 따라 중첩은 ‘차원보다 특징이 많다’는 뜻이 되기도 한다. 하지만 뉴런들이 조합되는 만큼 완전히 단일 의미적인 신경망조차 이 조건을 만족한다. 다른 설명에서는 앞서 말한 학습 원리를 뜻하며, 이를 뉴런이 무엇을 학습하는지에 적용하기도 하고 특징이 어디에 놓이는지에 적용하기도 한다.
예를 들어 인셉션V1의 4b층에는 창문, 차체, 바퀴 같은 자동차 부품을 담당하는 대체로 단일 의미적인 뉴런이 있다. 다음 층은 이를 조합해 4c:447이라는 자동차 뉴런을 만든다. 특징의 관점에서는 ‘자동차 특징’이 4c:447에만 있는 것이 아니라, 이를 만드는 4b층 뉴런의 조합에도 있다고 말할 수 있다. 거의 같은 메커니즘을 공유하는 자동차 특징 두 개가 인접한 층에 있는 셈이다. ‘차원보다 특징이 많다’는 관점에서는 첫 번째는 중첩 상태이고 두 번째는 그렇지 않을 수 있다. 비공식 논문 [「분산 표현: 조합과 중첩」](https://transformer-circuits.pub/2023/superposition-composition/index.html)의 정의라면 첫 번째는 조합을 통해 분산되어 있고, 두 번째는 아예 분산되어 있지 않다. 그래서 가정된 특징을 사고의 도구로 삼기 어렵다고 느낀다. 나는 보통 뉴런처럼 구체적인 메커니즘과 구체적인 데이터를 선호한다.
즉 ‘중첩’이라는 말 자체가 여러 흔한 용법 사이에 중첩되어 있다. 우리는 뉴런 같은 메커니즘에 적용되는 학습 원리에 초점을 맞춘다. 그런 원리가 형성되는지가 해석 가능성의 전망을 좋게 볼지 나쁘게 볼지를 크게 좌우하기 때문이다. 시험하기도 비교적 쉽다. 재귀적 일반화와 중첩은 거의 정반대의 결과를 예측하며, 뉴런이 자라는 모습을 관찰하면 어느 쪽이 일어나는지 볼 수 있다.
이 글에서 중첩이라고 할 때는 이 뜻을 가리킨다. ‘차원보다 특징이 많다’는 문제는 나중에 다룬다. 나는 기본적으로 그것이 나쁜 소식이라고 생각하지 않는다.
## 설명되지 않는 틈새에 중첩을 끼워 넣기
다의성은 뉴런보다 관찰자에 대한 주장일 때가 많다. 아직 좋은 설명이 없다는 뜻이다. 그럴 만한 이유는 몇 가지다.
1. **나쁜 도구:** 렌즈나 현미경의 성능이 부족하다.
2. **나쁜 설명:** 그런 도구를 이용해 만든 설명이 부정확하다.
3. **잘못된 학습:** 아키텍처, 학습 데이터 등의 문제로 신경망이 제대로 학습하지 못했다.
4. **재귀적 일반화:** 일반화하는 과정에서 뉴런이 관련된 몇 방향으로 가지를 뻗었다.
5. **중첩:** 학습 원리가 바뀌어, 거의 충돌하지 않는 무관한 대상들을 신경망이 같은 뉴런에 욱여넣었다.
나는 여러 해 동안 중첩 이론을 확고히 믿었다. 언어 모델 뉴런을 연구하기 시작한 것도 뉴런이나 중첩에 관심이 있어서가 아니었다. 에이전트에게 연구 감각이 있는지 궁금했기 때문이다! 에이전트가 설명을 시험하면서 좋은 질문을 던지는지 보고 싶었다. 뉴런은 기준선으로 삼으려고 연구했다. 중첩된 특징의 조각들이 결국 해석 불가능한 상태로 나타날 것이라고 예상했다. 그러면 뉴런이 실제로 얼마나 명료한지에 대한 새로운 기준선을 얻고, 에이전트는 이후 더 깔끔하게 학습된 기저에서 연구를 계속할 수 있을 터였다. 하지만 그런 상황은 오지 않았다. 뉴런을 계속 조사할수록 놀라운 예측을 하고 그 예측이 들어맞는 단순한 설명으로 귀결됐다.
최첨단 언어 모델에서 대체로 ‘pr’에 반응하면서도 여러 Base64 URL 문자열과 벵골어에도 반응하는 뉴런을 발견했다. 드디어 임의적인 혼합을 찾았다고 생각했다. 하지만 URL을 디코딩하니 ‘pr’이 들어간 단어가 나왔다. 벵골어를 번역해도 ‘pr’이었다.
영어
`Please ap pr ove the pr oject pr oposal.`
Base64
`aHR0cHM6Ly9leGFtcGxlLmNvbS9wcmljaW5nL3Byb21v aHR0cHM6Ly9leGFtcGxlLm9yZy9wcmVzcy9wcmV2aWV3`
벵골어
`প্র ধান pr odhan head শিক্ষক shikkhok teacher প্র থম pr othom first প্র শ্নটিpr oshnoti question করলেন।korlen.asked`
예시: 디코딩하거나 로마자로 옮기면 잡음처럼 보이던 것도 ‘pr’로 드러난다.
밀집형 큐원 모델에서는 동료가 자동 해석 도구의 상위 k개 목록에서 ‘다의적 쉼표 뉴런’이라는 이름이 붙은 뉴런을 발견했다. 하지만 자세히 보니 전화번호, 속어, 다른 콜로라도 뉴런과의 연결을 통해 콜로라도를 추적하고 있었다. 이 뉴런을 조향하자 모델은 하이킹을 가고 싶어 했다. 쉼표는 그때까지의 콜로라도 관련 문맥을 계속 요약해 저장하는 자리였다. 일반적으로 어텐션은 문장부호에 정보를 모으는 듯하며, 우리는 이를 *요약 패턴(summary motif)*이라고 부른다. 이를 알고 나면 비슷한 뉴런을 많이 이해하기 쉬워진다.
새 직장, 새 도시, 새 임대 계약, 덴버 주소, 303 지역번호, 그린 칠리, 브롱코스의 일요일, 레드록스, 맑은 날의 신설, 새니타스 등산로, 4천 미터급 산들. 처음 세 쉼표에서는 발화하지 않지만, 덴버가 등장한 뒤에는 쉼표마다 발화하고 그린 칠리 뒤에서 가장 강해진다.
이번 주말에는 도서관에 가서 시험공부를 할 계획이다. 할머니를 찾아뵙고 정원일도 거들고 싶다.
콜로라도가 나타나기 전까지 쉼표는 반응하지 않는다. 나타난 뒤에는 맥락이 쌓일수록 밝아진다. 뉴런을 조향하면 하이킹을 계획한다.
때로는 데이터가 부족했을 뿐이다. 처음에는 긴 문맥을 포함하지 않았다. 두 문단이면 충분하다고 생각했다. 그 결과 긴 문맥에 반응하는 뉴런이 모두 다의적으로 보였다.
목요일에 우리는 역 근처의 작은 가게를 찾았다. 주인은 커피를 천천히 따르며 아들이 다니는 대학 이야기를 들려줬다.
에이전트가 본 내용
마지막 문단만 보면 커피와 대학을 담당하는 뉴런처럼 보이지만, 이유는 더 앞부분에 있다.
다른 사례에서는 어떤 것에도 강하게 발화하지 않는 뉴런이 임의적인 혼란처럼 보였다. 알고 보니 건강 관련 검색엔진 최적화 스팸 페이지에서 특정 신호를 찾고 있었다. 데이터셋을 충분히 넓히자 이해할 수 있었다.
이런 사례를 수백 건 보면서도 중첩에 대한 믿음은 흔들리지 않았다. 중첩이 있을 곳을 계속 옮겨 갔을 뿐이다. 강한 활성화가 명료하면 약한 활성화에, 뉴런의 조합에, 아직 살펴보지 않은 뉴런에 중첩이 있다고 생각했다. 어쩌면 층과 층 사이에 있을지도 모른다고 여겼다.
하지만 결국 무슨 일이 벌어지고 있는지 의문이 들었다. 이것이 극단적이고 지속적인 선택 편향이 아니라면 초기 표준 모델의 결과와 무언가 맞지 않았다. 그래서 돌아가 원래 증거를 다시 살폈고, 그 증거가 무너졌다. 이 글을 쓰게 된 계기다.
이제는 가장 급진적이고 검증하기도 어려운 중첩을 마지막 가설로 남겨 뒀어야 하는데, 처음부터 기본 가설로 삼았다고 생각한다. 중첩은 단지 이해되지 않는 것처럼 보인다. 하지만 나쁜 도구도 그렇다. 특징 시각화의 보상 해킹, 아직 성장 경로를 추적하지 못한 재귀적 일반화인 ‘iy’ 뉴런, 인셉션V1 5b층의 좋지 않은 아키텍처, 아직 이해하지 못한 고양이·자동차 일반화도 모두 이해되지 않는 것처럼 보인다.
중첩이 직관적으로 그럴듯하게 느껴졌던 것도 한몫한 듯하다. 앤트로픽의 2022년 논문 [「소프트맥스 선형 유닛」](https://transformer-circuits.pub/2022/solu/index.html)도 이렇게 말했다. “기계적 해석 가능성 연구 공동체는 중첩이 다른 설명보다 직관적으로 더 설득력 있어 보인다는 이유만으로 기본 가설로 취급하곤 하지만, 증거는 거의 없다.” 바로 다음 문장에서 논문은 자체 결과가 중첩을 뒷받침하는 중간 정도의 증거라고 한다. 논문 자체의 표현에 따르면 그 증거는 간접적이다. SoLU가 여러 뉴런에 퍼진 활성화를 억제하고, 레이어 정규화를 추가하면 성능이 회복된다. 정규화 뒤에는 뉴런의 약한 활성화가 주된 역할과 덜 관련되어 보였는데, 논문은 이를 특징들이 작은 활성화를 통해 몰래 전달되는 현상으로 해석했다. 우리는 이를 서로 무관한 대상을 뉴런 하나에 욱여넣는다는 증거보다, 분산 표현을 억제하도록 만든 아키텍처에서 관찰된 분산 표현의 증거로 읽는다. 우리가 관심 있는 의미는 전자다. 약한 활성화에서는 활성화가 약해질수록 의미가 모든 방향으로 동시에 바뀌므로, 오늘날의 도구로도 둘을 구분하기 어렵다. 2022년에는 우리 모두에게 더 어려웠다. 논문은 중첩에 관한 자체 논의가 이후의 「중첩의 장난감 모델」로 대체됐다고도 밝힌다. 이 글의 부록에서 그 논문을 다룬다. 여기서 두 논문을 언급하는 것은 비판하려는 뜻이 아니다. 실제 신경망에서 얻은 증거가 얼마나 적은지 분명히 말한 사례로 우리가 아는 유일한 곳이기 때문이다. 아직도 많은 사람이 실제보다 증거가 많다고 가정하는 듯하다. 내가 아는 한 내가 처음 발견했다가 잘못 해석한 회로 이후 실제 신경망에서 중첩 회로를 발견한 사람은 없다. 그럴 것이라고 예상했지만 실제 모델에서 비슷한 것을 보지 못했다. 중첩은 워낙 급진적인 설명이고, 사실이라면 신경망 연구 방식에 엄청나게 나쁜 소식이므로 주장하려면 높은 수준의 증거가 필요하다고 생각한다.
물론 반대 방향의 오류, 즉 모든 뉴런에 그럴듯한 설명이 반드시 있다고 가정하는 위험도 있다. 그래도 크게 걱정하지 않는 이유는 두 가지다. 첫째, 다른 원인들은 각각 시험할 수 있다. 도구를 개선하면 뉴런이 설명되거나 그렇지 않다. 더 좋은 아키텍처로 다시 학습시키면 학습이 문제였는지 알 수 있다. 재귀적 일반화는 작은 단계로 자라는 모습을 지켜볼 수 있다. 중첩의 유일한 증상은 무언가 이해되지 않는다는 것이다. 둘째, 진짜 설명은 대체로 범위가 좁고 시험하기 쉽다. 어떤 뉴런이 콜로라도 뉴런이라고 의심되면 조향해서 무슨 말을 하는지 보면 된다. 좁은 범위의 드라마 관습에 반응한다면 그 설명에 해당할 수 있는 대상은 극히 적다. 반면 ‘이해되지 않는 무언가’는 그 밖의 모든 것을 포괄한다.
없는 설명을 억지로 만들어 낼 필요도 없다. 뉴런이 서로 무관한 일을 두어 가지 하는 듯하지만 확신할 수 없다면 그대로 말하면 된다. 다만 재귀적 일반화는 우선 의심할 만한 원인이고, 학습 체크포인트가 있으면 확인하기도 쉽다. 이제 중첩은 의심할 원인 목록의 한참 뒤에 두어야 한다고 생각한다.