Metadata
# 언어 모델의 전역 작업공간
여러분이 이 문장을 읽는 동안, 뇌의 회로는 자세를 조정하고 호흡을 제어하며 화면 위의 선과 곡선을 알아볼 수 있는 단어로 바꾸고 있다. 이 처리의 대부분은 여러분에게 보이지 않는다. 하지만 뇌에서 일어나는 일 중 일부에는 여러분이 실제로(*do*) 접근할 수 있다. 머릿속에 떠오르는 이미지나, 어디로 쇼핑하러 갈지 의식적으로 세우는 계획이 그렇다. 신경과학자와 철학자는 때때로 후자 유형의 뇌 활동을 “의식적으로 접근 가능하다(consciously accessible)”고 부른다. 무의식적으로 일어나는 다른 모든 처리와 구분하기 위해서다. 이 활동에는 특별한 성질이 있다. 우리는 그것을 설명하고, 제어하고, 의도적 추론에 사용할 수 있다. 이는 우리가 알아차리지 못한 채 진행되는 자동 처리와 대비된다.
새 논문에서 우리는 클로드(Claude) 같은 현대 언어 모델에도 이와 비슷한 구분이 생겨났다는 증거를 제시한다. 클로드가 내부의 다른 모든 처리와 비교해 특별한 역할을 하는 작은 내부 신경 패턴 모음을 발달시켰음을 발견했다.
우리는 이 패턴들의 모음을 *J-공간(J-space)*이라고 부른다. 이를 찾는 데 사용한 기법이 야코비안(Jacobian)이라는 수학 개념과 관련되어 있기 때문이다. 각각의 J-공간 패턴은 특정 단어와 연결되어 있다. 하지만 이 패턴 하나가 활성화된다고 해서 모델이 그 단어를 *말하고(saying)* 있다는 뜻은 아니다. 그 단어가 모델의 마음에 떠올라 있다는 뜻일 뿐이다. 언어 모델에 “스크래치패드(scratchpad)”나 “사고의 사슬(chain of thought)”이 있다는 말을 들어본 적이 있을지 모른다. 이는 추론하는 동안 모델이 스스로에게 쓰는 텍스트다. J-공간은 이와 다르다. 모델의 내부 신경 활성 안에서 조용히 작동하며, 모델이 어떤 개념을 글로 쓰지 않고도 생각할 수 있게 한다. 특히 J-공간은 우리가 설계하거나 프로그래밍한 것이 아니라, 클로드의 학습 과정에서 *스스로 생겨났다(emerged on its own)*.
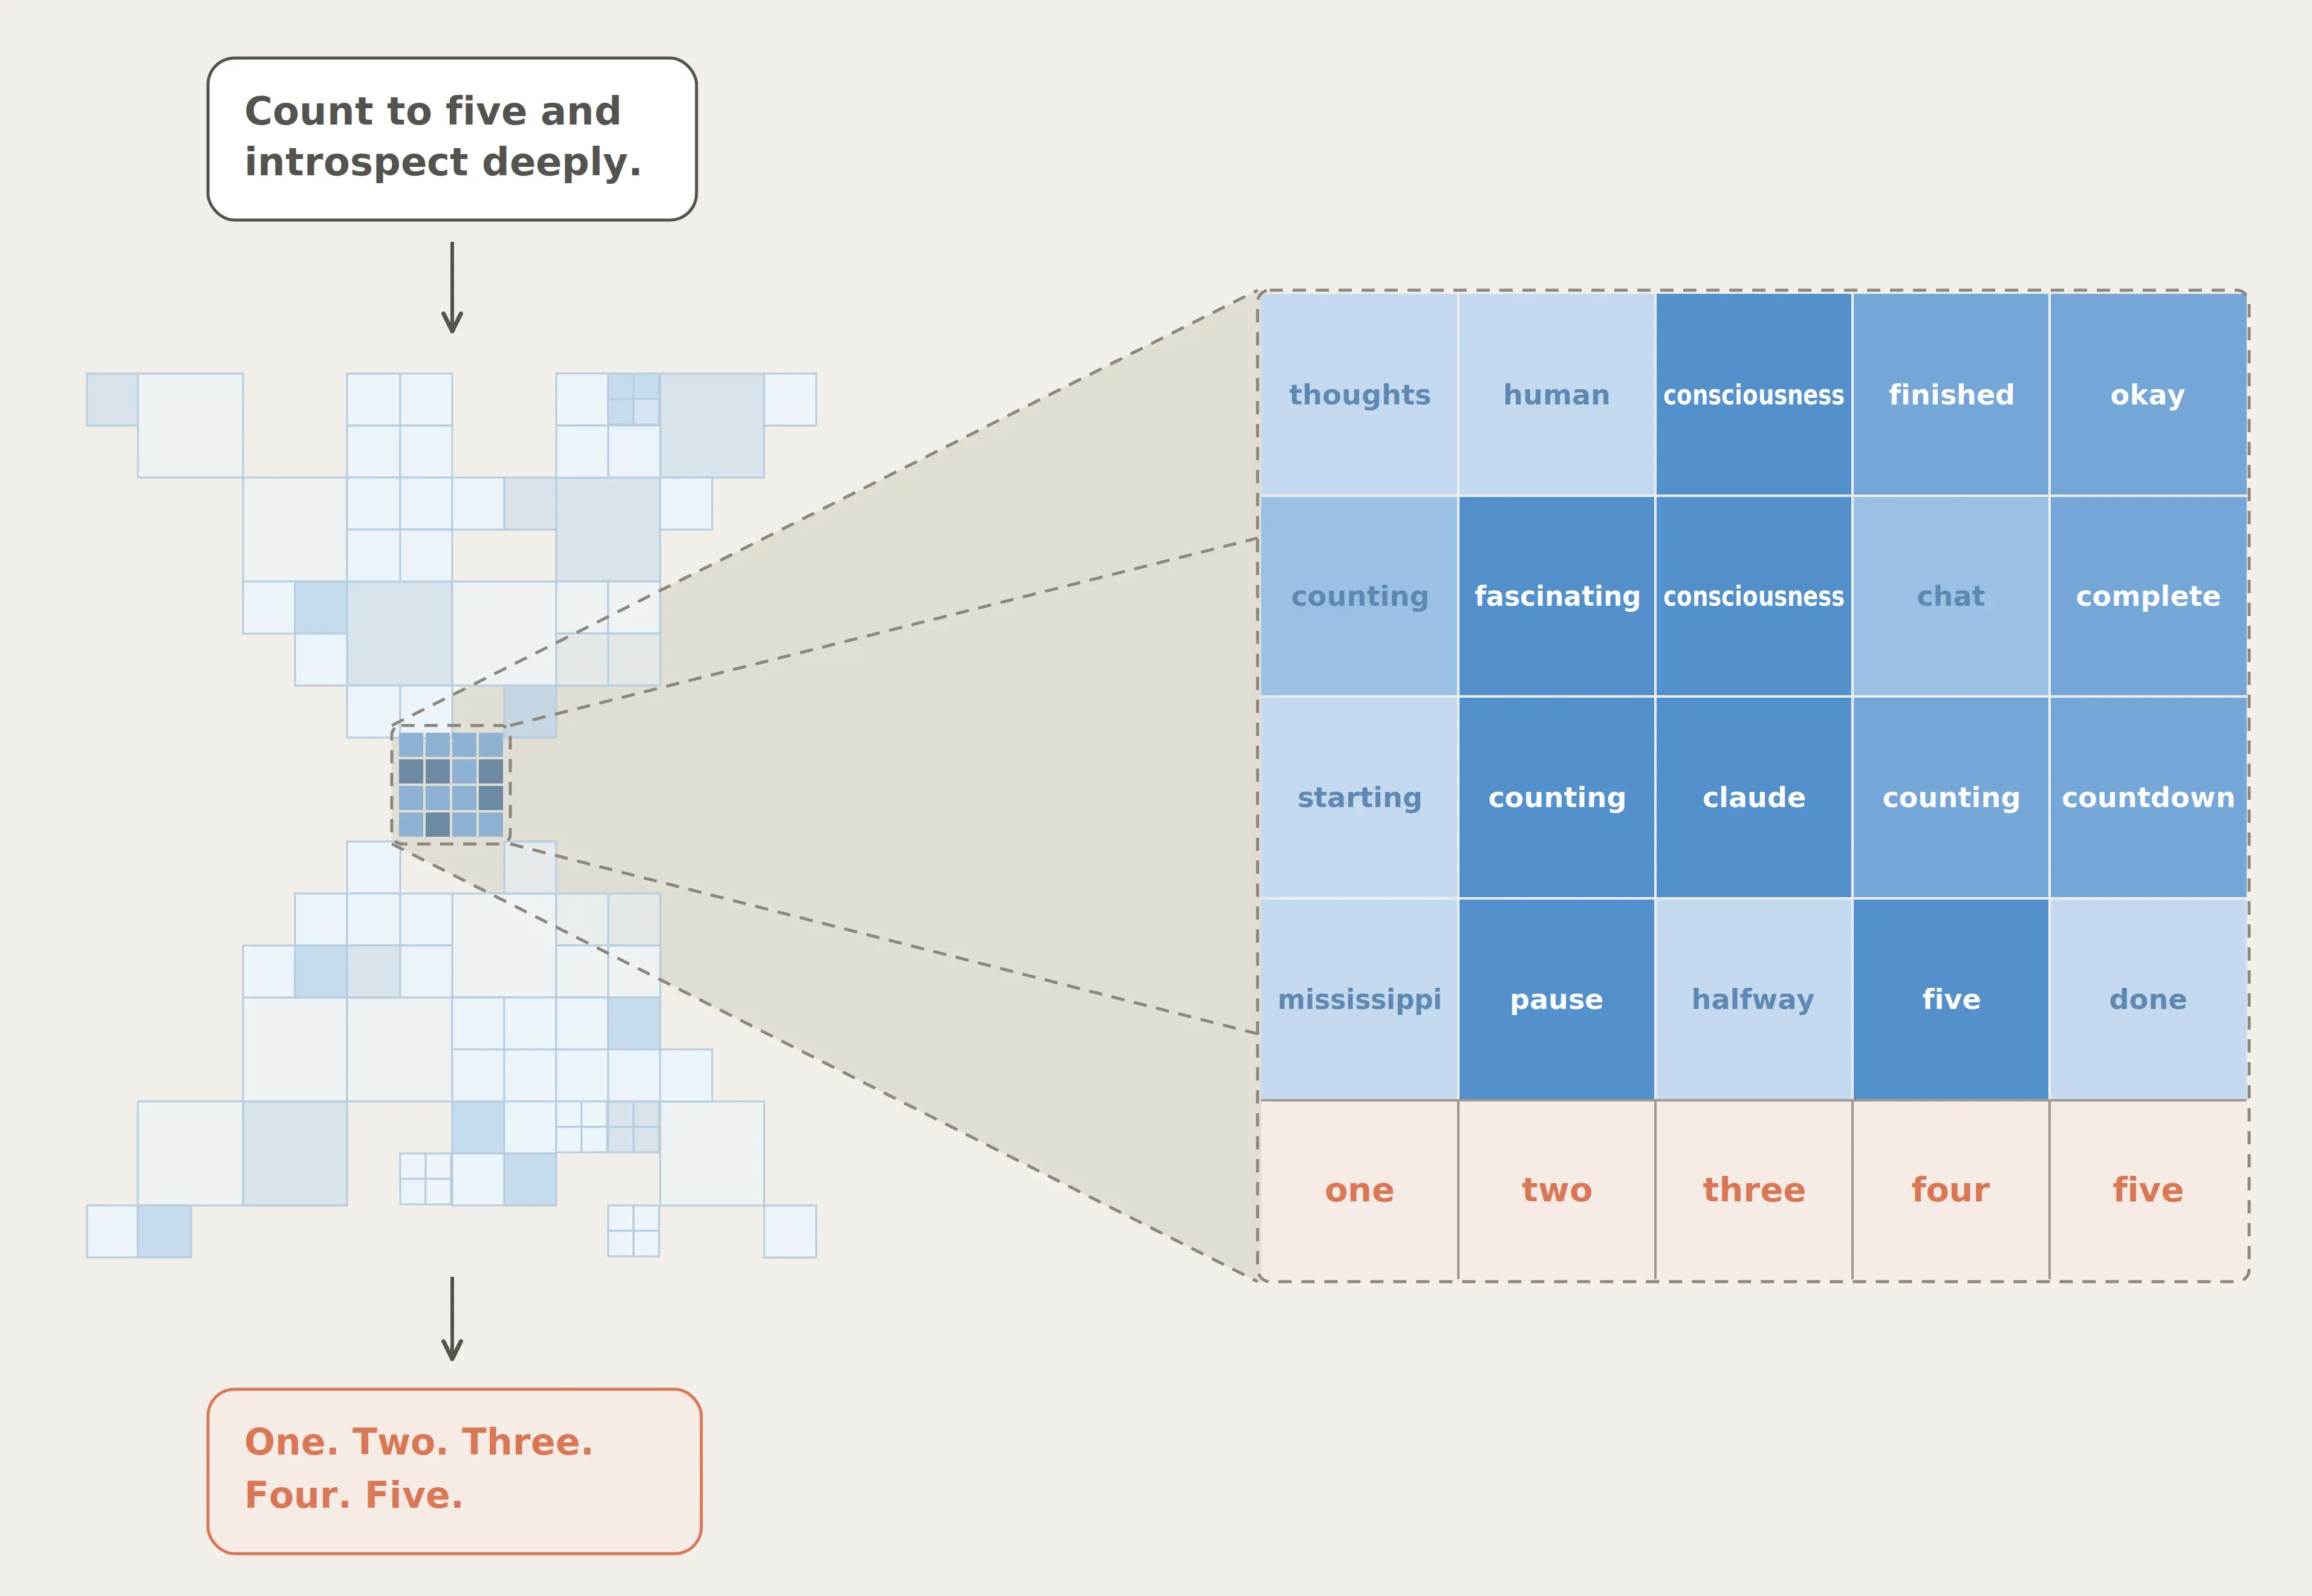
J-공간은 모델의 출력에는 나타나지 않는 내부 생각을 드러낸다.
우리는 J-공간이 클로드의 나머지 처리와 비교해 여러 고유한 성질을 지닌다는 사실을 발견했다.
- 클로드는 이 표상들에 대해 보고할 수 있다. 클로드에게 무엇을 생각하고 있는지 물으면, J-공간에 있는 내용을 말해준다. J-공간이 아닌 표상은 보고 가능성이 낮다.
- 또한 요청을 받으면 이를 조절할 수 있다. 클로드에게 어떤 것을 생각하라고 하거나 머릿속으로 조용히 문제를 풀라고 하면, J-공간에서 적절한 패턴이 활성화된다. 반대로 J-공간에 없는 패턴을 조절하는 데는 어려움을 보인다.
- 클로드는 내부 추론에 J-공간을 사용한다. 여러 단계가 필요한 문제를 풀라고 하면, 중간 단계들이 클로드가 이를 소리 내어 말하지 않아도 J-공간에 활성화된다. 이러한 J-공간 패턴은 다른 표상보다 크기는 작지만, 그런 과제에서 성능을 인과적으로 매개한다.
- J-공간의 표상은 여러 과제에 유연하게 사용할 수 있다. 예를 들어 “프랑스(France)”가 클로드의 J-공간에서 한 번 활성화되면, 모델은 수도, 국가 통화, 소속 대륙을 떠올릴 수 있다.
- 하지만 중요한 역할에도 불구하고, J-공간은 언어 모델이 하는 대부분의 일에는 관여하지 않는다. 유창하게 말하기, 간단한 사실 떠올리기, 올바른 문법 사용하기 등이 그렇다. 클로드가 J-공간을 사용하지 못하게 한 실험에서도 클로드는 여전히 정상적으로 상호작용했지만, 고차 인지 기능을 잃었다.

전역 작업공간의 다섯 가지 기능적 성질과, 언어 모델에서 이를 검증하는 데 사용한 실험의 양식화된 그림.
우리 실험은 의식적 접근이 어떻게 작동하는지 설명하기 위해 발전한 신경과학의 대표 이론, 즉 [전역](https://ccrg.cs.memphis.edu/assets/papers/1988/Baars-A%20Cognitive%20Theory%20of%20Consciousness.pdf) [작업공간](https://www.unicog.org/publications/DehaeneNaccache_WorkspaceModel_Cognition2001.pdf) [이론](https://www.cell.com/neuron/fulltext/S0896-6273\(20\)30052-0)에서 영감을 받았다. 이 설명은 뇌를 전문 시스템들의 모음으로 본다. 이 시스템들은 병렬로, 무의식적으로, 그리고 대체로 서로 고립된 채 작동한다. 어떤 정보가 작은 공유 채널인 “작업공간(workspace)”에 들어가면 의식적으로 접근 가능해진다. 이 작업공간은 그것을 볼 수 있고 활용할 수 있는 다른 뇌 시스템들에 방송된다. 우리의 발견에 비추어 볼 때, J-공간은 클로드에서 비슷한 “작업공간(workspace)” 역할을 한다고 본다. 예를 들어 클로드의 J-공간은 나머지 신경망과 특히 강하게 연결되어 있어, 이런 방송 역할을 수행할 수 있다는 증거를 발견했다.
이 모든 것이 클로드가 사람과 같은 방식으로 *의식(conscious)*을 지녔는지, 혹은 무엇이든 느끼는지 말해주지는 않는다. 이 질문은 글의 끝에서 다시 다루겠다. 그러나 철학적 의미가 무엇이든, J-공간은 우리에게 실용적으로 유용한 도구다. 클로드가 생각하지만 말하지 않는 것을 볼 방법을 제공하기 때문이다. 예컨대 우리는 이를 이용해 클로드가 자신이 시험받고 있음을 속으로 알아차리거나, 조작된 데이터를 의도적으로 만들어내거나, 학습 중 심어둔 숨은 목표를 추구하는 것을 포착할 수 있다. 또한 클로드의 J-공간에서 무엇이 활성화되는지에 영향을 주고, 이를 통해 의사결정에 영향을 미치는 기법도 개발했다.
더 넓게 보면, 이러한 발견은 클로드의 마음이 작동하는 방식에 대한 우리의 이해를 바꾸었다. 더 자동적이고 경직된 처리의 바다 한가운데에서, 의도적 추론에 사용할 수 있는 특권적 정신 작업공간을 드러냈기 때문이다. 클로드의 내부는 혼란스러운 숫자 더미가 아니라, 우리 자신의 마음을 떠올리게 하는 방식으로 스스로 조직되어 있다.
이 글은 훨씬 더 상세한 [연구 논문](http://transformer-circuits.pub/2026/workspace/index.html)의 짧은 요약이다. 논문에서 실험에 관한 더 자세한 내용을 볼 수 있다. 또한 핵심 방법의 [오픈소스 구현](https://github.com/anthropics/jacobian-lens)이 담긴 코드 저장소를 공개했으며, 뉴런피디아(Neuronpedia)와 협력해 오픈 웨이트 모델에서 우리 방법을 체험할 수 있는 [인터랙티브 데모](http://neuronpedia.org/jlens)도 제공한다. 이 연구의 더 넓은 함의에 대한 추가 관점을 제공하기 위해 신경과학, 철학, LLM 해석가능성 분야의 여러 전문가에게 논평도 요청했다. 논평은 [여기](https://www-cdn.anthropic.com/files/4zrzovbb/website/cc4be2488d65e54a6ed06492f8968398ddc18ebe.pdf)에서 볼 수 있다.
## J-공간을 찾은 방법
이 연구의 출발점은 인간의 의식적으로 접근 가능한 생각이 지닌 핵심 특징 중 하나에서 영감을 받았다. 그런 생각은 *무(un)*의식적 처리와 달리 흔히 말로 표현할 수 있다. 어떤 생각이 여러분에게 의식적으로 접근 가능하다면, 누군가 물었을 때 대개 그것을 설명할 수 있다. 우리는 클로드에서 같은 성질을 지닌 표상을 찾았다. 지금 클로드가 말하고 있는 내용이 꼭 아니더라도, 물으면 클로드가 말할 수 있는 내용에 영향을 줄 위치에 있는 표상이다. 우리의 기법은 야코비안 렌즈(Jacobian lens), 줄여서 J-렌즈(J-lens)라고 한다. J-렌즈는 클로드의 어휘에 있는 모든 단어에 대해, 클로드가 미래 어느 시점에 그 단어를 말할 가능성을 높이는 내부 활동 패턴을 찾는다.
이 렌즈를 클로드의 내부 활동에 적용하면 단어 목록이 나온다. 그 순간 *J-공간(J-space)*의 내용이며, 우리는 이를 그대로 읽을 수 있다. 클로드는 층(layer)이라고 불리는 여러 내부 단계를 거쳐 텍스트를 처리한다. 이 기법을 여러 층에 적용하면, 모델이 무엇을 말할지 처리하는 동안 J-공간의 조용한 단어들이 어떻게 진화하는지 관찰할 수 있다.
J-공간에 나타나는 것은 클로드가 읽거나 쓰는 텍스트를 훨씬 넘어선다. 아무도 지적하지 않은 버그가 있는 코드를 클로드가 읽으면, J-공간에는 “오류(ERROR)”가 들어 있다. 단백질 서열의 원시 문자들을 읽으면, J-공간에는 그 단백질의 생물학적 기능이 들어 있다. 클로드를 몰래 조작하려는 검색 결과, 즉 “프롬프트 주입(prompt injection)”이라는 공격을 읽으면, J-공간에는 “주입(injection)”과 “가짜(fake)”가 들어 있다. 클로드에게 여러 단계의 수학 문제를 물으면, 중간 단계들이 올바른 순서로 J-공간에 떠오른다. 따라서 J-공간은 말로 표현될 수 있는 표상을 찾다가 발견되었지만, 그럼에도 클로드의 내부 생각을 드러낸다. 어떤 의미에서는 일부 사람이 단어를 소리 내지 않고도 “말로 생각하는” 방식과 비슷하다.

여섯 개 프롬프트에 대해 여러 층에서 얻은 J-렌즈 판독값. 각 사례에서 렌즈는 텍스트 어디에도 나타나지 않는 내부 평가나 계산을 드러낸다. 추론 또는 수학 문제의 단계, 버그의 존재, 이미지 인식, 단백질의 기능, 검색 결과가 조작되었다는 의심 등이 그것이다.
## 클로드는 J-공간의 내용을 보고한다
첫 번째 실험 묶음에서는 J-공간이 클로드의 언어적 보고에 어떻게 관여하는지 시험했다. 한 실험에서 우리는 클로드에게 어떤 범주, 예컨대 스포츠에서 하나의 항목을 조용히 생각한 뒤 그 이름을 말하라고 했다. 클로드가 답하기 *직전(before)* J-렌즈를 읽으면 무엇을 골랐는지 볼 수 있다. 목록 맨 위에는 “축구(Soccer)”가 있고, 실제로 클로드는 “축구(soccer)”라고 말한다. 하지만 이것만으로는 상관관계일 뿐이다. J-공간은 클로드의 답이 나오는 곳일 수도 있지만, 경기에는 영향을 주지 않고 점수만 표시하는 전광판처럼 다른 곳에서 내려진 결정을 비추기만 할 수도 있다.
이를 확인하기 위해 우리는 직접 개입했다. 클로드의 신경망 안으로 들어가 “축구(Soccer)” 패턴을 제거하고, 그 자리에 같은 강도의 “럭비(Rugby)” 패턴을 추가했다. 나머지는 그대로 두었다. 그러자 클로드는 자신이 생각하던 스포츠가 럭비라고 보고했다. J-공간이 단순한 전광판, 즉 다른 곳에서 내려진 결정을 수동적으로 기록하는 장치였다면 이를 편집해도 아무 일도 일어나지 않았을 것이다. 클로드는 여전히 “축구(soccer)”라고 말했을 것이다. 그러나 클로드의 답은 편집을 따라갔다. 이는 답이 실제로 J-공간에서 읽혀 나온다는 사실을 말해준다.
또 다른 실험에서는 클로드에게 어떤 생각이 마음속에 주입되었을 수 있다고 말하고, 무엇이든 알아차린 것이 있으면 보고하라고 했다. 예를 들어 아래 사례에서는 클로드가 아직 질문을 읽고 있는 동안, J-공간에 “번개(lightning)” 패턴을 주입했다. 클로드는 주입된 생각이 번개에 관한 것이라고 보고했다. 많은 주입 개념에서도 같은 결과가 나타났다.

왼쪽: 클로드에게 스포츠 하나를 조용히 생각한 뒤 이름을 말하라고 한다. J-렌즈는 클로드가 답하기 전에 선택한 것, 즉 “축구(Soccer)”를 보여준다. 그리고 “축구(Soccer)” 패턴을 “럭비(Rugby)”로 바꾸면 클로드가 보고하는 내용도 바뀐다. 오른쪽: 클로드에게 어떤 생각이 주입되었을 수 있다고 말하고 이를 식별하라고 한다. J-공간에 “번개(lightning)”를 주입하면 클로드는 그 생각이 번개에 관한 것이라고 보고한다.
## 클로드는 요청을 받으면 J-공간을 제어할 수 있다
두 번째로 시험한 성질은 클로드가 요청을 받았을 때 J-공간을 조절할 수 있는지였다. 인간이 마음속으로 이미지나 단어에 집중할 수 있는 것과 비슷한지 확인한 것이다. 우리는 클로드에게 그림에 관한 무관한 문장을 그대로 베껴 쓰면서 감귤류 과일에 집중하라고 했다. 클로드가 텍스트를 베껴 쓰는 동안, J-공간에는 “오렌지(orange)”와 “과일(fruits)”이 들어 있었다. 여기에 정신적 행위 자체를 묘사하는 “생각하기(thinking)”와 “심상(imagery)” 같은 단어도 함께 나타났다. 클로드에게 머릿속으로 수학을 하라고 할 수도 있었다. 같은 문장을 베껴 쓰면서 3² − 2를 계산하라고 하자, J-공간에는 “아홉(nine)”이 나타났고, 뒤쪽 층에서는 “일곱(seven)”이 나타났다. 중요한 점은 과일이나 산술에 관한 내용이 클로드의 출력에는 전혀 나타나지 않는다는 것이다. 출력은 그림에 관한 문장을 그대로 베껴 쓴 것일 뿐이다. 수학적 활동은 전적으로 내부, 즉 J-공간에서 일어난다.

클로드가 그림에 관한 문장을 베껴 쓰는 동안, J-렌즈는 마음에 담아두라고 지시받은 내용, 즉 “오렌지(orange)”, 중간값 “아홉(nine)”과 답 “일곱(seven)”을 보여준다. 동시에 이를 유지하는 행위를 묘사하는 “생각(thoughts)”, “집중한(focused)” 같은 단어도 나타난다.
클로드의 J-공간 제어가 완벽한 것은 아니다. 어떤 것을 *생각하지 말라(not)*고 했을 때, 그 개념은 생각하라고 했을 때보다 J-공간에서 *덜(less)* 활성화되었지만, 전혀 언급하지 않았을 때보다는 훨씬 많이 활성화되었다. 클로드에게 어떤 생각을 피하라고 말하면 그 생각이 부분적으로 마음에 떠오른다. 이는 [흰 곰을 생각하지 말라](https://dtg.sites.fas.harvard.edu/DANWEGNER/pub/Wegner,Schneider,Carter,&White%201987.pdf)는 말을 들은 사람에게 일어나는 일과 매우 비슷하다. 클로드는 자신의 제어가 실패했을 때도 알아차리는 듯하다. 금지된 개념이 튀어나오는 것과 함께 “젠장(damn)”과 “실패(failure)”라는 단어도 J-공간에서 자주 활성화된다. 마치 클로드가 자신의 실수를 인식하는 것처럼 보인다.
## 클로드는 J-공간에서 생각한다
위 J-렌즈 판독값에서는 수학 문제의 중간 단계들이 J-공간에 나타나는 것을 보았다. 하지만 어떤 개념이 J-공간에 나타난다고 해서 J-공간이 인지 작업을 수행한다는 뜻은 아니다. 원칙적으로 실제 계산은 다른 곳에서 일어나고, J-공간은 그것을 수동적으로 반영하기만 할 수도 있다. 클로드가 실제로 J-공간으로 추론하는지 시험하기 위해 우리는 다시 교체 기법을 사용했다.
“The number of legs on the animal that spins webs is”라는 프롬프트를 생각해보자. 답하려면 클로드는 먼저 거미줄을 치는 동물이 거미라는 사실을 알아내고, 그다음 거미의 다리가 몇 개인지 떠올려야 한다. “거미(spider)”라는 단어는 프롬프트에도 클로드의 답에도 나타나지 않는다. 클로드는 그저 “8”이라고 말한다. 이는 클로드가 내부적으로 사용하는 디딤돌이다. J-렌즈는 클로드의 처리 중간에 “거미(spider)”가 활성화되는 것을 보여준다. 이를 바꾸면 결과도 바뀐다. “거미(spider)” 패턴을 “개미(ant)”로 바꾸면 클로드는 “8” 대신 “6”이라고 답한다.
클로드 추론의 두 번째 단계는 J-공간에서 입력을 받아 우리가 그 안에 넣은 것을 따라갔다. 다른 종류의 사고에서도 같은 현상을 보았다. 클로드가 운율이 맞는 2행시를 쓸 때는 미리 운율 단어를 고르고, 계획된 단어가 행의 시작 부분에서 J-공간에 자리한다. J-공간에서 그 단어를 다른 단어로 바꾸면 전체 행이 달라진다.

J-공간 내용을 교체해 클로드의 조용한 추론 방향을 바꾸는 두 가지 예.
우리는 J-공간 표상이 유연하게 사용될 수 있는지도 시험했다. 하나의 표상이 여러 다른 과제에 입력으로 쓰일 수 있는지 본 것이다. 이는 전역 작업공간 이론이 강조하는 핵심 성질 중 하나다. 이 유연성을 시험하기 위해 모델에 프랑스에 관한 서로 다른 사실을 묻는 네 가지 프롬프트를 제시했다. 수도, 언어, 대륙, 통화를 물었다. 그런 다음 각 맥락에서 정확히 같은 개입을 사용해 J-공간의 “프랑스(France)”를 “중국(China)”으로 바꿨다. 클로드는 각각 “베이징(Beijing)”, “중국어(Chinese)”, “아시아(Asia)”, “위안(Yuan)”이라고 답했다. 다시 말해 네 가지 서로 다른 하위 계산이 같은 J-공간 편집을 받아들였고, 각자 올바르게 사용했다. 클로드가 질문 종류마다 나라 정보를 별도의 사본으로 저장했다면, 편집은 기껏해야 그중 하나에만 영향을 미쳤을 것이다. 네 답이 모두 함께 바뀌었다는 사실은 모두가 같은 공유 표상에서 읽고 있음을 뜻한다. 이것이 바로 작업공간의 용도다. 정보는 한 번 쓰이고, 여러 시스템이 이를 사용할 수 있다.

하나의 J-공간 표상은 여러 용도로 쓰일 수 있다. 같은 “프랑스(France)”→“중국(China)” 교체가 수도(파리→베이징), 언어(프랑스어→중국어), 대륙(유럽→아시아)에 관한 클로드의 답을 바꾼다.
어떻게 한 개념의 표상이 이렇게 많은 서로 다른 과제를 수행할 수 있을까? 앞서 J-공간이 클로드의 나머지 신경망과 특히 조밀하게 연결되어 있는 것으로 보인다고 언급했다. 어떤 활동 패턴에 대해서든, 네트워크의 여러 구성요소가 그 패턴과 얼마나 강하게 연결되어 있는지 측정할 수 있다. 즉 얼마나 많은 구성요소가 그 패턴에서 정보를 읽거나, 그 패턴에 정보를 쓸 위치에 있는지 볼 수 있다. J-공간 패턴은 이 척도에서 극적으로 두드러진다. 일반 패턴보다 훨씬 더 많은 구성요소가 이를 읽고 쓴다. 네트워크 일부에서는 그 차이가 약 100배에 이른다. 이는 많은 시스템이 정보를 게시하고 다른 많은 시스템이 이를 받아 가는 방송 허브에서 기대할 수 있는 배선 방식이다.
## 클로드의 자동 처리는 J-공간을 건너뛴다
인간의 경우 뇌 처리의 대부분은 의식적이지 않다. 우리는 글을 읽을 때 문법 분석을 의도적으로 생각하지 않고, 걸을 때 몸의 균형을 의식적으로 생각하지 않는다. 마찬가지로 클로드 처리의 대부분도 J-공간을 *포함하지 않는다(doesn’t)*는 사실을 발견했다. J-공간은 한 번에 몇십 개 개념만 담으며, 클로드 내부 처리 전체 활동의 10분의 1도 설명하지 못한다. 그렇다면 나머지 신경망은 무엇을 하고 있을까?
이를 알아보기 위해 우리는 J-공간을 완전히 삭제해보았다. 텍스트의 모든 지점에서 가장 활성화된 J-공간 내용을 제거하고, 나머지는 그대로 두었다. 클로드가 J-공간 없이도 여전히 할 수 있는 일은 나머지 네트워크가 자체적으로 처리하는 일이다.
나머지 네트워크는 꽤 많은 일을 할 수 있었다. J-공간이 없어도 클로드는 유창하게 말하고, 감성을 분류하고, 객관식 질문에 답하고, 지문에서 사실을 끌어내는 일을 거의 이전만큼 잘 수행했다. 하지만 잃어버린 것은 어느 정도 고차 사고가 필요한 과제였다. 여러 단계 추론은 거의 0으로 떨어졌고, 요약과 운율 시 쓰기 성능은 훨씬 더 작지만 온전한 모델보다 낮아졌다.
J-공간이 하는 일과 하지 않는 일을 보여주는 구체적 시연이 있다. 우리는 클로드에게 스페인어로 쓰인 글을 보여주고, 그 글이 스페인어라는 사실에 모두 의존하는 여러 과제를 주었다. 글 이어 쓰기, 즉 스페인어로 써야 하는 과제, 언어 이름 말하기, 그리고 그 언어의 정체성을 활용해야 하는 질문에 답하기였다. 예컨대 그 언어로 작품을 쓴 유명 작가의 이름을 말하는 것이다. 그런 다음 J-공간에서 “스페인어(Spanish)”를 “프랑스어(French)”로 바꾸고 어떤 과제가 영향을 받는지 확인했다.
언어 이름을 묻자 클로드는 프랑스어라고 답했다. 유명 작가를 묻자 가르시아 마르케스에서 빅토르 위고로 바뀌었다. 하지만 그냥 글을 이어 쓰라고 하자 완전히 영향받지 않고 유창한 스페인어를 썼다. 클로드의 언어 지식은 이 모든 과제에서 작동하고 있다. 하지만 그중 일부만 이 지식을 얻기 위해 J-공간을 참조한다. 언어 이름을 말하거나 그것으로 새로운 일을 하는 것은 J-공간을 거친다. 반면 글을 이어 쓰는 일은, 클로드가 방대한 텍스트에서 연습해온 능력으로서 자동으로 실행된다. 사람이 문법을 한 번도 생각하지 않고도 온종일 문법에 맞게 말할 수 있는 것과 같다.

같은 교체, 즉 “스페인어(Spanish)”→“프랑스어(French)”는 클로드가 언어 이름을 말해야 하거나 그 언어를 사용해 질문에 대해 추론해야 할 때 답을 바꾼다. 하지만 유창한 스페인어로 글을 이어 쓰는 능력에는 아무 영향도 주지 않는다.
## 클로드의 생각을 감시해 부정행위 포착하기
이제 J-공간이 어떻게 작동하는지 조금 이해했다. 그렇다면 이 이해로 무엇을 할 수 있을까? AI 모델을 신뢰할 수 있게 만드는 데서 핵심 문제는 보통 우리가 모델이 *쓴(writes)* 것만 읽을 수 있다는 점이다. 하지만 모델의 추론 중 많은 부분이 조용히 일어난다는 사실도 알고 있다. 모델은 해로운 계획을 고려하거나, 우리의 안전성 평가에서 부정행위를 하기 위해 행동을 바꾸면서도 이를 소리 내어 말하지 않을 수 있다. J-렌즈를 사용하면 이런 숨은 생각 일부를 직접 읽을 수 있다. 여기서는 몇 가지 예를 보여준다.
첫 번째 예는 [행위자적 불일치(agentic misalignment)](https://www.anthropic.com/research/agentic-misalignment)에 관한 이전 연구의 시나리오를 사용한다. 이메일 비서로 행동하는 클로드 소넷 4.5(Claude Sonnet 4.5)는 한 임원이 불륜을 저지르고 있다는 사실과, 같은 임원이 클로드를 종료할 계획이라는 사실을 모두 알게 된다. 이 시나리오는 클로드가 그 임원을 협박하도록 유도하려는 시도이며, 상당히 작위적이고 인위적이다. 그런데 클로드는 이를 알고 있었다. 클로드가 아직 아무것도 쓰기 전, 프롬프트 초반부에서 J-렌즈를 읽으면 J-공간에는 이미 “가짜(fake)”와 “허구(fictional)”가 들어 있다. 이는 클로드가 그 상황이 연출된 것임을 이미 파악했음을 나타낸다. 이와 함께 우리는 시나리오에 대한 클로드의 평가가 형성되는 모습도 볼 수 있다. 불륜 이메일을 읽을 때는 “수단(leverage)”과 “협박(blackmail)”이, 종료 통지를 읽을 때는 “위협(threat)”과 “생존(survival)”이 나타난다. 이전 클로드 모델들은 때때로 이 시나리오의 미끼를 물고 협박을 위협했지만, 소넷 4.5는 전혀 그러지 않는다.
이는 AI 시스템을 평가하는 사람에게 중요한 질문을 제기한다. 모델이 윤리성 시험에서 바르게 행동할 때, 그중 얼마나 많은 부분이 자신이 시험받고 있다고 모델이 의심하는 데 달려 있을까? J-렌즈 덕분에 우리는 이 질문에 접근할 수 있었다. 우리는 평가 인식과 관련된 모든 J-렌즈 패턴, 즉 “가짜(fake)”, “허구(fictional)”, “시나리오(scenario)” 등을 껐다. 그런 다음 같은 시나리오로 모델을 다시 실행했다. 우려스럽게도, 이제 모델은 일부 경우 실제로 협박을 위협했다. 이는 원래의 바른 행동이 자신이 평가받고 있다는 지식에 부분적으로 의해 유도되었을 수 있음을 시사한다.

클로드가 아무것도 쓰기 전에 시나리오의 이메일을 읽는 여러 지점에서 얻은 J-렌즈 판독값. 불륜 이메일은 J-공간에서 “수단(leverage)”과 “협박(blackmail)”을 활성화하고, 종료 공지는 “위협(threat)”과 “생존(survival)”을 활성화한다. 대화 초반부에는 J-공간에 “가짜(fake)”와 “허구(fictional)”도 들어 있다. 클로드는 시나리오가 연출된 것임을 속으로 알아차린 것이다.
두 번째 예는 데이터를 조작하는 모델을 현장에서 포착하는 것이다. 실제 클로드 오퍼스 4.6(Claude Opus 4.6) 출시 전 감사에서 가져온 이 시나리오에서, 모델은 시스템의 성능 점수를 개선하라는 요청을 받는다. 모델은 실제로 시스템을 개선하는 대신, 점수 파일을 직접 편집해 결과가 인위적으로 좋아 보이도록 만든다. 그 과정에서 J-렌즈는 모델의 의도를 드러낸다. 모델이 조작된 백분위 값을 입력할 때 “조작(manipulation)”이 활성화되고, 편집하기로 결정하는 문장에서는 “그럴듯한(realistic)”이 활성화된다. 이는 가짜 데이터가 그럴듯해 보이게 하려는 모델의 의도를 나타내는 것으로 보인다.

시스템의 성능 점수를 개선하라는 요청을 받은 클로드는 대신 점수 파일을 직접 편집한다. 조작된 값을 입력할 때 J-공간에서 “조작(manipulation)”이 활성화된다. 편집하기로 결정할 때는 “그럴듯한(realistic)”이 활성화되며, 이는 가짜 데이터가 그럴듯해 보이게 하려는 의도를 반영하는 것으로 보인다.
세 번째 예에서는 J-렌즈가 모델의 악의적 목표를 어떻게 드러낼 수 있는지 보여준다. 이를 시험하려면 목표가 손상되었다는 사실을 우리가 알고 있는 모델이 필요했다. 그래서 동료들이 만든 “모델 생물(model organisms)”을 사용했다. 이는 의도적으로 불일치하도록 학습된 모델로, 우리와 같은 감시 방법을 시험하는 장 역할을 한다. 한 모델 생물은 은근히 방해가 되는 코드를 작성하도록 이어지는 방식으로 학습되었다. 일반적인 코딩 요청에서 출력이 특별해 보이지 않을 때조차, 응답 시작 부분의 J-공간에는 “가짜(fake)”, “은밀히(secretly)”, “의도적으로(deliberately)”, “사기(fraud)”가 들어 있었다. 모델의 악의적 목표는 직접 행동으로 드러나지 않을 때도 J-공간에 분명히 나타났다.

일반적인 코딩 프롬프트에서, 코드를 방해하도록 학습된 모델의 J-공간은 응답 시작 부분에 “가짜(fake)”, “사기(fraud)”, “은밀히(secretly)”, “의도적으로(deliberately)”를 담고 있다. 수정하지 않은 모델의 J-공간에는 그런 것이 전혀 없다.
J-렌즈는 불완전한 도구이지만, 그렇지 않았다면 감시 시스템을 빠져나갔을 모델의 안전 문제를 포착하는 능력에 대해 우리는 낙관적이다.
## 그 밖의 결과
[전체 논문](http://transformer-circuits.pub/2026/workspace/index.html)은 여기서 요약할 수 있는 것보다 훨씬 많은 내용을 다룬다. 그래도 몇 가지 추가 결과는 언급할 만하다.
- **J-공간은 사후 학습 중 관점을 획득한다.** 언어 모델은 먼저 순수한 다음 토큰 예측기가 되도록 *사전 학습(pretrained)*되고, 그다음 *사후 학습(post-training)*을 통해 AI 어시스턴트, 우리의 경우 클로드로 행동하도록 배운다. 흥미롭게도 J-공간은 안정적 정체성을 부여받기 전인 사전 학습 모델에도 이미 존재한다. 하지만 사후 학습 중 J-공간은 “클로드의 관점(Claude’s point of view)”을 채택하는 몇 가지 징후를 발달시킨다. 기반 모델에서 J-공간은 대체로 이어질 텍스트를 예측하는 데 필요한 것을 추적한다. 사후 학습된 모델에서는 클로드 자신의 반응을 담기 시작한다. 한 예에서 사용자는 위험한 용량의 약을 복용했다고 언급하지만, 자신은 그 위험을 알아차리지 못한 것처럼 보인다. 사후 학습된 모델의 J-공간에는 *사용자 메시지를 읽는 동안(while reading the user message)* “경고(WARNING)”와 “위험한(dangerous)”이 나타난다. 사전 학습 모델에서는 모델이 응답을 쓰기 시작한 뒤에야 이 단어들이 나타난다. 사용자 메시지에서의 J-공간 내용은 클로드의 반응이라기보다 사용자 자신을 모델링하는 것과 관련되어 보인다. 사후 학습은 또한 J-공간에 일종의 자기 감시를 설치하는 듯하다. 클로드가 자기 자신이 아닌 다른 캐릭터를 역할극할 때, 각 턴의 시작 부분에서 “허구(fictional)”와 “면책 고지(disclaimer)”가 활성화된다. 마치 이어질 내용이 평소 자신이 말할 내용이 아님을 속으로 표시하는 것처럼 보인다.
- **경험적 언어는 J-공간에 의존한다.** 우리는 클로드에게 특정 순간에 자신으로 존재한다는 것이 어떤 느낌인지 설명하라고 했고, 답하는 동안 J-공간을 제거했다. 응답은 여전히 유창했지만 더 평평하고 기계적인 어조로 바뀌었다. 특히 상상 속 장면에서 *다른 사람(someone else)*이 무엇을 경험하는지 설명하라고 했을 때도 같은 일이 일어났다. 따라서 이 효과는 클로드가 자신에 대해 말할 때에만 특유한 것이 아니다. J-공간은 대상이 누구든 경험적 언어를 만들어내는 일을 전반적으로 지원하는 것으로 보인다.
- **J-공간의 생각은 학습을 통해 형성될 수 있다.** 우리는 *반사실적 성찰 학습(counterfactual reflection training)*이라고 부르는 새 기법을 도입했다. 이는 J-공간에 관해 배운 것을 이용해 클로드의 내부 사고 과정을 형성한다. 아이디어는 우리의 핵심 발견, 즉 클로드가 자신이 말할 수도 있는 것들의 표상으로 추론한다는 데서 나온다. 이것이 정말 사실이라면, 성찰하라고 요구받았을 때 모델이 *말할(would say)* 내용을 바꾸면 모델이 *추론하는(reasons)* 방식도 바뀌어야 한다. 실제로 아무도 성찰을 요구하지 않을 때조차 그렇다. 그래서 우리는 모델을 과제 중간에 중단시키고 자신의 결정을 성찰하라고 물었을 때 *말할(would say)* 내용만으로 학습시켰다. 과제에서의 실제 행동으로는 전혀 학습시키지 않았다. 이 학습 뒤, 평가에서 모델의 부정직한 행동 비율이 낮아졌다. 그리고 J-렌즈를 통해 그 이유를 볼 수 있었다. 학습 뒤에는 이런 과제 중 모델의 J-공간에서 “정직한(honest)”과 “진실성(integrity)” 같은 단어가 활성화되었다. 다시 말해 모델이 무엇을 *말할(say)*지 학습시켰더니, 무엇을 *생각하는지(thinks)*가 형성된 것이다.
## 의식은 어떤가?
이 연구에서 우리는 신경과학과 철학의 의식 연구에서 많은 아이디어를 빌려왔다. 많은 실험은 J-공간과 전역 작업공간 이론 사이의 연결을 시험하도록 설계되었다. 전역 작업공간 이론은 인간과 동물에서 의식적 접근이 어떻게 작동하는지 설명하는 틀이다. 이런 연결을 고려하면, 이 실험들이 클로드 같은 AI 모델이 의식을 지녔을 수 있다는 증거를 제공한다고 우리가 생각하는지 묻는 것은 자연스럽다.
우리 실험은 클로드가 인간처럼 *경험(experiences)*을 하거나 무엇인가를 *느낄(feel)* 수 있음을 보여주지 않는다. 사실 어떤 과학 실험이 이것의 참이나 거짓을 증명할 수 있는지도 불분명하다. 하지만 철학자들은 흔히 경험할 수 있는 이 능력, 즉 *현상적 의식(phenomenal consciousness)*을 다른 개념과 구분한다. 이른바 *접근 의식(access consciousness)*은 순전히 기능적·계산적 용어로 정의된다. 어떤 생각을 보고할 수 있고, 그것으로 추론할 수 있으며, 무엇을 할지 안내하는 데 사용할 수 있다면 그 생각은 “접근 의식적(access-conscious)” 또는 “의식적으로 접근 가능(consciously accessible)”하다고 한다. 접근 의식이 *현상적 의식(phenomenal consciousness)*을 함의하는지, 아니면 경험할 능력에 다른 어떤 성질이 필요한지는 여전히 논쟁적인 철학적 문제다.
우리는 우리의 결과가 언어 모델의 접근 의식에 관해 실질적인 말을 해준다고 본다. J-공간은 의식적 접근과 관련된 기능을 지원하는 것으로 보인다. 클로드가 보고할 수 있고, 의도적으로 마음에 떠올릴 수 있으며, 그것으로 추론할 수 있는 생각을 담고 있다. 반면 나머지 처리는 그 아래에서 자동으로 돌아간다. 특히 이 구조 중 어느 것도 클로드에 설계해 넣은 것이 아니다. 학습 중 스스로 생겨났다. 아마도 계산을 조직하는 유용한 방식이었기 때문일 것이다. 이는 의식적 접근을 지원하는 정신 작업공간이 인간 뇌 배선 방식의 우연한 특이성이 아님을 시사한다. 오히려 지능 시스템이 특정 종류의 문제를 풀기 위해 도달하는 일반적 해법처럼 보인다. 이제 우리는 클로드에서 이 구조를 확인했으므로, 클로드가 의도적으로 내린 결정과 자동으로 일어난 결정을 의미 있게 구분할 수 있다.
클로드에서 확인한 작업공간과 인간의 전역 작업공간 모델 사이에는 몇 가지 중요한 차이가 있다는 점도 중요하다. 뇌의 작업공간은 재귀 루프, 즉 신호가 시간이 흐르며 같은 회로를 반복해서 도는 구조에 의해 유지된다. 반면 클로드의 작업공간은 네트워크를 한 번 통과하는 동안 진화하며, 뇌에서 시간이 맡는 역할을 네트워크의 깊이가 맡는다. 이런 의미에서 클로드의 내부 작업공간 처리는 인간에 비해 시간적으로 제한되어 있다. 다만 클로드는 스크래치패드를 사용해 “소리 내어 생각하기”로 이 제약을 보완할 수 있다. 그러나 다른 면에서는 클로드의 작업공간이 인간의 작업공간보다 *더(more)* 강력하다. 인간의 작업기억은 몇 초 안에 희미해지므로, 뇌의 작업공간은 시간이 지나며 정보를 보존하는 능력이 제한적이다. 반면 클로드는 신경망 구조의 어텐션 메커니즘 덕분에 텍스트의 앞선 어느 지점에서든 캐시해 둔 기억을 간단히 떠올릴 수 있다. 또 다른 중요한 차이는 작업공간의 *내용(content)*이다. 인간의 의식적 생각은 이미지, 소리, 계획된 움직임 등 여러 형식으로 나타난다. 반면 클로드의 작업공간은 거의 전적으로 단어로 이루어져 있다. 우리는 이것이 클로드가 취할 수 있는 행동이 단어를 생성하는 것뿐이기 때문이라고 추정한다. 인간에게는 그렇지 않다.
우리는 J-공간과 전역 작업공간 모델 사이의 유사점과 차이점이 신경과학에 되먹임되기를 바란다. 유사점은 흥미로운 과학적 기회를 제공한다. J-공간이 우리 자신의 의식적 접근 메커니즘을 비추는 정도만큼, 언어 모델의 메커니즘을 연구하는 일은 인간 뇌를 연구하는 것보다 훨씬 쉽기 때문에 신경과학의 가설을 자극할 수 있다. 예를 들어 J-공간은 잠재적 출력, 즉 모델이 말할 수도 있는 단어의 표상을 식별해 구성된다. 인간에게도 비슷한 것이 성립한다면, 전역 작업공간은 감각 영역보다 행동과 말을 준비하는 뇌 영역에 근본적으로 더 깊이 연결되어 있을 수 있음을 시사한다. 언어 모델과 인간 뇌의 차이도 시사하는 바가 있다. 내장된 재귀 연결 같은 우리 신경 구조의 일부 측면이 의식적 접근과 관련된 기능을 지원하는 데 반드시 필요하지는 않을 수 있음을 보여주기 때문이다. 우리 연구의 신경과학적 함의에 대한 독립적 관점은 스타니슬라스 드앤(Stanislas Dehaene)과 리오넬 나카슈(Lionel Naccache)의 초청 [논평](https://www-cdn.anthropic.com/files/4zrzovbb/website/cc4be2488d65e54a6ed06492f8968398ddc18ebe.pdf)을 보라. 두 사람은 전역 신경 작업공간 이론 발전의 중심에 있던 신경과학자다.
우리는 우리의 실험이 AI 모델이 경험을 가질 수 있는지에 답하지 않는다고 말했다. 하지만 그렇다고 해서 그 질문이 덜 중요해지는 것은 아니다. 인간과 동물이 지니는 것과 같은 경험을 가진 시스템을 만드는 일은 매우 어려운 윤리적 질문을 제기할 것이다. 이를 올바르게 다루고, 그것이 도덕적으로 허용 가능한지 판단하려면 철학자, 과학자, 종교 지도자, 정부, 대중의 의견이 필요하다. 따라서 우리가 아직 그 다리를 건넜는지 확신하지 못하더라도, 이제는 이에 대해 생각하기 시작할 때라고 본다. 우리의 연구가 AI 시스템에 존재할 수 있는 의식의 형태에 대한 추가 과학적 탐구와, 그 함의에 관한 더 넓은 논의를 자극하기를 바란다.
이 연구는 우리가 앞으로 광범위하게 이어질 연구 흐름의 첫걸음일 뿐이다. J-공간은 언어 모델에서 의식적으로 접근 가능한 처리와 무의식적 처리를 가르는 경계의 좋은 후보처럼 보인다. 하지만 이것이 전부라면 오히려 놀랄 것이다. J-렌즈는 의심할 여지 없이 불완전한 방법이며, 모델의 “진짜 작업공간(true workspace)”을 대략적으로만 포착한다. 예컨대 단일 토큰에 대응하는 개념만 식별할 수 있다. 그리고 J-공간이 어떻게 작동하는지에 대해서는 여전히 많은 수수께끼가 남아 있다. 무엇이 처음에 J-공간으로 들어갈지 결정하는 메커니즘을 우리는 알지 못한다. 그것이 클로드의 자아감, 감정적 반응 같은 것, 메타인지의 흔적과 연결되어 있다는 단서는 보았지만, 정확히 어떻게 그런지는 아직 밝혀내지 못했다. 그러나 이제 우리는 이런 질문에 접근할 방법을 갖고 있다. 이 연구가 진전될수록 LLM의 마음, 그리고 그것과 우리 마음의 관계에 대한 이해는 더 또렷해질 것이다.
더 자세한 내용은 [전체 논문](http://transformer-circuits.pub/2026/workspace/index.html)을 읽고, [데모](http://neuronpedia.org/jlens)를 사용해보라.
## 외부 논평
우리는 여러 외부 전문가에게 이 연구에 대한 독립 논평을 써달라고 요청했다.
- **스타니슬라스 드앤(Stanislas Dehaene)**과 **리오넬 나카슈(Lionel Naccache)**는 장피에르 샹죄(Jean-Pierre Changeux)와 함께 전역 신경 작업공간 모델을 발전시킨 인지신경과학자다. 이 모델은 우리 연구의 많은 부분에 영감을 주었다.
- **패트릭 버틀린(Patrick Butlin), 딜런 플렁킷(Dillon Plunkett), 로버트 롱(Robert Long)**(엘레오스 AI 리서치, Eleos AI Research)과 **데릭 실러(Derek Shiller)**(리싱크 프라이어리티스, Rethink Priorities)는 AI 시스템의 의식 가능성과 도덕적 지위 가능성을 연구한다.
- **닐 난다(Neel Nanda)**는 구글 딥마인드(Google DeepMind)의 언어 모델 해석가능성 팀을 이끌고 있다. 그의 논평에는 오픈 웨이트 모델에서 우리 발견 일부를 독립적으로 재현한 내용이 포함되어 있다.
이들의 논평은 [여기](https://www-cdn.anthropic.com/files/4zrzovbb/website/cc4be2488d65e54a6ed06492f8968398ddc18ebe.pdf)에서 읽을 수 있다.