Metadata
# Bun을 Rust로 다시 쓰기
공개 사항: Bun은 2025년 12월 앤트로픽(Anthropic)에 인수되었다. 나와 Bun 팀의 다른 구성원들은 앤트로픽에서 일하고 있다. 이번 Rust 재작성 작업의 상당 부분에는 출시 전 버전의 클로드 페이블 5(Claude Fable 5)를 사용했다.
Bun은 처음에 esbuild의 자바스크립트(JavaScript) 및 타입스크립트(TypeScript) 트랜스파일러를 Go에서 Zig로 한 줄씩 옮긴 포트로 시작했다. 나는 [2021년 4월 16일](https://github.com/ziglang/zig/issues/8575)에 처음으로 Zig 코드를 작성했다. 해커 뉴스(Hacker News)에서 한 페이지짜리 [Zig 언어 레퍼런스](https://ziglang.org/documentation/master/)를 보고, 저수준 제어와 성능에 대한 세심한 배려에 크게 흥분해 Zig에 베팅했다.
처음부터 Bun의 범위는 방대했다.
- 자바스크립트, 타입스크립트, CSS 트랜스파일러, 미니파이어, 번들러
- npm 호환 패키지 관리자
- Jest와 유사한 테스트 러너
- Node.js 및 타입스크립트 호환 모듈 해석
- HTTP/1.1 및 웹소켓(WebSocket) 클라이언트
- `fs`, `net`, `tls`를 비롯한 수십 개 Node.js API 모듈 구현
Bun의 초기 버전은 내가 1년 동안, LLM 이전 시대에, 오클랜드의 비좁은 아파트에서 Zig로 작성했다. Bun처럼 야심찬 범위를 가진 프로젝트의 기본 결말은 GitHub 프로필 페이지에 남은 죽은 사이드 프로젝트 묘지에 합류하는 것이다. Zig가 있었기에 Bun이 가능했다. Zig가 아니었다면 나는 1년 만에 이만큼 만들 수 없었을 것이다.
오늘날 Bun CLI는 월간 다운로드 수가 2,200만 건을 넘는다. 클로드 코드(Claude Code)와 오픈코드(OpenCode) 같은 인기 도구들은 Bun을 런타임으로 선택했다. Vercel, Railway, DigitalOcean 등도 Bun을 1급으로 지원한다.
Bun의 범위는 안정성 측면에서도 도전이었다. 다음은 Bun v1.3.14에서 수정한 버그 중 일부다.
- 스레드풀에서 비동기 `.write()`가 아직 진행 중일 때 zlib, Brotli, Zstd 스트림에서 `.reset()`을 호출하면 `node:zlib`에서 발생하던 힙 사용 후 해제(heap-use-after-free) 크래시
- `onerror` 콜백이 네이티브 핸들에 재진입 `write()`를 호출한 뒤 `close()`를 호출할 때 `node:zlib`에서 발생하던 사용 후 해제(use-after-free) 크래시
- 재진입 JS 콜백이 해시맵 리해시를 유발해 내부 스트림 포인터를 무효화할 때 `node:http2`에서 발생하던 사용 후 해제 크래시. 예: 타임아웃 리스너, 옵션 게터, 쓰기 콜백 안의 `session.request()`
- `UDPSocket.send()`와 `sendMany()`에서 `valueOf()` 또는 `toString()` 콜백 내부의 사용자 코드가 페이로드 캡처와 실제 전송 사이에 `ArrayBuffer`를 분리할 수 있던 사용 후 해제
- 인수 강제 변환 중 `valueOf` 콜백이 underlying `ArrayBuffer`를 분리하거나 크기를 바꿀 때 `Buffer#copy`와 `Buffer#fill`에서 발생하던 크래시 및 범위 밖 읽기
- 사용자 JS 콜백으로 인해 반복 중간에 소켓 연결 상태가 바뀔 때 `UDPSocket.sendMany()`에서 발생하던 힙 범위 밖 쓰기
- 출력 버퍼 할당이 실패했을 때 콜백과 보호된 비밀번호/솔트 버퍼가 해제되지 않던 `crypto.scrypt` 메모리 누수
- `SSLWrapper.init` 오류 경로에서 `strdup`된 패스프레이즈가 누수되던 문제
- `tlsSocket.setSession()`에서 `d2i_SSL_SESSION` 뒤 `SSL_SESSION_free`가 빠져 호출마다 `SSL_SESSION` 하나가 누수되던 문제. 호출당 약 6.5KB
- `.close()` 뒤에도 `fs.watch()` 감시자가 가비지 컬렉션되지 않던 메모리 누수. 참조 카운트 언더플로로 각 감시자가 GC 루트로 영구 고정되어 발생했다.
- `background-clip`에 벤더 프리픽스와 다중 레이어 배경이 있을 때 CSS 파서에서 발생하던 이중 해제(double-free) 크래시
- `DuplexUpgradeContext`가 해제되지 않던 문제. `tls.connect({ socket: duplex })`마다 전체 누수가 발생했다.
- `MessageEvent`에서 발생하던 경쟁 조건 크래시. `BroadcastChannel` 또는 `MessagePort`에서 동시 접근이 일어나는 동안 GC 마커 스레드가 `m_data`의 찢어진 variant를 관찰할 수 있었다.
이런 버그를 앞으로도 하나씩 계속 고칠 수도 있었다. 하지만 우리를 믿고 의존하는 사용자들에게는 그보다 더 잘해야 할 책임이 있다. 이런 종류의 버그가 반복되지 않도록 체계적으로 막아야 한다.
### 우리가 이미 하고 있던 일
- 주소 새니타이저(Address Sanitizer) 지원을 추가하려고 Zig 컴파일러를 패치했다. 모든 커밋마다 ASAN으로 테스트 스위트를 실행한다.
- Windows에서는 Zig 안전 검사 빌드인 ReleaseSafe를 배포한다.
- V8과 자바스크립트코어(JavaScriptCore)가 사용하는 자바스크립트 엔진 퍼저인 [Fuzzilli](https://github.com/googleprojectzero/fuzzilli)로 Bun 런타임 API를 24시간 퍼징한다.
- 엔드투엔드 메모리 누수 테스트도 매우 많다.
많은 프로젝트보다 더 많은 일을 하고 있었다.
## 그냥 정말 똑똑하게 굴고 실수하지 않으면 안 되나?
버그 수정 목록은 마음에 걸렸고, Bun 크래시를 걱정하며 잠드는 일도 지겨웠다. 나는 이것을 Zig 탓으로 돌리지 않는다. Zig를 사용하는 다른 사람들에게는 우리가 겪은 버그가 없고, GC와 수동 메모리 관리를 섞는 일은 소프트웨어에서 흔하지 않다. 그래서 어떤 언어도 이를 염두에 두고 제대로 설계하지 않는다. Zig가 아니었다면 여기까지 오지도 못했을 것이고, 나는 늘 고마워할 것이다. 아주 최근까지만 해도 Bun 같은 프로젝트에서 프로그래밍 언어 선택은 되돌릴 수 없는 결정이었다.
자바스크립트는 가비지 컬렉션 언어이고, 자바스크립트코어와 V8 같은 현대 자바스크립트 엔진은 예외 처리와 가비지 컬렉터 주변에 엄격한 규칙을 둔다. Zig는 C처럼 메모리를 대신 관리해 주지 않는다. 많은 프로젝트에서는 이것이 Zig를 사용할 훌륭한 이유가 되는 트레이드오프다. Zig에는 생성자/소멸자가 없고, 대부분의 정리는 각 호출 지점에서 `defer`로 명시적으로 작성해야 한다.
Bun에서는 가비지 컬렉션되는 값과 수동 관리되는 값의 수명을 정확히 처리하는 일이 안정성 문제의 주요 원인이었다. 대부분은 작은 메모리 누수였고, 때로는 크래시였다. 모든 메모리 할당을 세심하게 검토해야 했다. 이 바이트들은 어디서 해제되는가? 정확히 한 번만 해제되도록 어떻게 보장하는가? 자바스크립트 예외를 제대로 확인했는가? 이 가비지 컬렉션 포인터가 보수적 스택 스캐너에 보이는가? 이것은 가비지 컬렉션 메모리인가, 수동 관리 메모리인가?
안정성 문제는 가능한 한 빨리 아는 것이 최선이다. 퍼징은 코드가 병합된 뒤에 일어난다. CI는 코드가 푸시될 때 돈다. 런타임 안전 검사와 주소 새니타이저는 코드가 실행될 때 작동한다. 바라건대 CI 이전, 개발 중에 말이다.
이런 종류의 문제를 줄이는 흔한 방법 중 하나는 정리 코드가 필요한 코드에서 정리 코드가 항상 정확히 한 번 실행되도록 보장하는 것이다. Zig는 숨은 제어 흐름이 없는 단순한 언어를 지향한다. 그래서 C++의 암묵적 ~Destructor나 Rust의 암묵적 `Drop`보다, 스코프 끝에서 코드를 실행하는 명시적 `defer` 키워드를 선호한다.
| 언어 | 정리 방식 |
| --- | --- |
| Zig | `defer`, `errdefer` |
| C++ | ~Destructor, &&Move |
| Rust | Drop |
Zig 코드에서는 정리 코드를 정확히 언제 실행해야 할까? 같은 `*T`를 여러 함수에 넘긴다면, 더 이상 접근할 수 없고 정리해도 되는 시점을 어떻게 알 수 있을까? 어떤 함수들은 호출 뒤에도 메모리를 계속 참조해야 한다면 어떻게 작동해야 할까? 현재 접근 방식은 다음이 섞여 있다.
- 접근 가능한 범위가 명확한 아레나 수명. 예를 들어 파서 상태는 호출 함수 밖으로 escape하지 않으므로 AST 노드에 적합하다.
- 참조 카운팅
- 정말 주의 깊게 살피기
많은 프로젝트는 이런 질문에 스타일 가이드로 답한다. Zig에서는 TigerBeetle의 [TigerStyle](https://tigerstyle.dev/)이 예이고, Google의 31,000단어짜리 [C++ 스타일 가이드](https://google.github.io/styleguide/cppguide.html)도 또 다른 예다. 스타일 가이드의 어려움은 강제다. 스타일 가이드가 지켜지도록 어떻게 보장할 것인가? 역사적으로는 코드 리뷰가 답이었고, 린터와 정적 분석기로 최선을 다해 보조했다.
소유권 기대치를 타입 시스템에 명확히 적어 넣은 엄격한 스타일 가이드는 Bun에서도 실제 선택지였다. Zig에는 연산자 오버로딩이 없으므로, 결국 다음과 비슷한 코드가 많이 생겼을 가능성이 높다.
```
fn foo(a_ptr: SharedPtr(TCPSocket)) !void {
const a: *TCPSocket = a_ptr.get();
defer a_ptr.deref();
const b = try do_something_with_a(a);
defer b.deref();
// ...
}
```
이는 우리가 기대하는 Zig 코드보다 덜 편하다.
```
fn foo(a: *TCPSocket) !void {
const b = try do_something_with_a(a);
// ...
}
```
## C/C++는 어떤가?
Bun 코드의 약 20%는 C++로 작성되어 있고, Bun은 여러 C/C++ 라이브러리를 임베드한다.
- Safari를 구동하는 자바스크립트 엔진인 자바스크립트코어
- HTTP/웹소켓 서버와 이벤트 루프인 uWebSockets 및 usockets
- `HPACK`과 HTTP/3 라이브러리인 lshpack 및 lsquic
- Google의 OpenSSL 포크인 BoringSSL
- SQLite
Zig 대신 C++를 쓰는 것도 Bun에는 합리적인 선택이었을 것이다. 생성자와 소멸자를 얻을 수 있다. 많은 `extern "C"` 래퍼 코드도 삭제할 수 있다.
하지만 여전히 코드 리뷰로 강제하는 스타일 가이드에 의존해야 했을 것이다. ASAN이 있어도 메모리 손상과 메모리 누수는 계속 발생했을 것이다.
## 왜 Rust인가?
앞의 목록에 있는 버그 중 상당수는 사용 후 해제, 이중 해제, 오류 경로에서의 “해제 누락”이다. 안전한 Rust에서는 이것들이 컴파일러 오류이며, `Drop`을 통한 RAII와 유사한 자동 정리가 있다. 컴파일러 오류는 스타일 가이드보다 더 나은 피드백 루프다.
역사적으로 재작성은 끔찍한 아이디어다. 주석을 제외하면 Bun은 Zig 코드 535,496줄이다. 다른 언어로 재작성하려면 소규모 엔지니어 팀이 꼬박 1년을 써야 한다. 그동안 버그 수정, 보안 수정, 기능 개발을 멈춰야 한다. 배포 가능한 무언가를 얻기 위한 가장 덜 위험한 접근은 Zig에서 Rust로 기계적으로 포팅하는 것이다. 동작 변경은 최소화하고, 이미 Bun 테스트에 사용하는 정확히 같은 테스트 스위트를 그대로 이용하는 방식이다.
다행히 Bun의 테스트 스위트는 타입스크립트로 작성되어 있다. 즉 런타임의 구현 언어에 의존하지 않는다.
사용자에게 보이는 영향이 1년 동안 전혀 없는 선택지는 현실적으로 고려할 수 없었다. 그래서 안정성 문제를 해결하기 위해 코드 스타일로 강제하는 것이 최선의 선택이었고, Bun 코드베이스에 Rust에서 영감을 받은 [스마트 포인터](https://github.com/oven-sh/bun/blob/3a79bd746b11601c9db970b608c73f0b9f96ac81/src/ptr/shared.zig#L569)를 추가했을 때의 계획도 그것이었다.
하지만 솔직히 말하면, 나는 그렇게 하고 싶지 않았다. 자체 제작 스마트 포인터는 Rust보다 사용성이 나쁘고, 보장도 없다.
그 대신, 앤트로픽의 새 모델이 Bun을 Rust로 다시 쓸 수 있는지 일주일만 시험해 보면 어떨까?
처음에는 될 거라고 기대하지 않았다. 며칠이 지나자 테스트 스위트의 높은 비율이 통과하기 시작했고, 새 Rust 코드가 원래 Zig 코드베이스와 얼마나 잘 맞아떨어지는지 보였다. 내 생각은 “시도해 볼 가치가 있다”에서 “이건 병합하겠다”로 바뀌었다.
## Claude, Bun을 Rust로 다시 써라.
이 일을 끔찍하게 망치는 방법은 많다. 예를 들어 클로드에게 “Bun을 Rust로 다시 써. 실수하지 마.”라고 프롬프트를 넣고 잘되기를 기도하는 방식은 내가 한 일이 아니다.
사람이라면 어떻게 할지 생각해 보자. 첫 번째 큰 질문은 이것이다.
점진적 재작성인가? 아니면 한 번에 전부인가?
Bun 초기 버전을 만들 때 esbuild 트랜스파일러를 Go에서 Zig로 포팅한 경험상, LLM 없이 했던 그 경험에 비추어 보면 한 번에 전부 하는 편이 낫다. 점진적 재작성은 언젠가 삭제되길 바라는 임시 코드를 추가한다. 단기에서 중기까지는 고통스러울 것이다.
두 번째 큰 질문은 이것이다. 어떻게 할 것인가?
Bun의 아키텍처, 성능, 기능 집합을 이전과 같은 Bun으로 유지하면서도, borrow checker 같은 Rust의 언어 기능을 어떻게 얻을 것인가? 재작성 뒤에도 팀이 계속 유지보수할 수 있음을 어떻게 보장할 것인가?
우리 Zig 코드를 Rust로 트랜스파일한 것처럼 보이는 재작성을 하자. Bun v1.4가 출시된 뒤에는 `unsafe` 사용을 줄이고 관용적인 Rust에 가까워지도록 점진적으로 리팩터링하면 된다.
큰 질문은 이 두 가지뿐이다. 나머지는 모두 전술이다.
## 코드를 작성하고 리뷰하는 루프
소프트웨어 엔지니어의 일상적인 엔지니어링 작업 상당수는 루프로 단순화할 수 있다.
```
// 의사 코드이며 실제 코드는 아니다.
let task;
while ((task = todoList.pop())) {
const result = task();
const feedback = await Promise.all([review(result), review(result)]);
await apply(feedback, result);
}
```
`task`에는 관련된 맥락이 있다. Jira 티켓, GitHub 이슈 등이 그렇다. `result`는 그것을 고치기 위해 작성한 코드다. 코드 리뷰어들은 변경 사항을 `review`해 회귀와 정확성을 확인한다. 그런 다음 피드백을 반영한다.
나는 클로드 코드에서 약 50개의 동적 워크플로를 11일 동안 계속 실행해 Bun을 Rust로 다시 썼다.
각 동적 워크플로는 이런 루프였다. 예를 들면 다음과 같은 워크플로다.
- Zig 패턴과 타입을 Rust 패턴과 타입으로 매핑하는 포팅 가이드 생성
- 모든 `.zig` 파일을 `.rs` 파일로 기계적으로 포팅하되, PORTING.md와 LIFETIMES.tsv를 따르기
- 각 크레이트의 컴파일러 오류 수정
- `bun test` 또는 `bun build` 같은 하위 명령 작동시키기
- Bun 전체 테스트 스위트의 모든 테스트 통과시키기
- 여러 대규모 리팩터링과 정리 패스
그 11일의 대부분, 그리고 그 이후에도 나는 워크플로를 감시했다. 출력물을 직접 읽어 문제와 버그를 확인했고, 클로드에게 루프를 수정해 문제를 고치도록 프롬프트를 넣었다.
100만 줄 이상 추가된 PR을 어떻게 리뷰할 것인가? LLM이 작성한 대량의 코드를 책임 있게 병합하는 데 필요한 확신을 어떻게 쌓기 시작할 것인가?
언어에 독립적인 백만 개의 assertion이 있는 테스트 스위트, 적대적 코드 리뷰, 그리고 무언가 잘못됐을 때 코드를 손으로 고치는 대신 코드를 생성하는 프로세스를 고치는 방식이 답이었다.
### 적대적 리뷰
적대적 리뷰는 클로드에게 별도 컨텍스트 창에서 변경 사항이 버그를 만들거나 작동하지 않는 이유를 가능한 한 철저히 찾아내라고 요청한다.
#### 컨텍스트 창 분리
보통 사람의 경우 코드를 리뷰하는 사람은 코드를 작성한 사람이 아니다. 코드를 작성한 사람은 코드를 병합하고 싶어 한다. 그래서 준비되기 전에 배포하도록 행동이 편향될 수 있다.
클로드도 마찬가지다. 코드를 작성한 클로드는 그 코드가 받아들여지기를 원한다. 리뷰하는 클로드는 코드에서 문제를 찾고 싶어 한다.
구현자 1명, 구현자당 적대적 리뷰어 2명 이상. 리뷰어의 유일한 일은 버그와 코드가 작동하지 않는 이유를 찾는 것이다. 구현자는 리뷰하지 않는다. 리뷰어는 구현하지 않는다.
✻ 클로드 코드 · 동적 워크플로
적대적 리뷰
병합 전 적대적 리뷰가 잡아낸 많은 버그 중 3개
버그 1/3 · 비동기 close
✻ 클로드 구현자
컨텍스트: 원본 `.zig`, 포팅 계획, 자신의 추론
✻ 클로드 적대적 리뷰어
컨텍스트: 오직 diff. 코드가 틀렸다고 가정하라는 지시를 받음.
적대적 리뷰어들이 실제로 잡아낸 세 가지 버그다. 인용된 각 커밋은 제목 줄에 리뷰 출처가 들어 있다. 세 버그 모두 컴파일됐고, 세 버그 모두 그럴듯해 보였다. 리뷰어는 자기만의 컨텍스트 창에 있는 두 번째 클로드다. diff만 받고, 구현자의 추론은 전혀 받지 않는다. 그리고 코드가 틀린 방식을 찾으라는 지시를 받는다. 코드는 인용된 커밋에서 압축한 것이다. 같은 버그, 같은 수정이다.
## 실제로는 어떤 모습인가?
크고 비싼 일을 하려 한다면, 먼저 위험을 줄여 두는 편이 시간과 돈을 아낀다.
### 준비 작업
코드를 쓰기 전에, 우리 Zig 코드베이스의 패턴을 Rust에 가깝게 매핑하는 방법을 두고 약 3시간 동안 클로드와 이야기했다. 클로드는 이 논의를 `PORTING.md` 문서로 직렬화했고, 이 문서는 결국 [해커 뉴스](https://news.ycombinator.com/item?id=48016880)에 올라갔다.
다음 질문은 이것이었다. 메모리를 수동으로 관리하는 코드에 Rust 수명을 어떻게 추가할 것인가?
그때 나는 클로드에게 대략 이렇게 프롬프트를 넣었다.
나: 코드베이스의 모든 구조체 필드에 적절한 수명을 분석하는 동적 워크플로를 시작하자. 이 워크플로는 모든 파일의 모든 구조체 필드를 읽고 제어 흐름을 추적해야 한다. 먼저 Rust로 표현하기 복잡한 수명을 가진 구조체 필드를 찾고, 그 필드에 대한 수명을 제안한 다음, 적대적 리뷰 에이전트 2개로 그 수명을 검토하게 하라. 그런 다음 피드백을 반영해 다른 클로드들이 볼 수 있도록 LIFETIMES.tsv로 직렬화하라.
그 뒤 `PORTING.md`와 `LIFETIMES.tsv`를 함께 대상으로 적대적 리뷰를 한 차례 돌렸다. 충돌하는 제안을 고치고 모든 것을 다시 확인하기 위해서였다. 나도 직접 읽어 보았다.
### 시험 실행
클로드에게 1,448개의 `.zig` 파일을 모두 `.rs` 파일로 번역하라고 요청하기 전에, 먼저 3개만 시작했다. 3개 파일 각각에 대해 구현자 1명이 새 `.rs` 파일을 작성했고, 적대적 리뷰어 2명이 `.rs` 파일이 `.zig` 파일의 동작과 일치하는지, `PORTING.md`와 `LIFETIMES.tsv`를 따르는지 확인했다. 그다음 수정자 1명이 제안을 반영했다.
### 잘못된 시작
클로드에게 1,448개의 `.zig` 파일 전체에 대해 워크플로를 반복하라고 요청했다. 그런데 약 2분 뒤 한 클로드가 커밋하기 전에 `git stash`를 실행했다. 다른 클로드는 `git stash pop`을 실행했다. 그리고 `git reset HEAD --hard`까지 실행했다. 서로 발을 밟고 있었다! 각 클로드를 별도 worktree에 넣으면 디스크 공간이 부족해질 터였다. Bun의 Git 저장소가 너무 크고, 결국 변경 사항은 함께 컴파일되고 함께 보여야 했기 때문이다.
그래서 클로드에게 워크플로를 수정하라고 했다. 클로드가 절대 `git stash`, `git reset`, 또는 특정 파일을 한 번에 커밋하는 것 외의 어떤 `git` 명령도 실행하지 않도록 지시하라고 했다. `cargo`도 금지했다. 느린 명령은 모두 금지했다.
그런 다음 클로드는 워크플로를 재개했다. 그리고 작동했다! 다만 너무 느렸다. 그래서 워크플로를 4개의 shard로 나누고, 각각 자체 worktree를 갖게 했다. 총 4개의 worktree에서 각각 클로드 16개가 파일을 커밋하고 푸시했다.
### 드디어 코드 작성
이 모든 병렬화와 준비 작업 덕분에, 최고점에서 클로드는 분당 약 1,300줄의 코드를 작성했다. 모든 코드 줄은 두 명의 별도 적대적 리뷰어, 역시 클로드에게 리뷰를 받았고, 커밋 전에 수정 라운드를 거쳤다. 물론 아직 아무것도 작동하지 않았다.
11일 × 24시간 · PDT
6,502개 커밋
시간당 1,695개 커밋
모든 포트 브랜치 커밋을 병합 커밋 제외하고 시간 단위로 묶었다. 최고 시간대는 695개 커밋이었다.
시간이 들쑥날쑥한 것이 보이는가? 이 작업을 실행한 EC2 인스턴스의 기본 IOPS를 늘리는 것을 깜빡했다. 느린 `grep` 명령 하나만으로도 몇 분 동안 디스크 읽기와 쓰기가 멈췄다.
### 컴파일러 오류를 작업 큐로 쓰기
모든 코드를 작성한 뒤, 나는 클로드에게 모든 컴파일러 오류를 고치는 워크플로를 작성하라고 했다. 크레이트별로 진행했다.
✻ 클로드 코드 · 동적 워크플로
약 16,000개 오류 남음
2026년 5월 6일 수요일, 오전 12:40 PDT
errors.txt
수정 커밋 0개
error: 필드 접근 전 \*mut EventLoop 역참조
error: js\_parser/ast/E.rs: Number/BigInt/RegExp용 json\_stringify 포팅
error: NodeHTTPResponse.rs: JSNodeHTTPResponse 캐시 접근자 연결
error\[E0034\]: 스코프 안에 적용 가능한 항목이 여러 개 있음
error: test\_command.rs: coverage façade를 bun\_sourcemap\_jsc::code에 연결
error: bundler/ungate\_support.rs: bun\_css shim을 real::bun\_css로 언게이트
error: dns.rs: pending\_cache\_for/get\_key/get\_or\_put\_into\_reso 구현
error: css/css\_parser.rs: DefineShorthand 계약, parse\_bundler 포팅
error: runtime/crypto/mod.rs: create\_crypto\_error가 boringss로 위임
error: bun\_core/fmt.rs: format\_ip reborrow 구현. 오프셋 기반 슬라이스
error: event\_loop/EventLoopTimer.rs: bun.zig의 Timespec::ns 포팅
분배됨 · 클로드 64개
worktree 1
→→
→→
→→
→→
worktree 2
→→
→→
→→
→→
worktree 3
→→
→→
→→
→→
worktree 4
→→
→→
→→
→→
수정 1개
리뷰 2개
적용 1개
→ 크레이트별로 커밋 반영
D 단계가 어떻게 작동했는지 실제 1,610개 커밋을 재생해 보면 이렇다. 5월 6일 PDT 기준이다. `cargo check`가 약 16,000개 오류를 파일에 기록하고, 크레이트별로 묶었다. 워크플로는 이를 64개의 클로드에게 나누어 주었다. 4개 worktree에 걸친 16개 루프였고, 각 루프는 클로드 1개가 수정하고, 2개가 리뷰하고, 1개가 적용했다. 모든 조각은 실제 커밋 묶음이다. 실제 크레이트에 반영된 뒤에야 카운터가 움직였다. 오류 줄은 실제 커밋 제목이다.
가장 까다로운 오류 범주는 순환 의존성이었다.
우리 Zig 코드베이스는 하나의 컴파일 단위였다. 사실상 하나의 크레이트였다. 나는 새 Rust 코드베이스를 약 100개의 크레이트로 나누어 Rust가 더 빨리 컴파일되게 하고 싶었다. 하지만 원래 Zig 구현과 비교해 변경을 최소화하면서 순환 의존성을 피해야 했다. Rust 재작성을 시작하기 직전에 이를 위해 올린 [내 PR](https://github.com/oven-sh/bun/pull/30224)은 충분하지 않았다. 처음부터 다시 시작하는 대신, 순환 의존성이 있는 코드를 어디에 둘지 분류하고 모두 기록하는 워크플로를 하나 더 실행했다. 그리고 그 리팩터링을 수행하는 워크플로를 또 실행했다.
순환 의존성을 고치자 약 16,000개의 컴파일러 오류가 드러났다. 사람 1명에게는 엄청난 수이지만, 64개의 클로드가 동시에 처리하기에는 미친 숫자는 아니었다.
병렬성을 극대화하려고 워크플로는 각 크레이트를 순회했다.
- 각 크레이트에서 `cargo check`를 실행하고, 출력을 파일별로 묶어 오류를 파일에 저장한다.
- 해당 크레이트 안의 모든 컴파일러 오류를 수정한다.
- 크레이트 변경 사항에 대해 적대적 리뷰어 2명이 리뷰한다.
- 수정자 1명이 수정 사항을 적용한다.
클로드들이 서로 발을 밟지 않도록 `cargo check`는 맨 처음에만 실행했다. 다른 실행과 마찬가지로 끝까지 `git`은 금지했다.
#### 또 다른 잘못된 시작
클로드는 “모든 크레이트가 컴파일되게 하자”를 “컴파일 오류가 있는 함수를 stub으로 바꾸자”로 해석했다. 또한 우회 방법을 문서화한다며 의심스러울 정도로 긴 설명 주석을 추가하기 시작했다. 그래서 적대적 리뷰어에게 다음 규칙을 추가해 거절하게 했다.
우회 방법이 괜찮은 이유를 정당화하는 데 문단 길이의 주석이 필요하다면, 그 코드는 틀렸다. 코드를 고쳐라.
프롬프트를 한 번 수정하고 몇 시간이 지나자 이런 일은 멈췄다.
### 스모크 테스트
모델들은 “스모크 테스트(smoke tests)”라는 말을 정말 좋아한다.
`cargo check`가 통과한 뒤에는 컴파일해서 `bun --version`을 실행하는 것이 다음 목표였다. 링커 오류가 있었다. 그다음에는 시작하자마자 panic이 났다.
다음 목표는 `bun test <file>`을 실행할 수 있게 하는 것이었다. 그것이 작동하면 테스트를 돌리기 시작할 수 있었다. 또 다른 워크플로 차례였다. 이번에는 Bun CLI 하위 명령을 순회했다.
- 실패한 각 stacktrace를 하위 명령과 함께 파일에 저장한다.
- 하위 명령별로 묶인 실패 stacktrace마다 클로드 1개가 수정한다.
- 적대적 리뷰어 2명이 리뷰한다.
- 수정자 1명이 제안을 적용한다.
### 로컬에서 테스트 스위트 통과시키기
이 워크플로는 테스트 파일을 순회했다.
약 100개의 임의 테스트 파일을 실행하고, 코드베이스 폴더별로 4개 worktree 중 하나에 shard했다. 실패한 각 테스트에 대해 stacktrace와 오류를 파일에 저장하고, 구현자 1명이 수정을 제안하며, 적대적 리뷰어 2명이 리뷰한 다음, 수정자 1명이 적용했다.
#### 더 많은 잘못된 시작
우리 테스트 스위트에는 메모리 누수 테스트가 많고, 1분 넘게 걸릴 수 있는 통합 테스트도 몇 개 있다. 예를 들어 `next dev`를 실행하고 핫 모듈 리로딩이 변경 사항을 100번 감지할 수 있는지 확인하는 테스트가 있다. 이런 테스트 중 몇 개는 디버그 빌드에서 타임아웃이 난다.
최대 TCP 소켓 수를 모두 소진하는 스트레스 테스트, 디스크에 기가바이트 단위로 읽고 쓰는 테스트, 약 1만 개 프로세스를 생성하는 테스트도 있다.
“부탁”보다 강한 격리가 필요했다. 그래서 `systemd-run`, 즉 cgroups를 사용해 메모리와 CPU 사용량을 제한하고 pid 네임스페이스를 격리했다. 그래도 머신은 여러 번 디스크 공간이 부족해졌고 크래시가 났다.
### CI에서 테스트 스위트 통과시키기
첫 CI 실행 이틀 뒤, 실패 목록은 972개 테스트 파일에서 23개로 줄었다. 그로부터 하루 반 뒤 Linux가 완전히 초록색이 됐다. 그때 처음으로 이 Rust 재작성이 실제로 성공할 것 같다고 느꼈다.
✻ 클로드 코드 · 동적 워크플로
Buildkite · 플랫폼별 초록색까지의 경주
Windows가 마지막에 끝남 · 5월 11일 오전 6:23 PDT
6 / 6 플랫폼 초록색
빌드 #54202 · 5월 14일 목요일 오전 12:23 PDT
macOS x64 · 2개 shard ✓
Linux arm64 · 60개 shard ✓
Linux x64 · 60개 shard ✓
macOS arm64 · 4개 shard ✓
Windows x64 · 8개 shard ✓
Windows arm64 · 8개 shard ✓
✓ 6개 플랫폼 모두 초록색 · 빌드 #54202 → 병합
테스트를 실행한 135개 CI 빌드 전체의 테스트 shard를 플랫폼별로 본 것이다. BuildKite에서 420개를 수집했다. 밝은 초록색은 모든 shard가 통과했다는 뜻이다. 흐린 초록색은 실패는 없었지만 실행이 중간에 끊긴 경우다. superseded된 것이다. 빨간색은 적어도 하나의 shard가 실패했다는 뜻이다. 각 lane에는 전체 스위트가 처음 통과한 시간이 찍혀 있다. Linux의 60개 shard는 Windows보다 거의 하루 먼저 초록색이었다. 마지막 실패 테스트들이 사라질 때까지 플랫폼들은 계속 빨간색으로 흔들렸다. 최종 올그린 빌드는 #54202였다.
병합까지 남은 시간은 비교적 단순했다. 각 플랫폼의 CI 테스트 실패를 더 이상 실패가 없을 때까지 반복해서 고치는 워크플로를 실행했다. Windows 관련 정리, 코드 중복 제거, unsafe 사용 감소, 전반적인 코드 정리를 위한 워크플로도 여러 개 돌렸다.
### Rust 재작성 병합
모든 플랫폼에서 CI상 Bun 테스트 스위트의 100%가 통과한 뒤, 그리고 테스트가 실제로 실행되고 있으며 건너뛰어지는 것이 아님을 내가 직접 확인한 뒤, 로컬에서 여러 명령을 실행해 이것저것 테스트했다. 그런 다음 병합 버튼을 눌렀다.
`main`에 병합하는 것은 버전 릴리스가 아니다. 이 시점에서 나는 앞으로 나아가고 재작성에 전념할 만큼은 확신했다. 하지만 아직 릴리스할 만큼 확신한 것은 아니었다.
### 통계
최고점에서는 이런 워크플로 4개를 동시에 실행했다. 각 워크플로는 별도 worktree에 있었고, 워크플로마다 클로드 16개가 있었다. 한 번에 약 64개의 클로드가 실행됐다.
git log · claude/phase-a-port
최고점: 1분에 58개 커밋
0
커밋
+0
작성된 줄 수. 재작성 포함
5월 4일 월요일 오전 7:05 PDT
6,502개 커밋 전체를 병합 제외하고 재생한 것이다. 분홍색 막대는 대부분 새 코드이고, 청록색 막대는 대부분 삭제다. 줄 수 카운터는 중간의 모든 재작성을 포함한다. 최종 반영된 diff는 +1,009,272였다. 로그는 실제 커밋 메시지다.
#### 건너뛰거나 삭제한 테스트 0개
11일, 5월 3일 → 5월 14일 병합 · 6,778개 커밋
| 플랫폼 | expect() 호출 | 테스트 | 파일 |
| --- | --- | --- | --- |
| Debian 13 x64 | 1,386,826 | 60,624 | 4,174 |
| macOS 14 arm64 | 1,259,953 | 58,850 | 4,175 |
| Windows 2019 x64 | 1,007,544 | 57,337 | 4,173 |
병합 전까지 이 작업에는 캐시되지 않은 입력 토큰 59억 개, 출력 토큰 6억 9천만 개, 캐시된 입력 토큰 읽기 720억 개가 들었다. API 가격 기준으로 약 165,000달러다. 사람이 손으로 했다면 코드베이스에 대한 전체 맥락을 가진 엔지니어 3명이 약 1년을 썼을 것이라고 생각한다. 그동안 우리는 Node.js 호환성을 개선하거나, 버그를 고치거나, 보안 문제를 고치거나, 새 기능을 구현할 수 없었을 것이다. 우리는 절대 그렇게 하지 않았을 것이다. 현실적인 대안은 아무것도 하지 않고, 이 글 앞부분의 버그들을 영원히 계속 고치는 것이었다.
이것은 오늘날 가능한 것의 최전선이다. 나는 Mythos급 모델인 출시 전 버전의 [클로드 페이블 5](https://www.anthropic.com/news/claude-fable-5-mythos-5)를 사용했다. 클로드 코드의 동적 워크플로는 11일 동안 64개의 클로드를 계속 실행했다. 그렇지 않았다면 이를 해내기 위해 자체 harness를 작성해야 했을 것이다.
### 작업은 계속된다
Rust 포트를 병합한 뒤, 우리는 [클로드 코드 시큐리티](https://claude.com/product/claude-security)로 11차례 보안 리뷰를 완료했고 발견 사항을 처리했다.
또한 Bun의 모든 파서에 대해 24시간 coverage-guided fuzzing을 추가했다. 대상은 자바스크립트, 타입스크립트, JSX, CSS, JSON5, JSONC, TOML, YAML, Markdown, INI, Bun Shell 스크립트, semver 범위, `.patch` 파일, CSS 색상이다. 퍼저는 발견한 버그를 자동으로 클로드에게 보내 재현 및 수정 PR을 제출하게 하고, 사람은 그 PR을 리뷰한다. 지금까지 파서를 1,000억 번 실행했고, 그 결과 약 15개의 PR이 나왔다.
글을 쓰는 시점에서 Bun의 Rust 코드 중 약 4%가 `unsafe` 블록 안에 있다. 약 78만 줄 중 2만 7천 줄, `unsafe` 키워드 약 13,000개다. 그리고 그 블록의 78%는 한 줄짜리다. C++에서 온 포인터 하나이거나, C 라이브러리 호출 하나다. 충실한 Zig 포트에서 관용적인 Rust로 리팩터링해 갈수록 이 숫자는 줄어들 것으로 예상한다. Zig에는 grep할 수 있는 `unsafe` 키워드가 없었다. 하지만 우리는 자바스크립트코어 같은 C 및 C++ 라이브러리를 계속 사용할 것이므로, 순수 Rust 프로젝트보다 `unsafe`는 항상 더 많을 것이다.
### 포팅 실수
Rust 재작성의 초점은 안정성이지만, 이런 대규모 변경을 배포하면서 회귀를 하나도 만들지 않는 것은 불가능하다.
이번 재작성은 알려진 회귀 19개를 만들었고, 모두 수정했다.
대부분의 회귀는 두 언어에서 문법은 동일해 보이지만 의미가 다른 코드에서 나왔다.
#### debug\_assert! 안의 부작용
아래 두 조각은 비슷해 보이지만 다르게 동작한다. Zig의 `assert`는 함수이므로 모든 빌드에서 인수가 실행된다. Rust의 `debug_assert!`는 매크로이므로 릴리스 빌드에서는 `insert_stale` 호출까지 포함해 전체 표현식이 지워진다.
```
// Zig:
if (dev.framework.react_fast_refresh) |rfr| {
assert(try dev.client_graph.insertStale(rfr.import_source, false) == IncrementalGraph(.client).react_refresh_index);
}
// Rust:
if let Some(rfr) = &dev.framework.react_fast_refresh {
debug_assert!(dev.client_graph.insert_stale(&rfr.import_source, false)? == react_refresh_index);
}
```
`insert_stale`은 파일을 프런트엔드 개발 서버의 핫 리로드 그래프에 추가한다. 릴리스 빌드에서는 이것이 실행되지 않았고, React를 사용하는 HTML route가 있는 프로젝트에서 핫 리로드된 파일이 무효화될 때 특정 경우 HMR이 깨졌다. 오류는 `Cannot destructure property 'isLikelyComponentType' of 'k'`였다. 디버그 빌드는 작동했다. [#30678](https://github.com/oven-sh/bun/issues/30678)
#### 홀수 길이 슬라이스
Bun의 Zig 헬퍼 `reinterpretSlice(u16, bytes)`는, 슬라이스를 지원하는 내장 cast보다 먼저 만들어진 코드인데, `@divTrunc`를 사용해 끝의 홀수 바이트를 무시했다. 반면 `bytemuck::cast_slice`는 여기서 panic을 낸다. UTF-16 바이트 순서 표시 뒤에 홀수 개 바이트가 이어지는 경우 `Blob.text()`가 문자열을 반환하지 않고 프로세스를 panic시키게 되었다. 우리는 다시 홀수 바이트를 무시하도록 되돌렸다. `&buf[..buf.len() & !1]`. [#31188](https://github.com/oven-sh/bun/issues/31188)
#### 범위 검사
macOS와 Linux에서는 Bun의 Zig 코드를 `ReleaseFast`로 컴파일했다. 이 모드는 범위 검사를 제거한다. Rust 릴리스 빌드는 범위 검사를 유지한다.
Bun의 모듈 resolver는 긴 파일 이름을 전역 목록에 intern하며, 이 목록은 overflow block으로 spill된다. 원래 Zig 코드는 각 블록 크기를 `count / 4`, 즉 2048로 잡았다. 포트에는 다음 placeholder가 남아 있었다.
```
/// ... 따라서 Phase B가 per-instantiation 값을 통과시킬 때까지
/// 0이 아닌 임시 값을 사용한다.
pub const BSS_OVERFLOW_BLOCK_SIZE: usize = 64;
```
이로 인해 intern된 파일 이름의 한도가 840만 개에서 270,272개로 낮아졌다. 실제 프로젝트가 이 한도에 도달했고, Zig에서 포팅해 온 `ptrs[4095]` off-by-one이 도달 가능한 상태가 됐다. Rust는 끝을 넘어 쓰는 대신 panic했다. Zig도 이 경우 `ReleaseSafe`를 사용했다면 panic했을 것이다. 우리는 Windows에서만 그렇게 했다. [#31503](https://github.com/oven-sh/bun/issues/31503)
#### comptime 포맷 문자열
`Output.pretty`는 `<r>`과 `<d>` 색상 마커를 ANSI escape로 다시 쓴다. Zig에서는 `fmt`가 `comptime`이므로 인수가 치환되기 전에 마커가 사라진다. Rust 함수에는 comptime 매개변수가 없으므로 `Output::pretty`는 완성된 문자열만 보았고, 인수 안의 마커까지 다시 썼다.
```
// Zig:
pub inline fn pretty(comptime fmt: string, args: anytype) void;
Output.pretty("<r>{f}<r>", .{hyperlink});
// Rust:
pub fn pretty(payload: impl PrettyFmtInput);
Output::pretty(format_args!("<r>{}<r>", hyperlink));
```
`bun update -i`는 패키지 이름을 [OSC 8](https://gist.github.com/egmontkob/eb114294efbcd5adb1944c9f3cb5feda) 하이퍼링크로 출력한다. 이 하이퍼링크는 `ESC \`로 끝난다. 그 백슬래시가 뒤따르는 `<r>`의 `<` 바로 앞에 놓이고, 마커 파서가 그것을 먹어 버리며, `r`이 텍스트로 출력된다.
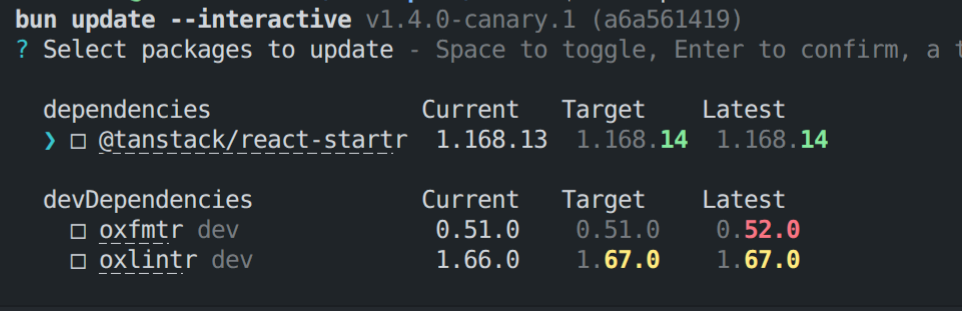
oxfmtr가 아니라 oxfmt라고 나와야 한다.
Rust에서는 매크로여야 한다. `bun_core::pretty!("<r>{}<r>", hyperlink)`. [#30693](https://github.com/oven-sh/bun/issues/30693)
## Bun은 Rust에서 더 좋아졌다
지금까지 Bun v1.4.0은 v1.3.14에서 재현되는 버그 128개를 수정했다. 범위는 메모리 누수부터 크래시, 잘못 색칠된 도움말 텍스트까지 다양하다.
### 메모리 사용량 감소
Rust에는 메모리를 정리하기 위한 강력한 언어 수준 도구인 `Drop`이 있다. `Drop`을 구현하면 값이 스코프를 벗어날 때마다 `drop` 함수가 자동으로 호출된다.
```
impl Drop for Bytes {
fn drop(&mut self) {
if !self.pinned.is_empty() {
JSC__JSValue__unpinArrayBuffer(self.pinned);
}
}
}
```
Zig에서는 `defer`를 사용해 스코프 끝에서 코드를 실행할 수 있다.
```
const bytes: ArrayBuffer = try .fromPinned(global, value);
defer bytes.unpin();
```
Zig에서는 정리가 필요할 수 있는 모든 개별 호출 지점마다 `defer`를 추가해야 한다. 정리를 잊어 메모리 누수가 생기거나, 드물게 도달하는 오류 처리 코드에서 정리 코드를 두 번 실행해 이중 해제가 생기기 쉽다. Rust에서는 값에 더 이상 접근할 수 없게 되면 `Drop`이 자동으로 실행된다. “숨은 제어 흐름 없음”을 포기하는 대신 흔한 함정을 막는다.
`Drop` 덕분에 Bun의 오류 처리 코드에서 파일 경로와 관련된 여러 메모리 누수가 고쳐졌다.
#### 계측 가능한 모든 메모리 누수를 고쳤다
우리는 Bun의 [LeakSanitizer](https://clang.llvm.org/docs/LeakSanitizer.html) 통합을 개선해 모든 [네이티브 코드 메모리 할당](https://github.com/oven-sh/bun/pull/30875)을 추적하게 했다.
예를 들어 프로세스 내부의 `Bun.build()` 호출은 매번 몇 MB의 메모리를 누수했다. 빌드 수명보다 오래 살아남는 파싱된 소스 텍스트와 AST 심볼 테이블이었다.
```
// 같은 60개 모듈 프로젝트를 한 프로세스에서 2,000번 번들링한다.
for (let i = 0; i < 2_000; i++) {
await Bun.build({
entrypoints: ["./index.js"],
minify: true,
sourcemap: "external",
});
}
```
Bun v1.3.14에서는 빌드마다 약 3MB가 영원히 누수된다. 요청마다 번들링하는 개발 서버 같은 도구는 결국 메모리를 다 쓴다. Bun v1.4.0에서는 메모리가 안정된다.
| 빌드 수 | Bun v1.3.14 | Bun v1.4.0 |
| --- | --- | --- |
| 500 | 1,914 MB | 526 MB |
| 1,000 | 3,506 MB | 586 MB |
| 1,500 | 5,097 MB | 608 MB |
| 2,000 | 6,745 MB | 609 MB |
Zig에서 이를 하려던 [이전 시도](https://github.com/oven-sh/bun/pull/24741)는 병합되지 않았다. Drop에 해당하는 것이 없어 병합에 확신을 갖기 더 어려웠기 때문이다.
### 더 작은 바이너리 크기
Rust 재작성의 초기 변경은 Windows에서 바이너리 크기를 3.8MB, macOS에서 5.5MB, Linux에서 6.8MB 줄였다. 이는 대체로 우리가 Zig 코드에서 `comptime`을 너무 많이 사용했기 때문이다.
초기 축소 이후, 팀은 Identical Code Folding 같은 링커 최적화, ICU에서 사용하지 않는 데이터 제거, zstd 사전을 사용해 libicu의 작은 일부를 필요할 때 지연 압축 해제하는 방식으로 바이너리 크기를 더 줄일 기회를 탐색했다.
Rust 재작성, ICU 변경, identical code folding을 합치면 **Bun의 바이너리 크기는 Linux와 Windows에서 약 20% 줄어든다(Bun's binary size shrinks by ~20%)**.
| 버전 | 플랫폼 | 크기 |
| --- | --- | --- |
| Bun v1.4.0 (canary) | Windows | 76 MB |
| Bun v1.3.14 | Windows | 94 MB |
| Bun v1.4.0 (canary) | Linux | 70 MB |
| Bun v1.3.14 | Linux | 88 MB |
### 스택 공간 사용량 감소
TOML 파서와 Bun의 다른 모든 재귀 하강 파서(JSON, YAML, 자바스크립트, 타입스크립트 등)는 이제 스택 공간을 덜 사용한다.
이로 인해 Rust 재작성을 병합하기 전에 일부 테스트 실패가 발생했다.
```
bun test v1.3.14-canary.1 (e99311e58)
.......
105 | });
106 |
107 | it("Bun.TOML.parse는 깊게 중첩된 인라인 테이블에서 크래시 대신 예외를 던진다", () => {
108 | const depth = 25_000;
109 | const deepToml = "a = " + "{ b = ".repeat(depth) + "1" + " }".repeat(depth);
110 | expect(() => Bun.TOML.parse(deepToml)).toThrow(RangeError);
^
error: expect(received).toThrow(expected)
Expected constructor: RangeError
Received function did not throw
Received value: {
a: {
b: {
b: {
b: {
b: {
b: {
b: {
b: {
b: [Object ...],
},
},
},
},
},
},
},
},
}
at <anonymous> (/var/lib/buildkite-agent/build/test/js/bun/resolve/toml/toml.test.js:110:42)
✗ Bun.TOML.parse는 깊게 중첩된 인라인 테이블에서 크래시 대신 예외를 던진다 [2907.64ms]
```
Rust의 LLVM IR codegen은 스택 변수가 더 이상 사용되지 않을 때 LLVM의 [`llvm.lifetime.start`](https://llvm.org/docs/LangRef.html#llvm-lifetime-start-intrinsic)와 [`llvm.lifetime.end`](https://llvm.org/docs/LangRef.html#llvm-lifetime-end-intrinsic) intrinsic을 내보낸다. 이를 통해 LLVM은 스택 공간 슬롯을 재사용할 수 있다. 중첩 스코프가 있는 큰 함수가 훨씬 적은 스택 공간을 사용하게 된다.
이전에는 [열려 있는 이슈](https://github.com/ziglang/zig/issues/23475)를 우회하기 위해 [특히 큰 함수들을 리팩터링](https://github.com/oven-sh/bun/pull/15993)해 많은 작은 함수로 나누었다.
### 2%~5% 더 빠름
Rust는 C/C++와 Rust 사이의 교차 언어 링크 타임 최적화를 지원한다. 이를 통해 프로그래밍 언어를 넘나드는 인라이닝이 가능하다. 정말 멋지지 않은가!
Linux x64에서 Bun v1.3.14와 Bun v1.4.0을 벤치마크했다. 환경은 EC2, Xeon Platinum 8488C다. HTTP 처리량은 hello-world 서버를 대상으로 [oha](https://github.com/hatoo/oha)로 측정했고, 애플리케이션 워크로드는 [hyperfine](https://github.com/sharkdp/hyperfine)으로 측정했다.
**HTTP 처리량(HTTP throughput, req/s, 3회 평균)**
| 서버 | Bun v1.3.14 | Bun v1.4.0 | Δ |
| --- | --- | --- | --- |
| Bun.serve | 169.6k | 177.7k | +4.8% |
| node:http | 103.8k | 108.5k | +4.5% |
| Elysia | 158.9k | 163.3k | +2.8% |
| express | 64.5k | 66.6k | +3.2% |
| fastify | 91.5k | 95.9k | +4.8% |
**앱 / CLI(Apps / CLI, hyperfine)**
| 워크로드 | Bun v1.3.14 | Bun v1.4.0 | Δ |
| --- | --- | --- | --- |
| next build | 13.62 s | 13.03 s | +4.5% |
| vite build (tsc + vite) | 1.69 s | 1.65 s | +2.2% |
| tsc -b --force | 0.94 s | 0.89 s | +4.7% |
## 프로덕션
Prisma는 Bun의 Rust 재작성 위에서 [Prisma Compute](https://www.prisma.io/blog/bun-rust-rewrite-prisma-compute) 공개 베타를 출시했다.
“메모리 누수와, VM이 일시 중지됐다가 재개된 뒤 복구하지 못하는 커넥션 풀이 문제였습니다. Rust 재작성이 나왔을 때 같은 실패 모드로 테스트했습니다. 완벽하게 처리했습니다.” - Alexey Orlenko
클로드 코드 v2.1.181, 6월 17일 릴리스, 이후 버전은 Rust 포트의 Bun을 사용한다. Linux에서 시작 시간이 10% 빨라졌지만, 그 외에는 거의 아무도 알아차리지 못했다. 지루한 것은 좋은 일이다.
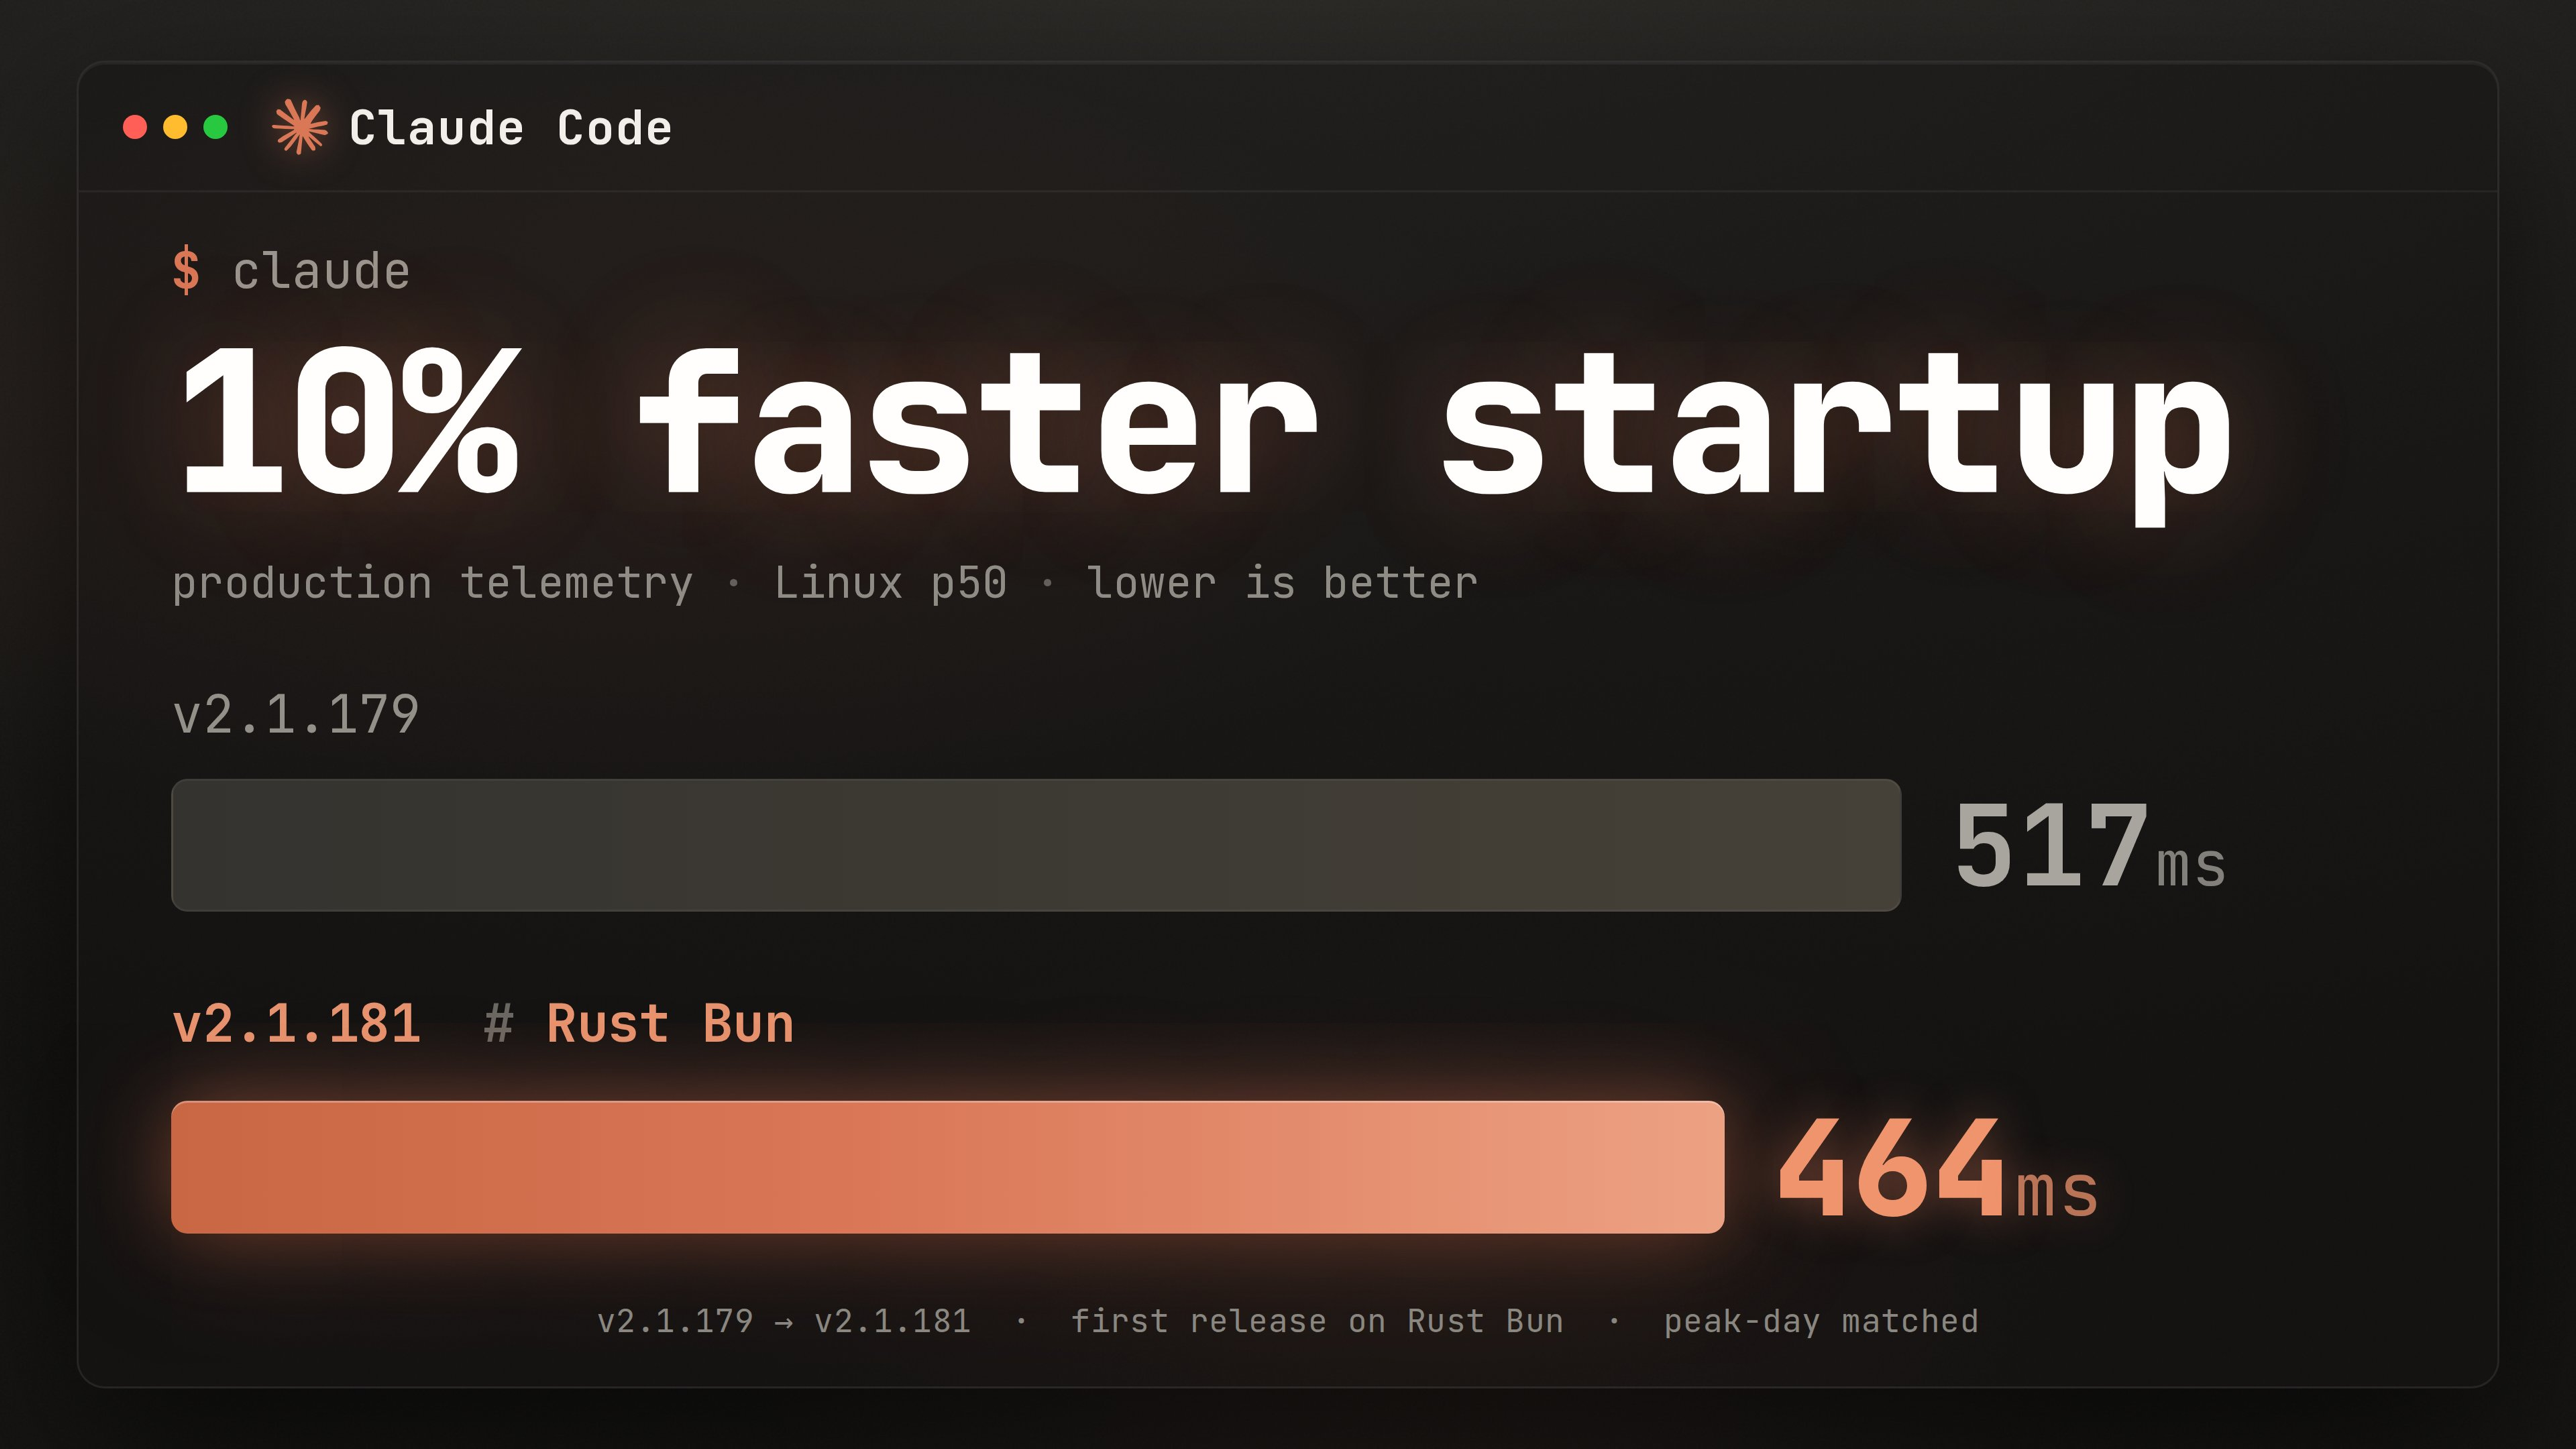
프로덕션 텔레메트리의 클로드 코드 시작 시간(Linux p50): v2.1.179는 517ms, Rust Bun을 사용한 첫 릴리스인 v2.1.181은 464ms — 10% 더 빠름
## 배포
Bun v1.3.14는 Zig로 작성된 마지막 Bun 버전이었다. Bun v1.4.0은 Rust로 작성된 첫 Bun 버전이 될 것이다. 지금 canary로 사용할 수 있다. 문제를 발견하면 보고해 주길 바란다.
```
bun upgrade --canary
```
## 유지보수성
나와 팀에게 새 Rust 코드베이스는 이전 Zig 코드베이스와 매우 비슷하게 느껴진다. 예를 들어 다음은 원래 Zig 코드와 새 Rust 코드의 일부다.
```
pub fn canMergeSymbols(
scope: *Scope,
existing: Symbol.Kind,
new: Symbol.Kind,
comptime is_typescript_enabled: bool,
) SymbolMergeResult {
if (existing == .unbound) {
return .replace_with_new;
}
if (comptime is_typescript_enabled) {
// TypeScript에서는 import가 모듈 안의 심볼과 조용히 충돌하는 것이 허용된다.
// 아마도 import가 type-only일 수 있기 때문일 것이다.
//
// import {Foo} from 'bar'
// class Foo {}
//
if (existing == .import) {
return .replace_with_new;
}
// ...
}
// ...
}
```
```
pub fn can_merge_symbol_kinds<const IS_TYPESCRIPT_ENABLED: bool>(
scope_kind: Kind,
existing: symbol::Kind,
new: symbol::Kind,
) -> SymbolMergeResult {
if existing == symbol::Kind::Unbound {
return SymbolMergeResult::ReplaceWithNew;
}
if IS_TYPESCRIPT_ENABLED {
// TypeScript에서는 import가 모듈 안의 심볼과 조용히 충돌하는 것이 허용된다.
// 아마도 import가 type-only일 수 있기 때문일 것이다.
//
// import {Foo} from 'bar'
// class Foo {}
//
if existing == symbol::Kind::Import {
return SymbolMergeResult::ReplaceWithNew;
}
// ...
}
// ...
}
```
원래 Zig 코드를 이해하는 사람이라면 기계적으로 번역된 Rust 코드도 이해한다. 나는 원래 Rust 재작성 PR을 리뷰할 때 적대적 코드 리뷰 에이전트들이 Zig 코드와 Rust 코드 사이의 불일치를 제대로 잡아내는지, 포팅 가이드와 수명 가이드를 따르게 하고 있는지 확인했다. 또한 Zig와 Rust를 나란히 놓고 많은 코드를 직접 읽었다.
## 다음 단계
Bun v1.4는 Bun을 더 빠르고, 더 작고, 메모리를 덜 쓰게 만든다. 그리고 앞으로 안정성을 체계적으로 개선하기 위한 믿기 힘들 만큼 강력한 도구들을 팀에 제공한다. Rust의 borrow checker, Miri, CI에서 점점 더 많은 코드에 대해 실행 중, LeakSanitizer, 그리고 파서를 위한 24시간 coverage-guided fuzzing이 그것이다. 아직 [리팩터링할 부분](https://bun.com/bun-unsafe-audit)은 더 있지만, 출발은 매우 좋다.
이 Rust 재작성은 코드베이스에 대한 전체 맥락을 가진 엔지니어 팀이 했다면 1년이 걸렸을 작업이다. Fable을 사용하는 엔지니어 1명이 클로드 코드를 면밀히 감시하며 진행한 결과, 시작부터 모든 플랫폼에서 테스트 스위트 100% 통과까지 11일이 걸렸다.
오늘날 엔지니어 한 명이 할 수 있는 일은 1년 전보다 훨씬 많다.