Metadata
# AI 에이전트 스택(2026년판)
> *다음 글은 원래* [*파올로 페로네(Paolo Perrone)의* The AI Engineer *서브스택(Substack)*](https://theaiengineer.substack.com/p/the-ai-agents-stack-2026-edition)*에 실렸으며, 저자의 허락을 받아 이곳에 다시 게시합니다.*
당신의 팀이 고객 지원 챗봇을 만들려고 랭그래프(LangGraph)를 선택한다고 해보자. 3주가 지나면 상태 그래프에는 노드 14개가 생기고, 레디스(Redis)에 쓰는 커스텀 체크포인터가 붙어 있으며, 일주일에 한 번 실패하는 도구 호출을 위한 재시도 로직까지 들어가 있다. 에이전트는 환불 관련 질문에 답한다. 호출하는 API는 하나뿐이다. 오픈AI SDK에 MCP 서버 두 개를 붙인 50줄짜리 스크립트로도 똑같은 일을 할 수 있었을 것이다. 하지만 아무도 이 문제가 실제로 어떤 계층을 필요로 하는지 매핑하지 않았다.
2024년 11월, 레타(Letta)는 [AI 에이전트 스택 다이어그램](https://www.letta.com/blog/ai-agents-stack)을 발표했다. 이 다이어그램은 내가 만나는 엔지니어링 팀 절반이 기본 참고 자료로 삼을 만큼 널리 쓰이게 됐다. 링크드인에서 “에이전트의 계층” 같은 그림을 봤거나 슬랙 채널에 고정된 자료를 본 적이 있다면, 아마 그 글에서 출발했을 가능성이 크다.
이제 그 다이어그램은 나온 지 14개월이 지났고, 그사이에 많은 것이 바뀌었다. 당시에는 MCP가 아직 없었다. 메모리는 여전히 벡터 데이터베이스의 일부로 취급됐다. 공급자 네이티브 에이전트 SDK를 배포하는 곳도 없었다. 평가(eval)는 지도 위에 올라와 있지도 않았다. 2026년의 스택에는 여섯 계층이 있으며, 그중 적어도 세 계층은 레타가 원래 다이어그램을 그릴 때만 해도 별개의 범주로 존재하지 않았다.
그래서 우리는 처음부터 다시 그렸다. 이것이 2026년 버전이다.
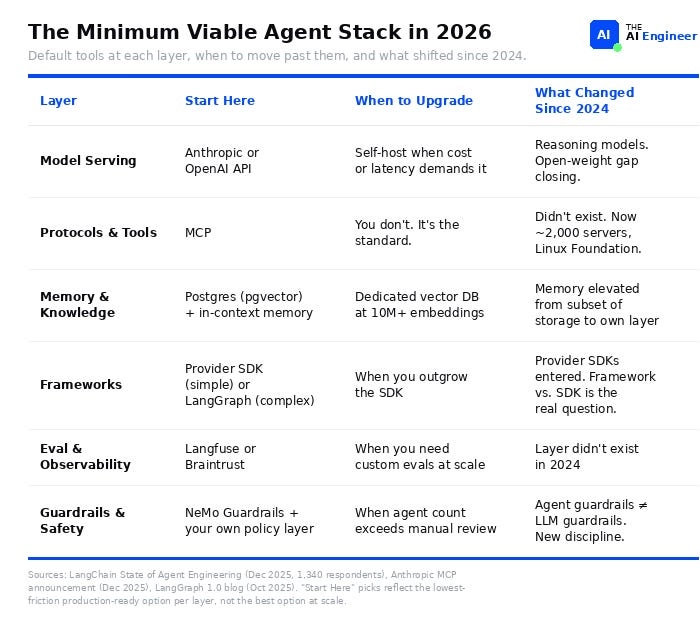
2026년의 최소 실행 가능 에이전트 스택
## 요약
이것이 출발점이 되는 스택이다. 복잡성은 구체적인 무언가가 깨졌을 때 추가하라. 그 전에는 아니다.
## 우리는 도대체 무엇을 매핑하고 있는가?
스택이 있기 전에는 루프가 있었다. “[AI 에이전트란 무엇인가?](https://theaiengineer.substack.com/p/what-is-an-ai-agent)”에서 우리는 에이전트를 사고-행동-관찰(think-act-observe) 주기로 정의했다. 모델이 작업에 대해 추론하고, 행동을 취하며(도구 호출, 메모리에 쓰기 등), 결과를 관찰한 뒤, 작업이 끝날 때까지 이 과정을 반복한다. 이 루프가 원자 단위다. 이 글에서 다루는 모든 것은 그 루프가 프로덕션에서, 규모 있게, 안정적으로 작동하게 만드는 인프라다.
에이전트 스택은 LLM 스택이 아니다. 챗봇에는 추론(inference)과 어쩌면 RAG가 필요하다. 에이전트에는 다단계 실행 전반의 상태 관리, 프로토콜로 통제되는 도구 접근, 세션을 넘어 지속되는 메모리, 자율 추론 루프, 실시간으로 행동을 제한하는 가드레일이 필요하다. 이는 근본적으로 다른 종류의 인프라 문제다.
우리는 LLM과 프로덕션 에이전트 사이에 있는 여섯 계층을 매핑한다. 학습 인프라, 데이터 파이프라인, 모델 파인튜닝은 다루지 않는다. 그것들은 인접한 스택이다. RAG는 [5호](https://theaiengineer.substack.com/p/what-is-rag-retrieval-augmented-generation)에서 깊이 다뤘다. 오늘은 시야를 넓혀 RAG가 더 큰 그림 안에서 어디에 들어가는지 보여준다.
2024년에서 2026년 사이, 세 가지가 지도를 다시 그렸다. MCP가 도구 연결 방식을 표준화했고, 그 덕분에 도구 계층 전체가 새로 생겼다. 추론 모델은 에이전트가 자율적으로 할 수 있는 일을 바꿨고, 일부 다단계 체인은 단일 호출 에이전트로 대체됐다. 그리고 메모리는 벡터 데이터베이스에 뒤늦게 덧붙이는 것이 아니라, 일급 아키텍처 기본 요소가 됐다.
### 각 계층을 평가하는 방법
각 계층에서 도구를 고를 때는 세 가지 질문을 던져라. *얼마나 많은 상태(state)를 관리해야 하는가?* 상태 없는 도구 호출기와 시간이 지나며 학습하는 다중 세션 에이전트는 서로 다른 엔지니어링 문제다. 상태 관리가 가장 어려운 계층, 즉 메모리와 프레임워크에서 대부분의 팀이 막힌다. *얼마나 많은 벤더 종속(vendor lock-in)을 감수할 수 있는가?* MCP는 공개 표준이지만 공급자 SDK는 그렇지 않다. 모든 도구 선택은 다음 마이그레이션의 고통을 키우거나 줄인다. *그리고 데모에서 프로덕션으로 가는 일이 얼마나 어려운가?* 어떤 계층, 예컨대 모델 서빙은 거의 차이가 없다. 반면 평가와 가드레일 같은 계층은 차이가 매우 크다. 그 간극을 가장 크게 느끼는 계층에 먼저 투자해야 한다.
가장 안정적인 계층부터 시작해 가장 미성숙한 계층까지, 아래에서 위로 각 계층을 살펴보겠다.
## 계층 1: 모델과 추론
*에이전트를 구동하는 모델을 실행하는 방식이다. API를 호출하거나, 관리형 오픈 웨이트(open weight) 공급자를 사용하거나, 직접 호스팅한다.*
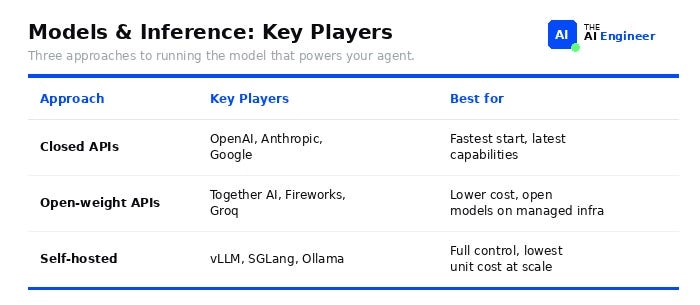
모델과 추론: 주요 플레이어
추론 계층은 본질보다 분위기가 더 많이 바뀌었다. o1, o3, 딥시크 R1(DeepSeek R1), 확장 사고(extended thinking)를 지원하는 클로드(Claude) 같은 추론 모델은 에이전트가 계획하고 실행할 수 있는 범위를 바꿨다. 이전에는 다단계 체인이 필요했던 에이전트도 이제는 단일 추론 호출로 문제를 풀 수 있다. 라마 3.3(Llama 3.3), 딥시크 V3(DeepSeek V3), 큐원 2.5(Qwen 2.5) 같은 오픈 웨이트 모델은 품질 격차를 극적으로 좁혔다. 그래서 “항상 가장 큰 폐쇄형 모델을 써라”는 더 이상 기본 조언이 아니다. 새롭게 떠오르는 패턴은 폐쇄형 소스로 프로토타입을 만들고, 오픈 웨이트로 배포하는 것이다.
> 솔직히 말하면, 이 계층은 범용재가 되고 있다. 분기가 지날수록 모델 간 차이는 덜 중요해진다. 진짜 결정 기준은 어떤 모델이 “가장 똑똑한가”가 아니라 비용과 지연 시간의 트레이드오프다.
평가 관점에서 API 호출은 상태가 없다. 요청을 보내고 응답을 받으면 끝이다. 관리할 것이 없다. 폐쇄형 API는 종속 위험이 크다. 모델마다 추론 방식이 다르기 때문이다. 공급자를 바꾸려면 프롬프트를 다시 조정하고, 서로 다른 실패 모드에 맞게 수정하며, 평가 스위트를 다시 테스트해야 한다. 오픈 웨이트에서는 위험이 낮다. 모델을 바꾸면서 인프라는 유지할 수 있기 때문이다. 프로토타입에서 프로덕션으로 가는 간극은 모든 계층 중 가장 작다. 데모에서 쓰는 API 호출과 프로덕션에서 쓰는 API 호출이 같다.
에이전트 호출량 때문에 API 가격을 감당하기 어렵거나, API 왕복으로는 달성할 수 없는 100ms 미만의 지연 시간이 필요할 때 직접 호스팅하라.
## 계층 2: 프로토콜과 도구
*에이전트가 외부 도구와 API를 호출하는 방식이다. MCP 서버, 브라우저 자동화, 에이전트 간 프로토콜을 통한다.*
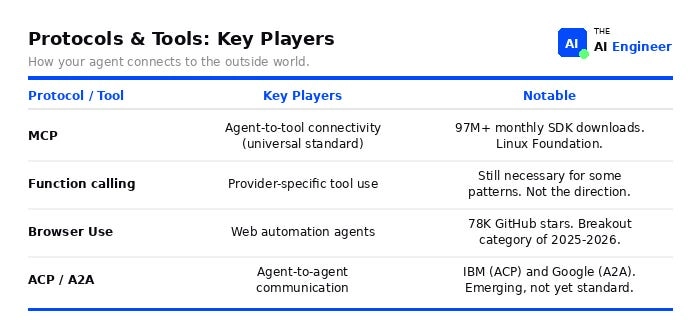
프로토콜과 도구: 주요 플레이어
이 계층은 2024년에는 별개의 범주로 존재하지 않았다. 모든 프레임워크가 도구 정의를 위한 자체 JSON 스키마를 갖고 있었다. 이제는 MCP가 표준이다. SDK 월간 다운로드 수는 9,700만 회에 달하고, 오픈AI, 구글, 마이크로소프트가 채택했으며, 리눅스 재단에도 기증됐다.
브라우저 유스(Browser Use)도 동시에 폭발적으로 성장해 1년도 안 돼 깃허브 스타 7만 8,000개를 기록했다. 2024년에는 프로덕션에서 브라우저 에이전트를 배포하는 곳이 없었다. 이제 에이전트는 다른 에이전트와도 대화할 수 있다. IBM은 ACP를, 구글은 A2A를 내놨다. 아직 둘 다 표준은 아니지만, 이들이 해결하려는 문제, 즉 에이전트가 다른 에이전트와 협업하는 문제는 실제로 존재하며 커지고 있다.
보안은 아직 풀리지 않은 문제다. 엔도어 랩스(Endor Labs)는 [MCP 서버 2,614개를 분석](https://www.endorlabs.com/learn/classic-vulnerabilities-meet-ai-infrastructure-why-mcp-needs-appsec)했고, 그 결과 82%가 경로 순회(path traversal)에, 67%가 코드 삽입(code injection)에 취약하다는 사실을 발견했다.
> 솔직히 말하면, 프로토콜 논쟁은 끝났다. MCP가 이겼다. 남은 질문은 누군가 악용하기 전에 MCP 서버를 어떻게 잠글 것인가뿐이다.
이 계층에는 상태 관리가 없다. 에이전트가 도구를 호출하고 응답을 받으면 끝이다. 세션도 없고, 호출 간 메모리도 없다. MCP가 공개 표준이기 때문에 종속 위험은 낮다. MCP 서버를 만들면 MCP 호환 에이전트는 무엇이든 그것을 사용할 수 있다. 프로토타입에서 프로덕션으로 가는 간극은 중간 정도다. 데모 MCP 서버는 누군가 악의적인 도구 설명을 보내기 전까지는 잘 작동한다. 보안과 거버넌스가 바로 그 간극이다.
MCP는 에이전트가 도구를 사용하는 방식을 표준화했다. 에이전트가 서로 대화하는 방식에 대해서는 아무 말도 하지 않는다. ACP와 A2A가 그것을 해결하려 하지만, 아직 어느 쪽도 임계 규모에 도달하지 못했다. 지금 다중 에이전트 협업이 필요하다면 프레임워크 계층에서 직접 만들어야 한다. MCP는 [4호](https://theaiengineer.substack.com/p/what-is-mcp)에서 자세히 다뤘다.
## 계층 3: 메모리와 지식
*에이전트가 자신이 아는 것을 저장하고 검색하는 방식이다. 인컨텍스트 상태(in-context state), 벡터 검색, 세션을 넘나드는 영속 메모리로 구성된다.*
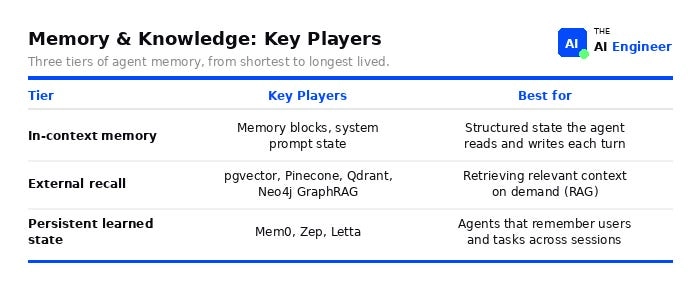
메모리와 지식: 주요 플레이어
세 계층 모두 같은 곳으로 흘러 들어간다. 에이전트가 호출마다 보는 컨텍스트 창이다.
2024년에 메모리는 “벡터 데이터베이스를 골라 RAG를 하라”는 뜻이었다. 2026년에 메모리는 세 가지 뚜렷한 층을 가진 일급 아키텍처 기본 요소다. 컨텍스트 창은 거대해졌다. 제미나이(Gemini)는 100만 토큰 이상, 클로드는 20만 토큰에 도달했다. 하지만 더 큰 창이 메모리의 필요성을 없애지는 않았다. 트레이드오프를 바꿨을 뿐이다. 무엇을 컨텍스트 안에 넣고, 무엇을 필요할 때 검색할 것인가?
“컨텍스트 엔지니어링(context engineering)”이 “프롬프트 엔지니어링(prompt engineering)”을 대신해 핵심 분야가 됐다. 더 나은 프롬프트를 쓰는 대신, 호출마다 에이전트가 어떤 정보를 보게 할지 설계한다. 메모리 블록은 컨텍스트 창 안에서 이름이 붙은 구조화 필드로 등장했다. 에이전트는 매 턴 이 필드를 읽고 덮어쓸 수 있다. 모든 것을 시스템 프롬프트에 쏟아붓는 대신, 에이전트가 자신의 상태를 관리한다. 무엇을 유지할지, 무엇을 업데이트할지, 무엇을 버릴지 결정한다.
인프라 측면에서는 전용 벡터 데이터베이스가 필요하지 않은 팀에게 pgvector가 기본값이 됐다. 확장 기능이 붙은 포스트그레스(Postgres)일 뿐이다. 그래프RAG(GraphRAG)는 두 번째 검색 옵션으로 부상했다. 임베딩 매칭 대신 엔터티 간 관계를 따라가며, 이 영역은 네오4j(Neo4j)가 이끌고 있다. 에이전트가 유휴 시간에 정보를 처리하는 슬립타임 컴퓨트(sleep-time compute)는 아직 연구 단계지만, 세 번째 층이 어디로 향하는지 보여준다.
> 솔직히 말하면, 대부분의 팀은 메모리를 지나치게 복잡하게 만든다. 포스트그레스에 대화 기록을 저장하고, 구조화된 시스템 프롬프트를 쓰는 것부터 시작하라. 기록이 컨텍스트 한계를 넘어설 때 벡터 검색을 추가하라. 에이전트가 세션을 넘어 학습해야 할 때에만 에이전트식 메모리 관리를 추가하라.
이 계층이 바로 상태 계층이다. 에이전트가 무엇을 기억할지, 어떻게 검색할지, 언제 잊을지를 결정하는 곳이다. 스택에서 복잡도가 가장 높다. 종속 위험은 중간 정도다. pgvector는 그저 포스트그레스이므로 이식성이 좋다. 반면 Mem0나 Zep 같은 특화 도구는 벗어나기가 더 어렵다. 프로토타입에서 프로덕션으로 가는 간극은 크다. 데모 메모리는 컨텍스트 창이 충분히 커서 작동한다. 프로덕션 메모리는 대화가 길어지고 에이전트가 중요한 부분을 잊기 시작할 때 깨진다.
인컨텍스트 메모리는 에이전트가 여러 인스턴스 간에 메모리를 공유해야 하거나, 모델 공급자를 바꿔도 상태를 유지해야 할 때 한계에 부딪힌다. 바로 그때 레타, Zep, Mem0 같은 전용 메모리 인프라가 제값을 한다.
## 계층 4: 프레임워크와 SDK
*에이전트가 작동하도록 모델 호출, 도구 사용, 제어 흐름을 엮는 방식이다. 공급자의 내장 툴킷(SDK), 랭그래프 같은 그래프 기반 프레임워크, 또는 직접 작성한 코드가 여기에 해당한다.*
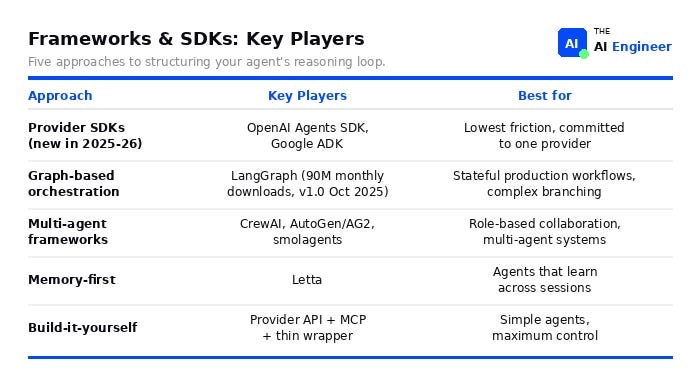
프레임워크와 SDK: 주요 플레이어
이제 주요 AI 연구소는 모두 자체 에이전트 SDK를 제공한다. 오픈AI에는 에이전트 SDK가 있다. 스웜(Swarm)에서 발전한 것이다. 구글은 ADK를 출시했다. 마이크로소프트에는 시맨틱 커널(Semantic Kernel)과 오토젠(AutoGen)이 있다. 허깅페이스(Hugging Face)는 스몰에이전트(smolagents)를 만들었다. 2년 전에는 랭체인(LangChain)이 유일한 선택지였다. 이제는 세 진영 중에서 골라야 한다. 시작은 빠르지만 한 모델에 묶이는 공급자 SDK, 이식성은 좋지만 설정이 더 필요한 랭그래프 같은 그래프 기반 프레임워크, 또는 아예 프레임워크를 쓰지 않는 방식이다. 2024년에는 이런 선택지가 없었다.
랭그래프는 그래프 기반 오케스트레이션의 선두로 굳어졌다. 2025년 10월 v1.0이 출시됐고, 우버(Uber), JP모건(JPMorgan), 링크드인(LinkedIn), 클라르나(Klarna)가 프로덕션에 배포했다. 랭체인 에이전트는 이제 내부적으로 랭그래프 위에 만들어진다. 한편 “직접 만들기” 진영도 커졌다. 2024년에 랭체인을 써보고 추상화와 씨름했던 팀들은 이제 공급자 API와 MCP 위에 얇은 래퍼를 작성하고 있다. 프레임워크가 없다는 것은 완전한 제어권을 뜻한다. 이는 에이전트에 상태 관리나 복잡한 분기가 필요해질 때까지는 잘 작동한다.
이름에 대해 간단히 짚고 가자. “랭체인(LangChain)”과 “랭그래프(LangGraph)”는 같은 것이 아니다. 랭체인은 모델 커넥터, 도구 호출, 프롬프트 템플릿을 처리하는 통합 계층이다. 랭그래프는 상태, 제어 흐름, 그래프를 관리하는 오케스트레이션 엔진이다. 대부분의 프로덕션 팀은 둘을 함께 사용하지만, 에이전트 로직이 자리 잡는 곳은 랭그래프다.
> 솔직히 말하면, 대부분의 팀은 프레임워크를 너무 과하게 고른다. 에이전트가 모델 하나와 몇 가지 도구를 호출할 뿐이라면 랭그래프는 필요 없다. 공급자 SDK와 몇 번의 도구 호출만으로도 어떤 그래프보다 더 빨리 프로덕션에 도달할 수 있다.
공급자 SDK는 상태를 대신 관리해준다. 랭그래프는 모든 상태 전이를 명시적으로 정의하게 한다. 직접 만들면 직접 굴려야 한다. 종속 위험은 스택에서 가장 높다. 오케스트레이션 코드는 이식되지 않는다. 랭그래프 에이전트를 크루AI(CrewAI)용으로 다시 쓰는 것은 새 코드베이스를 만드는 일이다. 공급자 SDK는 더 나쁘다. 한 모델에도 묶이기 때문이다. 프로토타입에서 프로덕션으로 가는 간극은 크다. 데모는 아무것도 잘못되지 않기 때문에 작동한다. 프로덕션에서는 도구 실패, 재시도, 타임아웃, 그리고 에이전트가 행동하기 전에 승인해야 하는 사람들을 처리해야 한다.
고른 프레임워크가 마이그레이션 비용을 결정한다. 공급자 SDK는 시작이 가장 빠르지만 한 모델에 묶인다. 랭그래프는 이식성이 있지만 복잡하다. 직접 만들면 에이전트가 래퍼를 넘어 성장하기 전까지 완전한 제어권을 얻는다. MCP는 이 세 진영 모두를 가로질러 이전되는 유일한 계층이다.
## 계층 5: 평가와 관측 가능성
*에이전트가 제 일을 하고 있는지 측정하는 방식이다. 실행을 추적하고, 출력을 채점하며, 사용자가 발견하기 전에 회귀를 잡아낸다.*
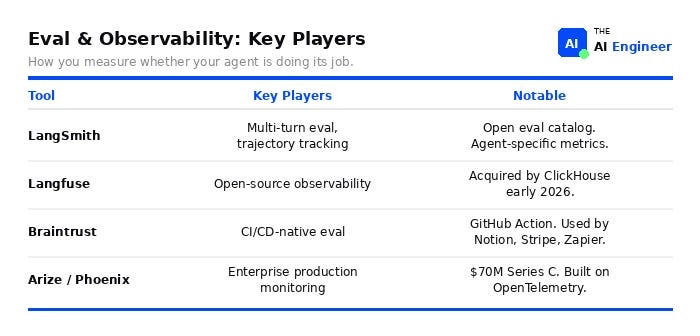
평가와 관측 가능성: 주요 플레이어
이 계층은 2024년에는 거의 존재하지 않았다. 이제 이 계층이 간극이다. [랭체인의 에이전트 엔지니어링 현황(State of Agent Engineering)](https://www.langchain.com/state-of-agent-engineering) 설문에 따르면, 프로덕션 에이전트를 운영하는 팀의 89%는 관측 가능성을 구현했지만, 평가를 구현한 팀은 52%뿐이었다. 이 37%포인트의 격차에서 프로덕션 품질이 무너진다.
“인프라로서의 평가(evaluation as infrastructure)”는 세 단계로 수렴하고 있다. 모든 PR에서 빠르게 확인하는 검사, 예컨대 에이전트가 올바른 도구를 호출했는지 보는 단계가 있다. 다음으로 LLM을 사용해 출력 품질을 판단하는 야간 회귀 스위트가 있다. 마지막으로 에이전트 성능이 드리프트할 때 경고하는 지속적 프로덕션 모니터링이 있다. 메모리 관리를 위한 컨텍스트-벤치(Context-Bench), 오류 복구를 위한 리커버리-벤치(Recovery-Bench), 코딩 에이전트를 위한 터미널-벤치(Terminal-Bench)처럼 에이전트 특화 벤치마크도 새로 등장했다.
> 솔직히 말하면, 대부분의 팀은 프로덕션에서 문제가 터질 때까지 평가를 건너뛴다. 그때가 되면 앞이 보이지 않는 상태로 디버깅하게 된다. 이런 문제가 없는 팀은 배포 전에 평가를 만들었다.
여기서 상태 관리는 중요하다. 에이전트가 12단계를 실행하는데 3단계에서 잘못된 도구를 골랐다면, 4~12단계는 이미 망한 것이다. 평가가 최종 출력만 확인한다면 이유를 절대 알 수 없다. 종속 위험은 보통이다. 대부분의 도구가 오픈텔레메트리(OpenTelemetry) 추적을 내보내므로 관측 가능성 공급자를 바꾸는 것은 가능하다. 하지만 평가 프레임워크를 바꾸려면 테스트 스위트를 다시 만들어야 한다. 프로토타입에서 프로덕션으로 가는 간극은 모든 계층 중 가장 크다. 대부분의 프로토타입에는 평가가 전혀 없다. 프로덕션 사용자가 실패를 대신 찾아줄 때까지는 고통을 느끼지 못한다.
현재 평가 도구는 단일 턴과 도구 호출 평가에 가장 강하다. 다중 에이전트 평가, 긴 지평선 작업 평가, 시간이 지나며 학습하는 에이전트 평가는 모두 아직 풀리지 않은 문제다. 에이전트가 이런 일을 한다면, 오늘날 플랫폼이 제공하는 것 이상으로 커스텀 평가 인프라가 필요하다.
## 계층 6: 가드레일과 안전
*에이전트가 해서는 안 되는 일을 못 하게 막는 방식이다. 입력을 필터링하고, 도구 호출을 승인하며, 출력을 검증한다.*
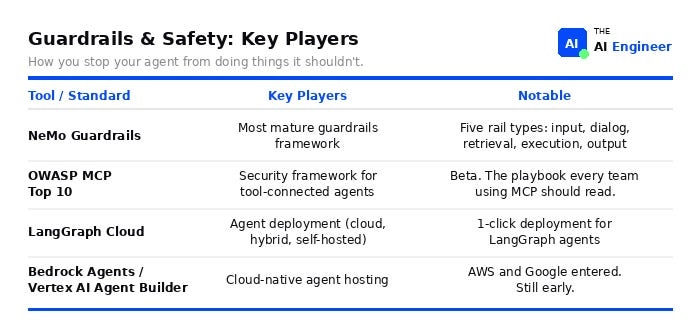
가드레일과 안전: 주요 플레이어
에이전트 가드레일은 LLM 가드레일과 별개의 분야가 됐다. 2024년에 가드레일은 모델의 입력·출력 필터를 뜻했다. 2026년에 에이전트는 도구를 호출하고, 돈을 쓰며, 행동을 취한다. 이제 가드레일은 도구 호출 승인, 속도 제한 적용, 에이전트가 실제로 한 일의 검증을 뜻한다.
“행동 전 가드레일(guardrails before action)” 패턴은 혹독한 경험을 통해 배운 팀들에서 나왔다. 이들은 이제 출력 계층이 아니라 도구 실행 계층에서 권한 부여를 강제한다. 응답을 필터링할 때쯤이면 에이전트는 이미 이메일을 보낸 뒤다. OWASP는 MCP 톱 10(베타)을 발표했다. 도구에 연결된 에이전트를 위한 첫 실질적 보안 체크리스트다. 배포는 여전히 직접 해야 한다. 랭그래프 클라우드(LangGraph Cloud)와 베드록 에이전트(Bedrock Agents)가 있긴 하지만, 대부분의 프로덕션 팀은 여전히 패스트API(FastAPI)와 자체 인프라로 배포한다. 이 계층에서 가장 많은 예기치 못한 엔지니어링 시간을 쓰게 될 것이다.
> 솔직히 말하면, 이 계층은 스택에서 가장 미성숙하다. 지배적인 프레임워크도, 확립된 패턴도 없다. 정책 코드를 처음부터 직접 써야 한다.
가드레일은 에이전트가 다음에 무엇을 해서는 안 되는지 결정하려면, 지금 무엇을 하고 있는지 알아야 한다. 이는 에이전트 상태를 실시간으로 추적해야 한다는 뜻이다. 종속 위험은 낮다. 대부분의 가드레일은 직접 작성하는 커스텀 정책 코드이기 때문이다. 니모 가드레일(NeMo Guardrails)이 프레임워크에 가장 가까운 것이지만, 그래도 대부분의 규칙은 처음부터 직접 작성해야 한다. 프로토타입에서 프로덕션으로 가는 간극은 사실상 무한대다. 데모에는 가드레일이 없다. 아무도 그것을 망가뜨리려 하지 않기 때문이다. 프로덕션에서는 그렇게 될 것이다.
현재 가드레일 도구는 단일 에이전트 시스템에 초점을 맞춘다. 에이전트가 서로에게 위임하는 다중 에이전트 워크플로를 운영한다면, 에이전트 경계를 넘나드는 가드레일 전파는 아직 풀리지 않은 문제다. 커스텀 권한 부여 로직이 필요하다.
## 무엇을 만들고 있는가?
이 질문이 프레임워크 혼란을 가른다. 에이전트 유형이 어느 계층에 투자할지, 각 계층에서 어떤 도구를 고를지 결정한다.
**상태 없는 도구 호출기(stateless tool caller)**는 지식 베이스에서 질문에 답하고, 주문을 조회하거나, 재고를 확인한다. 필요한 것은 공급자 SDK, MCP, 포스트그레스다. 프레임워크도, 벡터 데이터베이스도 필요 없다. 주말 프로젝트다.
**다단계 워크플로(multistep workflow)**는 환불을 처음부터 끝까지 처리하고, 다섯 파일에 걸친 PR을 검토하거나, 지원 티켓을 분류해 라우팅한다. 단계들이 서로 의존하고, 중간에 일이 실패하며, 에이전트가 행동하기 전에 사람이 승인해야 한다. 랭그래프, MCP, 평가가 필요하다. 이런 에이전트는 조용히 깨지므로 배포 전에 평가를 만들어라.
**학습하는 에이전트(agent that learns)**는 세션을 넘어 사용자의 선호를 기억하고, 시간이 지나며 코드베이스를 더 잘 이해하며, 몇 주에 걸친 프로젝트 컨텍스트를 추적한다. 메모리 우선 아키텍처, 벡터 DB, 평가가 필요하다. 오케스트레이션은 쉬운 부분이다. 어려운 부분은 무엇을 기억할지, 무엇을 버릴지, 오래된 컨텍스트가 새 답변을 오염시키지 않게 어떻게 막을지 결정하는 것이다.
**다중 에이전트 시스템(multi-agent system)**에는 다른 에이전트에게 위임하고, 연구 작업을 전문가들 사이에 나누거나, 병렬 작업 흐름을 실행하는 에이전트들이 있다. 전체 스택이 필요하다. 에이전트 두 개가 서로 컨텍스트를 주고받는 것만으로도 이미 디버깅이 어렵다. 다섯 개가 되면 모든 핸드오프에 대한 추적 수준 평가 없이는 불가능하다. 두 번째 에이전트를 만들기 전에 평가 인프라를 먼저 만들어라.
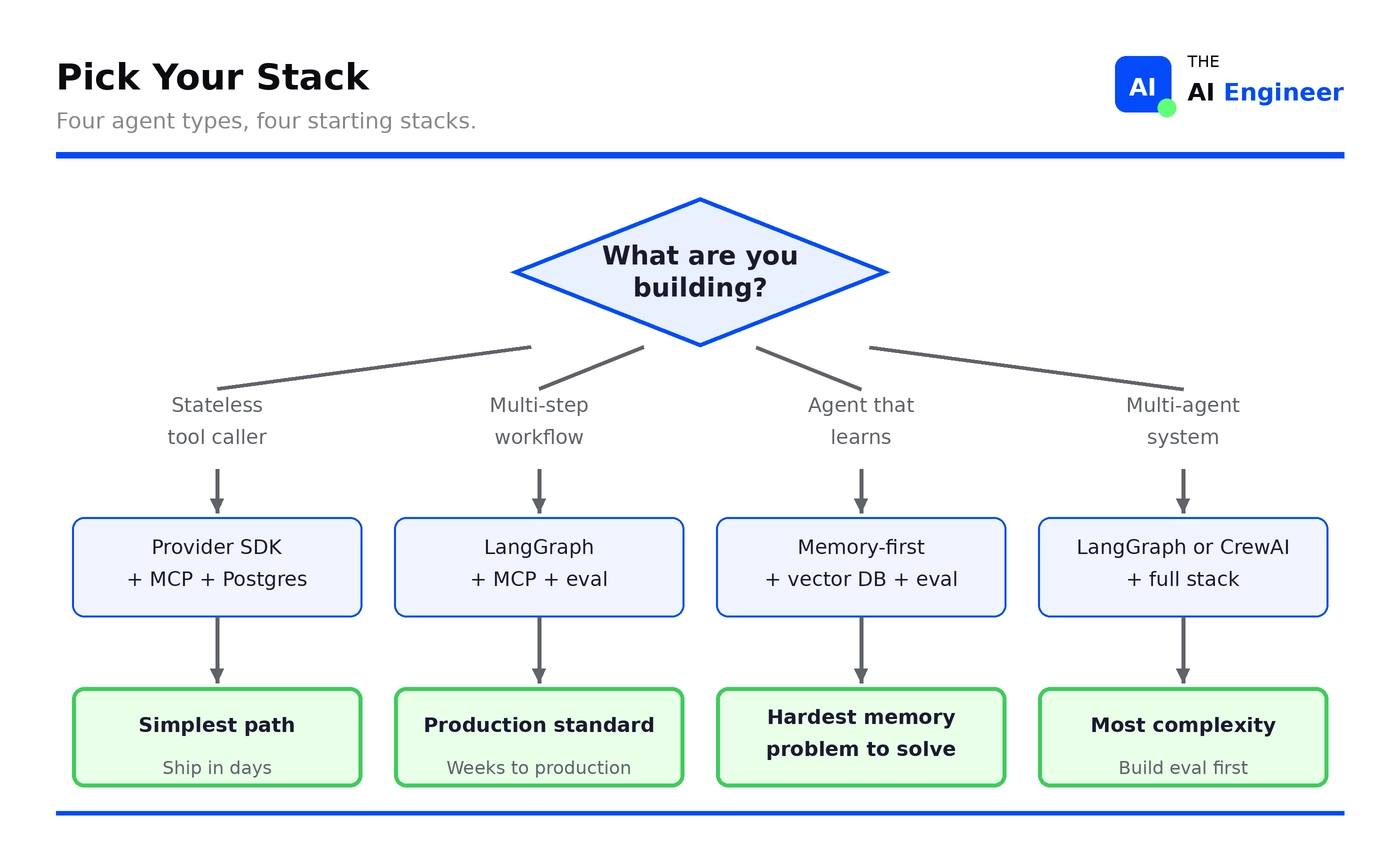
스택 선택하기
## 코딩 에이전트: 여섯 계층이 모두 작동하는 모습
커서(Cursor), 클로드 코드(Claude Code), 코덱스(Codex), 윈드서프(Windsurf) 같은 코딩 에이전트는 AI 에이전트 스택이 가장 잘 입증된 애플리케이션이다. 여섯 계층이 함께 작동한다.
추론 계층에서 이 도구들은 매일 수억 건의 요청을 처리한다. 커서는 작업에 따라 클로드, GPT-4, 자체 파인튜닝 모델 사이에서 라우팅한다. 프로토콜 계층에서는 MCP 서버가 에디터, 터미널, 파일 시스템, 깃(Git)에 연결된다. 이것이 에이전트가 코드를 읽고 명령을 실행하는 방식이다. 메모리 계층은 재순위화(reranking)를 곁들인 코드베이스 인식 검색을 사용한다. 에이전트는 저장소 전체를 읽지 않는다. 특정 수정에 중요한 파일만 검색한다.
프레임워크 계층에서 이들은 RL 루프를 갖춘 커스텀 오케스트레이션 시스템이다. 랭그래프도 아니고, 공급자 SDK도 아니다. 코드 생성, 리뷰, 반복을 위해 목적에 맞게 만든 제어 흐름이다. 평가 계층에서 커서는 사용자가 제안을 수락하거나 거절하는지에 따라 90분마다 수락률 모델을 다시 학습한다. 이것이 프로덕션에서 지속적으로 실행되는 평가다. 그리고 가드레일 계층에서는 샌드박스 실행이 폭주하는 에이전트를 막는다. 에이전트는 코드를 쓰고 실행할 수 있지만, 접근 가능한 대상을 제한하는 컨테이너 안에서만 가능하다.
## AI 에이전트 스택 치트 시트
모든 계층은 평가 프레임워크의 세 질문으로 점수를 매겼다. 얼마나 많은 상태를 관리해야 하는가? 얼마나 많은 벤더 종속을 감수할 수 있는가? 데모에서 프로덕션으로 가는 일이 얼마나 어려운가?
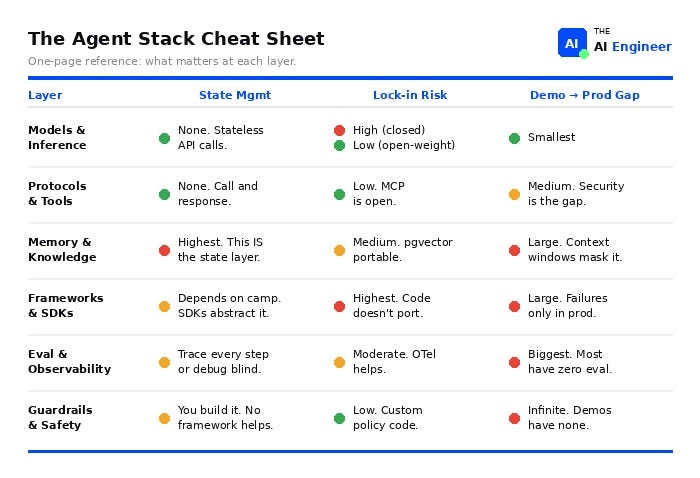
에이전트 스택 치트 시트
## 더 큰 그림
대부분의 팀은 아직도 2024년처럼 만들고 있다. 상태가 필요한지도 모르면서 랭그래프를 고른다. 포스트그레스를 넘어선 것도 아닌데 벡터 데이터베이스를 추가한다. 제대로 작동하는 에이전트 하나도 배포하지 않은 채 다중 에이전트 아키텍처를 설계한다. 위의 의사결정 흐름도가 존재하는 이유는 도구 호출 챗봇과 다중 에이전트 연구 시스템이 공유하는 인프라가 거의 없기 때문이다. 둘을 똑같이 취급하면 첫 번째는 과하게 만들고, 두 번째는 부족하게 만든다.
이 단계를 넘어선 팀들은 분기마다 한 번이 아니라 배포할 때마다 평가를 실행한다. 이들의 가드레일은 출력 계층이 아니라 도구 호출 계층에 있다. 이들의 메모리 아키텍처는 설계된 것이지, 프레임워크 기본값에서 물려받은 것이 아니다. 대부분의 팀은 그 반대를 배포한다. 평가가 없고, 출력만 필터링하며, 컨텍스트 창이 숨 막힐 때까지 커지는 시스템 프롬프트를 쓴다. 격차는 인재나 예산의 문제가 아니다. 여섯 계층을 반쯤 다 만드는 대신, 특정 에이전트에 어떤 계층이 중요한지 아는가의 문제다.
스택은 무너져 합쳐질 것이다. 공급자 SDK는 이미 메모리, 도구 호출, 기본 평가를 단일 API 안으로 흡수하고 있다. 2027년 초가 되면 대부분의 팀은 각 계층을 따로 만들지 않을 것이다. 모델 공급자가 제공하는 점점 더 의견이 강한 스택을 받게 될 것이고, 사용 사례의 80%에는 그것으로 충분할 것이다. 나머지 20%, 즉 기본값이 깨지는 규모의 에이전트는 여전히 모든 계층을 커스텀으로 만들 것이다. 하지만 그때도 프로덕션에서 무언가 실패하면 어느 계층이 실패했는지 알아야 한다. 이 글의 목적이 바로 그것이다.
## 출처
1. “[AI 에이전트 스택](https://www.letta.com/blog/ai-agents-stack),” 레타, 2024년 11월.
2. “[모델 컨텍스트 프로토콜 기증과 에이전트형 AI 재단 설립](https://www.anthropic.com/news/donating-the-model-context-protocol-and-establishing-of-the-agentic-ai-foundation),” 앤트로픽, 2025년 12월.
3. “[11개 범주로 매핑한 120개 이상의 에이전트형 AI 도구 \[2026\]](https://www.stackone.com/blog/ai-agent-tools-landscape-2026/),” 스택원(StackOne), 2026년 2월.
4. 헨리크 플라테(Henrik Plate), 대런 마이어(Darren Meyer), *[의존성 관리 보고서(Dependency Management Report)](https://www.endorlabs.com/lp/dependency-management-report)*, 엔도어 랩스, 2026년 1월.
5. 제이슨 류(Jason Liu), [컨텍스트 엔지니어링 시리즈: 더 나은 에이전트형 RAG 시스템 만들기](https://jxnl.co/writing/2025/08/28/context-engineering-index/), 2025년 8월.
6. “[랭체인과 랭그래프 에이전트 프레임워크, v1.0 이정표에 도달](https://www.langchain.com/blog/langchain-langgraph-1dot0),” 랭체인, 2025년 10월.
7. *[에이전트 엔지니어링 현황(State of Agent Engineering)](https://www.langchain.com/state-of-agent-engineering)*, 랭체인, 2025년 12월.
8. 윈페이 바이(Yunfei Bai), 앨리 콜린(Allie Colin), 카시프 임란(Kashif Imran), 위니 슝(Winnie Xiong), “[AI 에이전트 평가: 아마존에서 에이전트형 시스템을 구축하며 얻은 현실의 교훈](https://aws.amazon.com/blogs/machine-learning/evaluating-ai-agents-real-world-lessons-from-building-agentic-systems-at-amazon/),” 아마존, 2026년 2월.
9. [OWASP MCP 톱 10](https://github.com/OWASP/www-project-mcp-top-10/), OWASP.
게시글 주제: [AI와 ML](https://www.oreilly.com/radar/topics/ai-ml/ "AI & ML")