Metadata
# (요약) AI 에이전트가 2019년 마이크로서비스의 실수를 반복하는 이유
1. 마이크로서비스(microservices)는 대규모 애플리케이션을 독립적으로 배포할 수 있는 작은 서비스로 나눠 소프트웨어 개발 방식을 바꿨음.
2. 개발과 확장은 쉬워졌지만, 시스템 전체의 동작을 파악하기 어려워지는 새로운 문제가 생겼음.
3. AI 에이전트(AI agents)도 하나의 애플리케이션 안에 있던 워크플로를 작업별 에이전트로 분리하면서 같은 경로를 따르고 있음.
4. 개별 구성 요소는 설계대로 작동하더라도 전체 워크플로의 결과는 점차 나빠질 수 있음.
5. 에이전트 시스템은 훨씬 빠르고 저렴하게 만들 수 있어 같은 아키텍처 실수를 더 큰 규모로 반복하기 쉬움.
6. 필자도 설계 문서에 이름을 올리고 워크플로를 세 에이전트로 분리했으며, 당시 판단의 상당 부분은 지금도 타당하다고 생각함.
7. 그러나 시스템이 조용히 제 기능을 잃었을 때 이를 어떻게 알아낼 것인지에 대해서는 답을 준비하지 못했음.
8. 몇 달 뒤 품질 검토에서 검토자가 이상을 감지했지만, 계측 도구는 이를 포착하지 못했음.
9. 지연시간(latency)과 오류율은 정상이었고 모든 서비스가 예정된 응답을 반환했지만, 출력 품질은 서서히 저하되고 있었으며 원인 추적에 약 3주가 걸렸음.
10. 첫 번째 에이전트가 전달한 문서를 요약하는 에이전트가 중요도가 낮다고 판단한 필드를 누락했고, 후속 에이전트는 그 필드 없이 확신에 찬 권고를 내렸음.
11. 모든 에이전트가 설계대로 작동했는데도 결과는 틀렸으며, 필자는 마이크로서비스 시대에 제품 업무를 하며 같은 패턴을 이미 경험했으므로 이를 예상했어야 했다고 돌아봄.
## **The hangover we already paid for**
12. 대부분의 팀에서 모놀리스(monolith)를 분해한 결정은 타당했지만, 분해한다고 시스템의 어려운 문제가 사라지는 것은 아니라는 점을 간과했음.
13. 어려운 문제는 서비스 사이의 틈으로 이동했고, 제품 전체를 책임지는 사람들은 이를 더 이상 볼 수 없게 됐음.
14. 그 대가는 2019년 무렵 장애 알림이 아니라 납기 지연으로 나타났음.
15. 팀들은 추적 기능이 제한적이고 계약 버전 관리(contract versioning)도 없는 상태에서 수백 개의 서비스를 운영했음.
16. 엔지니어들이 서비스들을 뒤지는 데 몇 주씩 쓰면서, 서비스 분리 이전보다 출시가 느려졌음.
17. 에이전트는 저장소와 배포 파이프라인 대신 반나절과 프롬프트만으로 만들 수 있어 같은 과정을 더 빠르게 겪고 있음.
18. 생성 비용이 낮아 제품팀이 별도 협의 없이 에이전트를 만들고, 어떤 에이전트가 무엇을 하는지 아무도 관리하지 않는 상황이 발생함.
## **What breaks, and what it costs you**
19. 젬리(Cemri)와 공동 연구진은 인기 있는 멀티에이전트 프레임워크 7개에서 실행 추적 1,600여 건을 주석 처리하고, 반복되는 실패 유형 14개를 분류한 [MAST 연구](https://proceedings.neurips.cc/paper_files/paper/2025/hash/b1041e52d3be19f0a9bc491657488e4a-Abstract-Datasets_and_Benchmarks_Track.html)를 NeurIPS 2025에서 발표했음.
20. 이 연구에서 대부분의 실패는 내부 모델보다 시스템 명세와 에이전트 간 조정 방식에서 비롯됐음.
21. 에이전트 목록 관리(inventory)는 사소해 보이지만 실제로는 어려운 작업임.
22. 서비스 난립은 적어도 쿠버네티스(Kubernetes) 매니페스트에 드러났지만, 에이전트는 제품 인터페이스와 워크플로 도구, 개인이 주말에 만든 업무 자동화 안에서도 생성됨.
23. 규정 준수 검토자가 특정 의사결정에 관여한 자동화 시스템을 물을 때야 보유한 에이전트를 파악하려 한다면 이미 늦은 것임.
24. 필자의 사례에서는 가시성 부족으로 원인 규명에 3주가 소요됐음.
25. 에이전트가 다른 에이전트와 검색 계층(retrieval layer)을 연쇄 호출하고 각 단계의 모델이 다음에 전달할 정보를 결정한다면, 전체 경로에서 유지되는 추적 맥락(trace context)이 필요함.
26. 대부분의 기술 스택은 호출별 프롬프트와 응답만 기록하므로, 각 단계는 보여도 실제로 실패한 전체 연결 과정은 보이지 않음.
27. 필자가 가장 우려하는 실패는 잘못된 정보 위에 확신이 누적되는 현상임.
28. 분산 시스템(distributed systems)은 서비스가 HTTP 500 오류를 반환하면 호출자가 중단할 수 있다는 점에서, 실패가 뚜렷하게 드러나는 것이 오히려 장점이었음.
29. 에이전트는 그럴듯하고 유창하게 실패하므로, 상위 에이전트가 잘못된 요약을 생성해도 하위 에이전트는 경고 없이 이를 바탕으로 확신에 찬 추론을 이어감.
30. 결과가 사용자에게 도달할 때는 최초 근거가 뒷받침하지 못하는 수준의 확신을 전달하게 됨.
31. API 계약은 응답 형식을 버전 관리 없이 바꾸면 변질됐고, 이를 빌드 시점에 탐지하는 도구가 마련됐음.
32. 에이전트 계약은 시스템 프롬프트(system prompt) 수정만으로 변질될 수 있지만, 스키마 차이 비교(schema diff)나 타입 검사(type check)가 이를 잡아주지 않음.
33. 하위 에이전트가 달라진 출력을 받아 아무에게도 알리지 않고 적응하기 때문에, 계약 변화가 명확한 고장으로 드러나지 않을 수 있음.
## **What carries over from microservices**
34. 레지스트리(registry)는 가장 저렴하게 구축할 수 있으면서도 가장 먼저 생략되는 요소임.
35. 마이크로서비스에서 서비스별 소유자와 범위를 기록한 카탈로그를 유지했듯, 에이전트도 같은 정보와 함께 호출이 허용된 대상을 명시해야 함.
36. 상관관계 ID(correlation ID)는 바로 이런 문제를 해결하려고 도입됐으므로, 기존 분산 추적(tracing) 방식을 거의 그대로 적용할 수 있음.
37. OpenTelemetry의 [GenAI 의미 규약(semantic conventions)](https://github.com/open-telemetry/semantic-conventions-genai)을 활용하면 에이전트 실행을 서로 무관한 로그의 집합이 아니라 스팬 트리(span tree)로 표현할 수 있음.
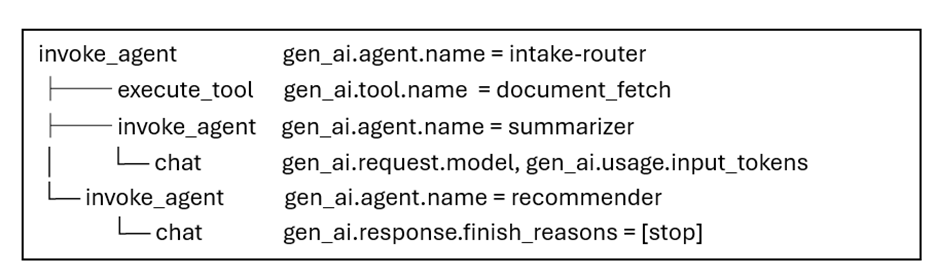
38. 필자의 시스템에서 이런 스팬을 기록했다면 요약 에이전트와 권고 에이전트의 실행을 하나의 트레이스(trace)에서 나란히 비교해, 3주간 추적하는 대신 누락 필드를 차이 비교로 확인할 수 있었을 것임.
39. 해당 규약은 계속 변하고 있으므로, 속성 이름은 자체적인 얇은 매핑 계층(mapping layer) 뒤에 두는 것이 좋음.
40. 추적으로 조사 시간을 줄이는 데 더해, 프롬프트 변경이 운영 환경에 배포되기 전에 정보 누락을 잡는 테스트도 필요함.
41. 마이크로서비스의 계약 테스트(contract testing) 원칙을 적용해 하위 에이전트가 의존하는 정보를 정의하고, 상위 에이전트 변경 후에도 해당 정보가 보존되는지 검사해야 함.
42. 필자의 사례에서는 요약 결과가 권고 에이전트에 필요한 정보를 유지하는지 평가해야 함.
43. 프롬프트를 버전 관리하고, 변경 사항이 해당 평가를 통과한 경우에만 배포하도록 해야 함.
44. Google의 A2A 인프라에 행동 계약 모델링(behavioral contract modeling)과 생명주기 검증(lifecycle verification)을 적용한 프로토콜 계층 기법 [SEMAP](https://arxiv.org/abs/2510.12120)은 초기 효과를 보여주는 사례임.
45. SEMAP은 함수 수준 코딩 과제를 MAST 기준으로 평가했을 때 실패가 최대 약 70% 감소했다고 보고했음.
46. 신뢰 경계(trust boundary)는 설계 검토에서 반드시 따져야 할 문제임.
47. 2019년에는 서비스가 보안 경계 내부에 있다는 이유만으로 신뢰해서는 안 된다는 점을 배웠으며, 서비스 메시(service mesh)는 상당 부분 이를 위한 것이었음.
48. 에이전트 역시 내부에서 선의로 개발했다는 이유만으로 광범위한 도구 접근 권한을 부여해서는 안 됨.
49. 허용되는 행동은 정중한 요청을 담은 시스템 프롬프트가 아니라, 모델이 말로 우회할 수 없는 정책 계층(policy layer)에서 강제해야 함.
50. 비용 문제에서는 마이크로서비스와 에이전트의 유사성이 깨짐.
51. 재시도 루프에 갇힌 마이크로서비스는 CPU를 소비하고 새벽 3시에 경보를 울리지만, 루프에 갇힌 에이전트는 매번 실제 비용을 발생시키면서도 자원 포화처럼 눈에 띄는 징후를 보이지 않을 수 있음.
52. 이 문제는 장애보다 단위 경제성(unit economics) 악화로 나타나 인프라 담당자보다 제품 책임자의 부담이 되며, 결국 제품 관리자(PM)가 청구 주기 말에 비용을 설명해야 함.
## **What I ask before approving a split**
53. 필자는 멀티에이전트 시스템(multi-agent systems)을 반대하는 것이 아니며, 서비스 분리와 마찬가지로 충분한 가치를 낼 수 있다고 봄.
54. 핵심은 이전 전환에서 발생한 5년의 지체를 반복하지 않고, 운영 관행을 아키텍처와 함께 발전시키는 것임.
55. 이를 실현하도록 이끌기에 가장 적합한 사람은 대개 제품 제공을 책임지는 사람임.
56. 분리를 승인하기 전에 확인할 첫 번째 사항은 하나의 요청을 처음부터 끝까지 따라가며 각 에이전트가 무엇을 왜 결정했는지 재구성할 수 있는지임.
57. 이를 할 수 없다면 디버깅할 수 없는 시스템을 만드는 셈임.
58. 두 번째 사항은 상위 에이전트가 틀릴 수 있는지가 아니라, 실제로 틀렸을 때 어떤 일이 벌어지는지임.
59. 다음 에이전트가 평소처럼 계속 실행하는 것이 답이라면, 실패 대응 방식을 설계한 것이 아니라 실패 자체를 설계해 실행 중인 셈임.
60. 세 번째 사항은 에이전트의 소유자가 누구이며 도구 접근 권한이 어디에서 강제되는지이고, 시스템 프롬프트는 권한 강제 수단이 아님.
61. 네 번째 사항은 처리량이 현재의 10배가 됐을 때 비용이 얼마이며 비용이 예상에서 벗어나면 무엇이 실행을 중단시키는지임.
62. 비용 문제는 먼저 자발적으로 꺼내는 사람이 없으므로 초기부터 질문해야 함.
63. 서비스 분해를 가장 잘 관리한 팀들은 처음부터 추적과 계약 테스트를 개발 과정에 포함했음.
64. 이러한 관행은 서비스 간 상호작용을 이해하고 변경 이후에도 기대 동작이 유지되는지 검증하는 데 도움이 됐음.
65. 지금은 한두 번의 스프린트로 끝낼 수 있는 작업도, 에이전트 40개를 운영한 뒤 고객 데이터에 관여한 에이전트를 확인해야 하는 시점에는 훨씬 많은 노력이 드는 작업이 됨.