Metadata
# (요약) 1조 파라미터 코딩 에이전트에 수조 개의 토큰을 제공하는 방법
1. Modal이 2026년 9월 23일 공개한 글로, Moonshot AI의 Kimi K2.6를 코딩 에이전트용으로 대규모 서빙하면서 추론 성능과 비용 효율을 최적화한 과정임.
2. 소프트웨어 엔지니어는 핵심 도구가 된 에이전트뿐 아니라 그 내부에서 작동하는 대규모 생성형 언어 모델의 추론(inference)도 이해해야 함.
3. 추론은 다른 컴퓨터 활용 분야를 합친 것보다 더 많은 연산 자원을 소비하고 더 큰 가치를 창출할 가능성이 있기 때문임.
4. 코딩 에이전트 추론 서비스에는 하드웨어의 이론적 최대 성능 대비 높은 활용률이라는 **상대적 성능**과, 방대한 연산을 실제로 수행하는 **절대적 성능**이 모두 필요함.
5. 현대의 텐서 코어(Tensor Core)는 초당 페타플롭(petaFLOP) 규모로 연산하며, 소프트웨어 개발을 자동화할 수준의 모델은 1조 개 규모의 파라미터를 단일 요청에서도 초당 여러 차례 접근해야 함.
6. 이러한 하드웨어·엔지니어링 비용을 분산하려면 대략 수조 개의 입출력 토큰을 처리하는 규모가 필요함.
7. Modal은 이 규모의 코딩 에이전트 추론 서비스를 직접 운영하고 고객의 유사 서비스도 지원하며, [OpenRouter](https://openrouter.ai/provider/modal), [Vercel AI Gateway](https://vercel.com/ai-gateway/models/providers/modal), [Shared Endpoints](https://modal.com/endpoints/)를 통해 서비스를 제공함.
8. 이 글은 [Kimi K2.6](https://huggingface.co/moonshotai/Kimi-K2.6) 최적화를 다루지만, 시퀀스 모델링·하드웨어·확장의 기본 원리는 천천히 변하므로 [Kimi K3](https://modal.com/library/moonshot/kimi-k3) 같은 후속 모델에도 상당 부분 적용됨.
9. 최적화 결과 복제본(replica) 하나의 사용자별 생성 속도는 2.8배, 전체 사용자에 대한 처리량은 5.6배 개선되었음.
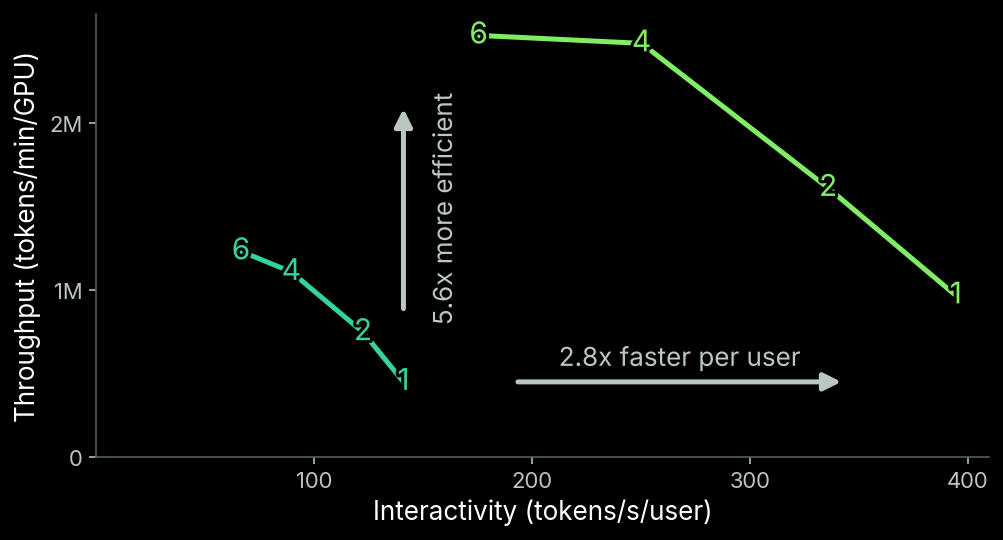
10. 위 그래프의 가로축은 사용자별 초당 디코딩 토큰 수인 상호작용성(interactivity), 세로축은 GPU당 분당 전체 토큰 수인 처리량(throughput)이며, 각 점에는 동시 사용자 수가 표시되어 있음.
11. 이러한 차이는 비싸면서 사용자 경험도 나쁜 서비스와 가격 경쟁력·사용자 경험을 모두 확보한 서비스의 차이이며, [토큰 생성 타이밍 비교 영상](https://modal-cdn.com/blog/videos/trillion-tokens-trillion-parameters-token-timing-simulator.mp4)에서 확인할 수 있음.
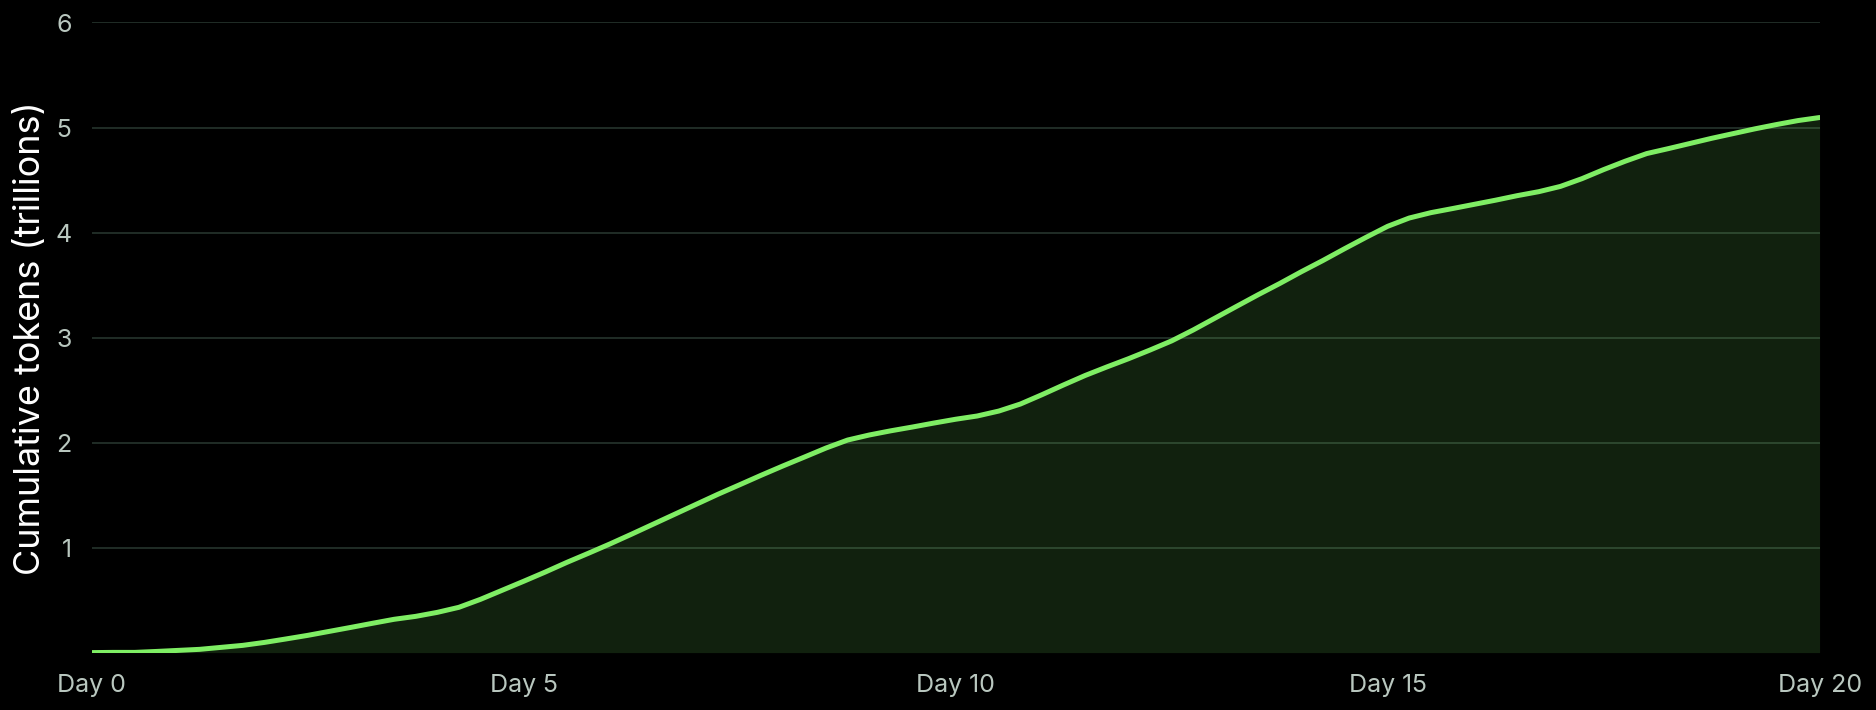
12. 단일 컨테이너 복제본을 대규모 배포로 확장한 결과, 한 서비스는 하루 수천억 개, 누적 수조 개의 토큰을 처리했음.
13. 글의 목적은 일반 소프트웨어 엔지니어도 이러한 성능 엔지니어링을 이해하고, 필요하면 Modal의 [Dedicated Endpoint](https://modal.com/docs/guide/endpoints) 등으로 직접 구현하도록 돕는 것임.
## 먼저 워크로드를 이해함
14. 워크로드 이해는 개별 요청의 응답을 생성하는 시퀀스 모델의 구조와 여러 요청 사이의 관계를 파악하는 두 단계로 나뉨.
### 최신 코딩 에이전트는 입력을 병렬 처리하고 출력을 순차 추론하는 1조 파라미터 신경망 시퀀스 모델로 작동함
15. 현대 코딩 에이전트는 주로 비지도 마스킹 시퀀스 예측으로 사전학습하고, 출력 소프트웨어의 정확성을 강화하는 방식으로 후학습한 확률적 유니코드 시퀀스 생성 모델에 기반함.
16. 컴파일러의 파서처럼 원시 문자열이 아니라 토큰화된 시퀀스를 처리하며, 다음 출력 토큰을 추정하는 과정을 추론이라고 부름.
17. 기반 모델은 하이브리드 어텐션(hybrid attention)과 전문가 혼합(mixture-of-experts, MoE)을 사용하는 트랜스포머 신경망이며, 토큰별 연산과 토큰 간 연산을 함께 수행함.
18. 어텐션(attention)은 토큰 간 연산을, MoE는 토큰별 연산 대부분을 담당하는 동적 라우팅 블록 희소 행렬곱을 뜻하며, 이 연산들이 내부 잠재 표현(latent representation)을 반복 갱신함.
19. 모델 내부 작동 원리는 Anthropic의 2021년 글 [「A Mathematical Framework for Transformer Circuits」](https://transformer-circuits.pub/2021/framework/index.html)를 참고할 수 있음.
20. 한 번의 순전파(forward pass)는 상당한 내부 상태와 각 시퀀스 위치의 다음 토큰 확률분포를 생성하며, 자신의 이전 출력을 바탕으로 다음 출력을 예측하므로 자기회귀(autoregressive) 모델링이라고 부름.
21. 클라이언트 요청에 응답하려면 다음 그림처럼 여러 순전파를 연결해야 함.
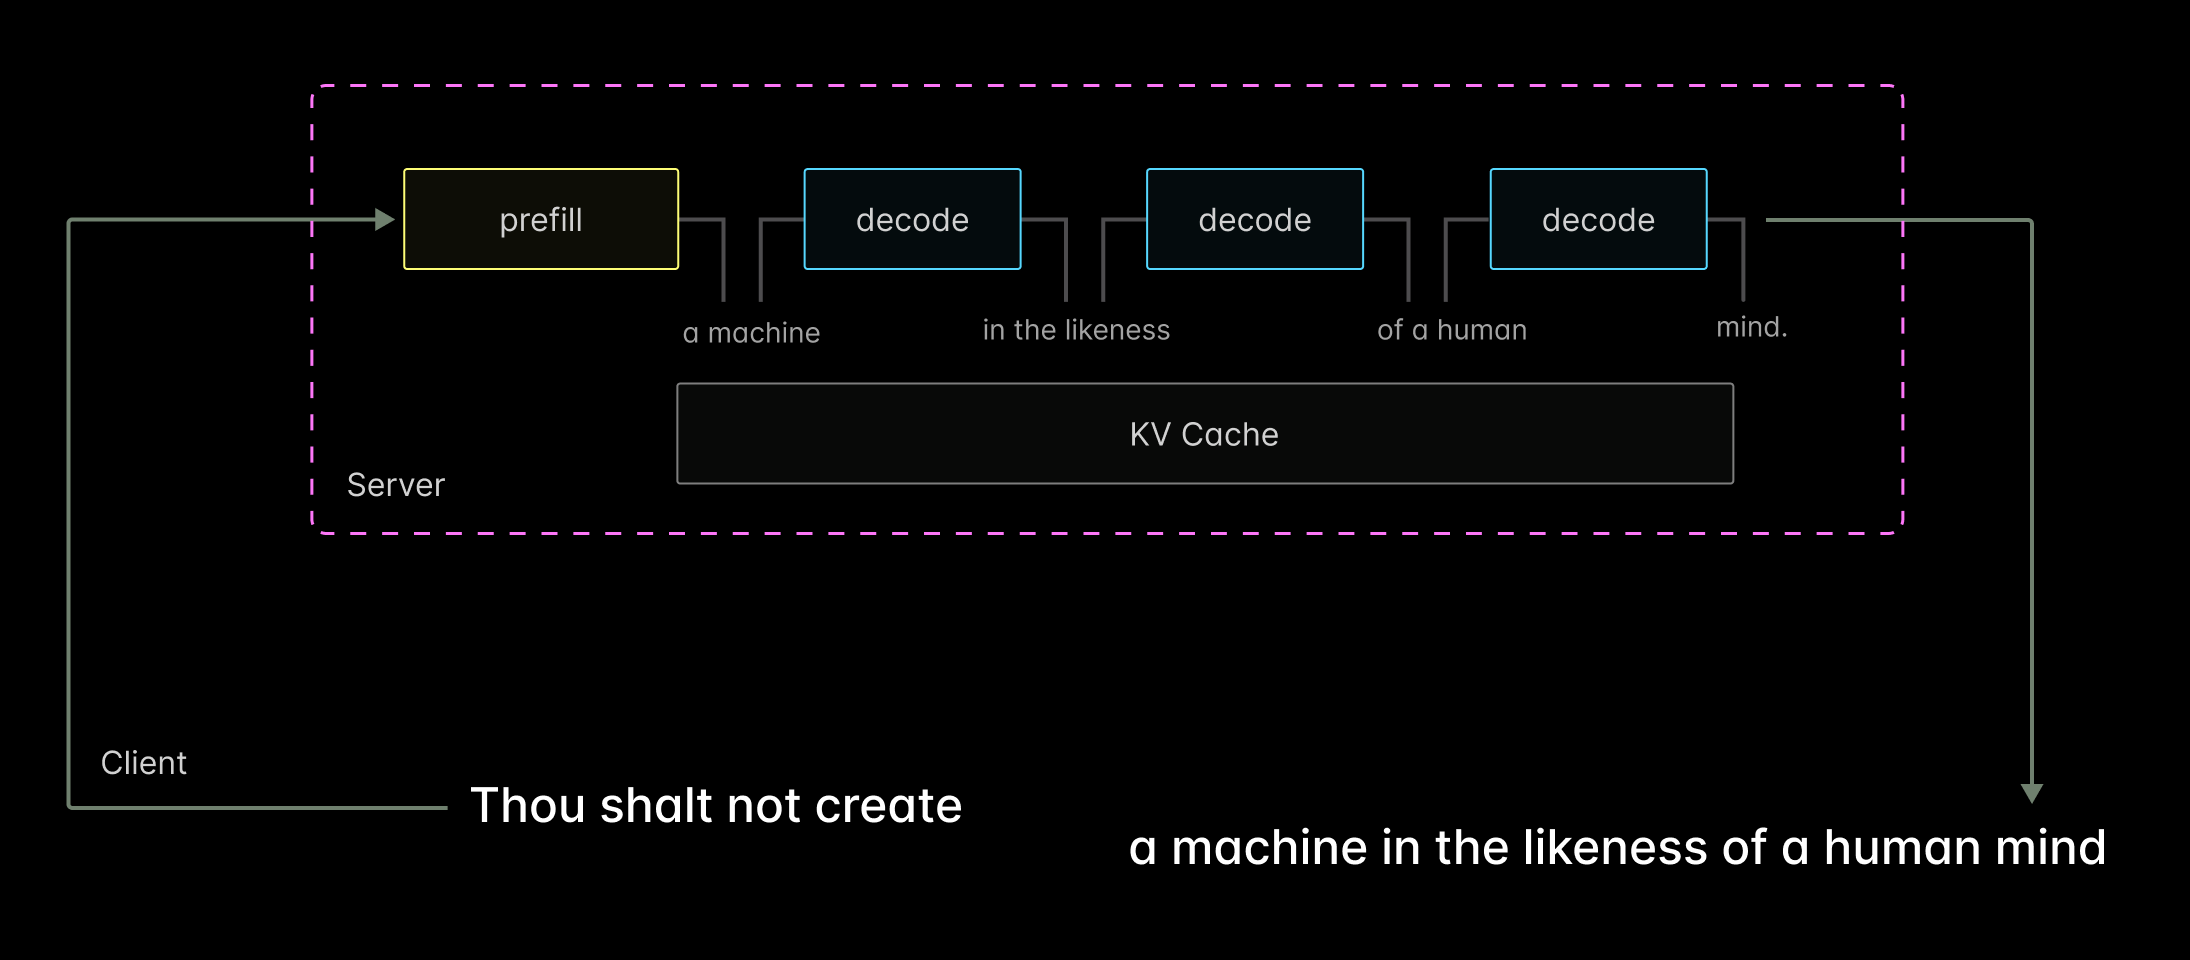
22. 비싼 순전파 비용을 분산하기 위해 여러 시퀀스를 배치 처리(batching)하여 토큰별 연산을 공유하고, 내부 상태를 캐싱하여 토큰 간 연산의 재수행을 줄임.
23. 내부 상태 저장소는 역사적으로 키-값 캐시(key-value cache, KV cache)라고 부르지만, Kimi 같은 현대 모델에는 구분된 키와 값이 없기도 함.
24. 추론 비용의 간단한 계산법은 Kipply의 2022년 글 [「Transformer Inference Arithmetic」](https://kipp.ly/p/transformer-inference-arithmetic)을 참고할 수 있음.
25. 입력 토큰을 처리해 KV 캐시를 채우는 순전파는 프리필(prefill), 과거 상태를 바탕으로 출력 토큰을 생성하는 순전파는 디코딩(decode)이라고 부르며, 둘을 함께 수행하는 경우에는 이 용어 구분이 명확하지 않음.
26. 프리필 성능은 주로 첫 토큰까지의 시간(time-to-first-token, TTFT), 디코딩 성능은 이후의 초당 출력 토큰 수(tokens per second, TPS)로 측정함.
27. 두 지표 모두 클라이언트와 서버 어느 쪽에서도 측정할 수 있으므로 측정 위치에 따라 혼동이 발생할 수 있음.
28. Kimi K2.6는 약 1조 개의 가중치를 가지며 대부분을 4비트 정수(INT4)로 저장하지만, Modal은 4비트 부동소수점(FP4)으로 서빙함.
29. 4비트는 16개 값만 표현하므로 텐서 블록마다 별도 배율을 적용하는 마이크로 스케일링(micro-scaling)이 필요하며, Modal은 NVFP4 형식을 선택했음.
30. NVFP4는 B200·B300 같은 Blackwell GPU의 텐서 코어에서 페타플롭급 하드웨어 지원을 받음.
31. 제한된 GPU 공급 속에서 동적 GPU 풀을 운영하므로 B200과 B300 모두에서 실행하도록 준비했으며, 본문의 성능 결과는 B200 기준임.
32. B300은 대체로 유사하지만 캐싱에 사용할 고대역폭 메모리(high-bandwidth memory, HBM)가 더 많아 더 높은 요청 동시성을 지원함.
33. 추론 엔진은 SGLang을 기반으로 삼았으며, 성능 개선 패치를 작성하고 프로젝트에 업스트림 기여했음.
## 사용자 경험과 비용 효율을 최적화하려면 요청 사이의 시퀀스 구조를 이해해야 함
34. 코딩 에이전트 트래픽을 단순하게 서빙하면 동시 사용자 6명을 넘어서 처리량과 상호작용성이 급격히 무너지고, 그 이전에도 사용자 기대와 효율 기준을 충족하지 못했음.
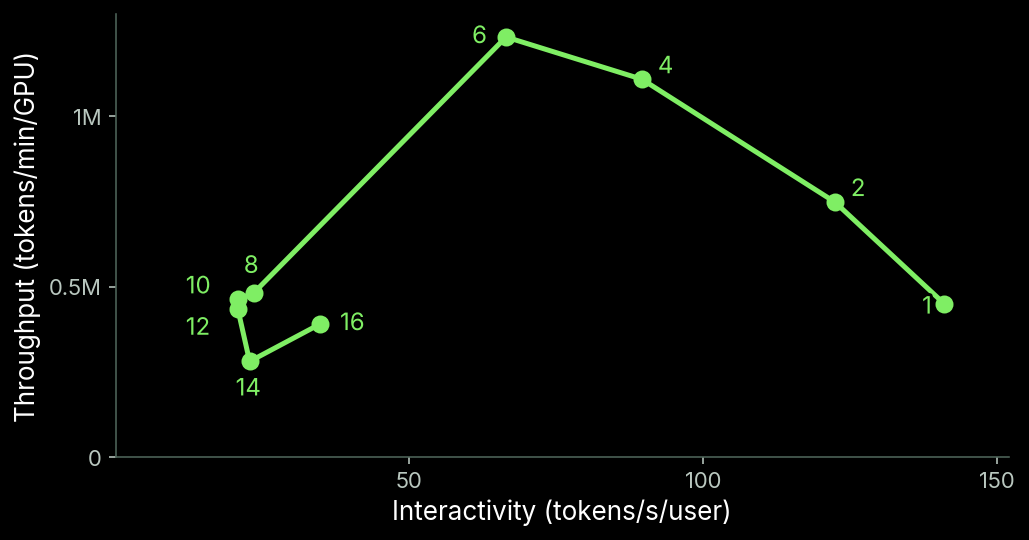
35. 이를 개선하려면 토큰 입출력 수만 볼 것이 아니라 사용자·모델·도구 호출이 반복 연결되는 세션(session)의 구조를 이해해야 함.
36. 세션은 매 턴 이전 기록에 새 정보를 더하면서 맥락과 가치를 축적하며, 이러한 반복적 의미 구성·정보 발견·이해 과정은 코딩 에이전트를 넘어 지속될 패턴으로 예상함.
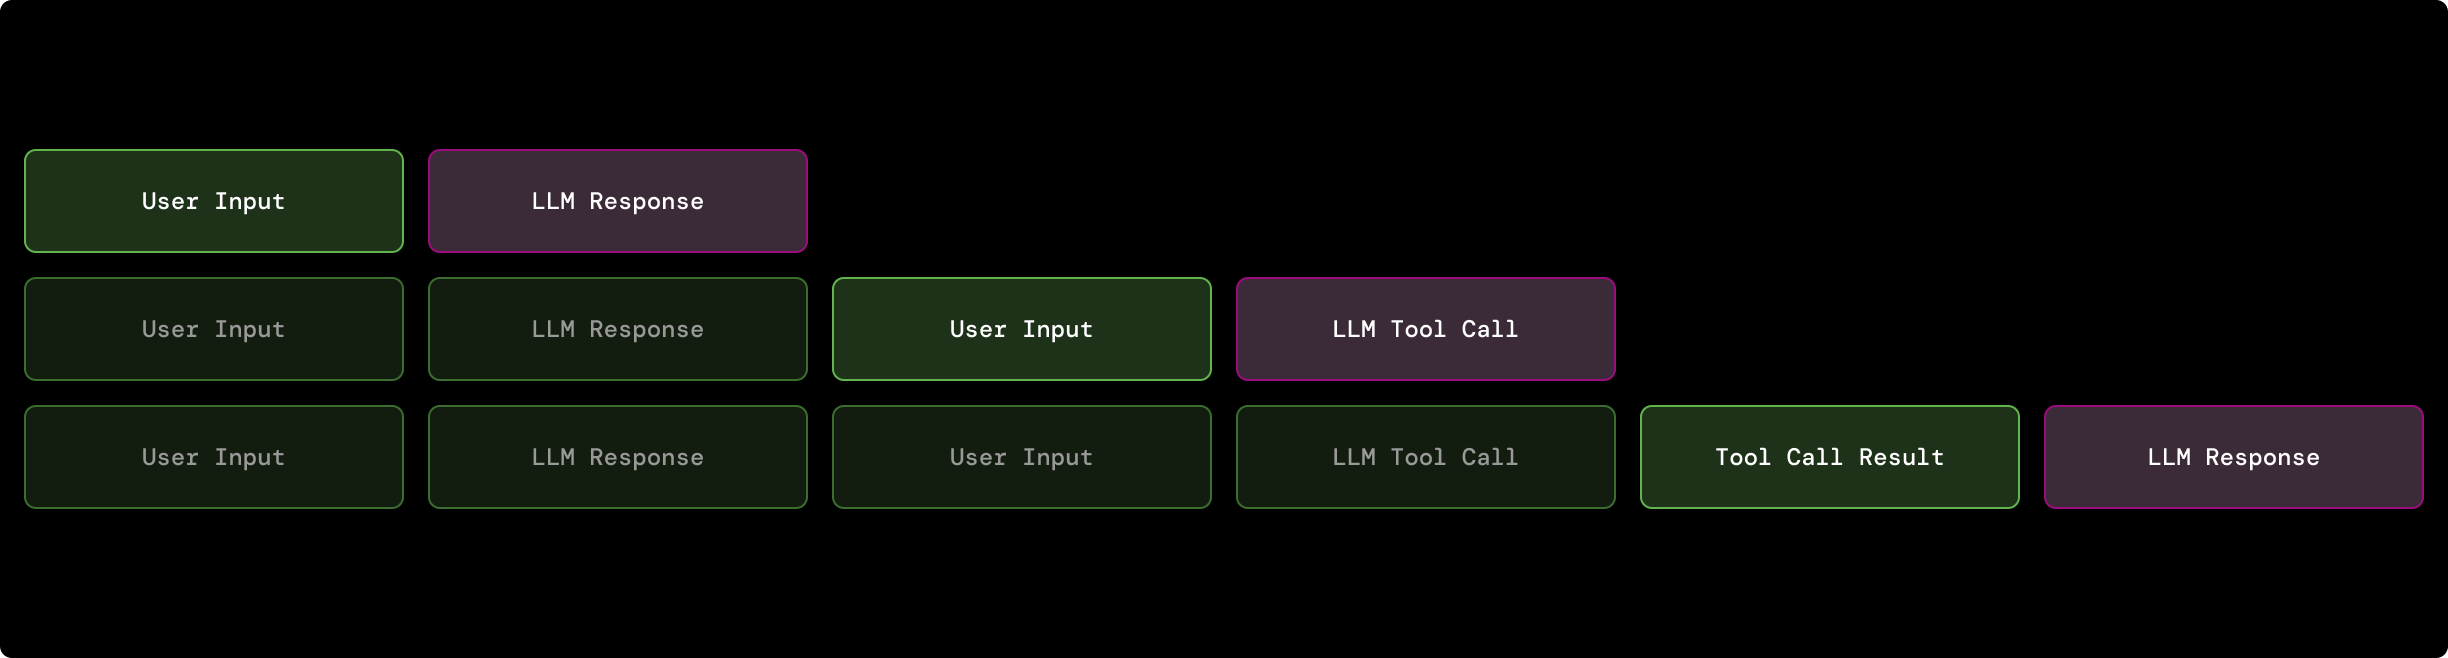
37. T번째 턴의 입력은 이전 세션 기록 전체와 새로운 입력으로 구성되므로, 수십 턴이 이어지는 요청은 출력보다 입력이 훨씬 길어짐.
38. 실제 최적화·운영 대상 워크로드는 요청당 입력 약 10만 토큰, 출력 약 500토큰으로 입출력 비율이 200:1이었으며, 처리 토큰 대부분이 입력이었음.
39. 각 턴의 입력은 이전 입력과 크게 겹치므로 캐시가 없다면 첫 번째 턴의 토큰은 T번째 턴까지 총 T회 처리됨.
40. 캐싱은 선형적으로 증가하는 재계산을 줄이는 대신 선형적으로 증가하는 상태를 관리해야 하며, **재계산 비용과 캐시 상태 비용 사이의 절충이 핵심 엔지니어링 문제임**.
## 다음으로 단일 복제본을 최적화함
41. 성능 최적화는 작동하는 시스템을 구축하고 병목을 식별한 뒤 제거하는 과정을 목표 달성까지 반복하는 방식임.
42. 전체 서비스 최적화를 먼저 단일 복제본 최적화와 다중 복제본 확장으로 나누고, 단일 복제본에서는 상호작용성을 최대화한 다음 이를 유지하면서 처리량을 높였음.
43. 상호작용성은 주로 요청 지연시간에 영향을 주며, 지연시간과 처리량은 진행 중인 요청 수인 동시성(concurrency)을 통해 리틀의 법칙(Little’s Law)으로 연결됨.
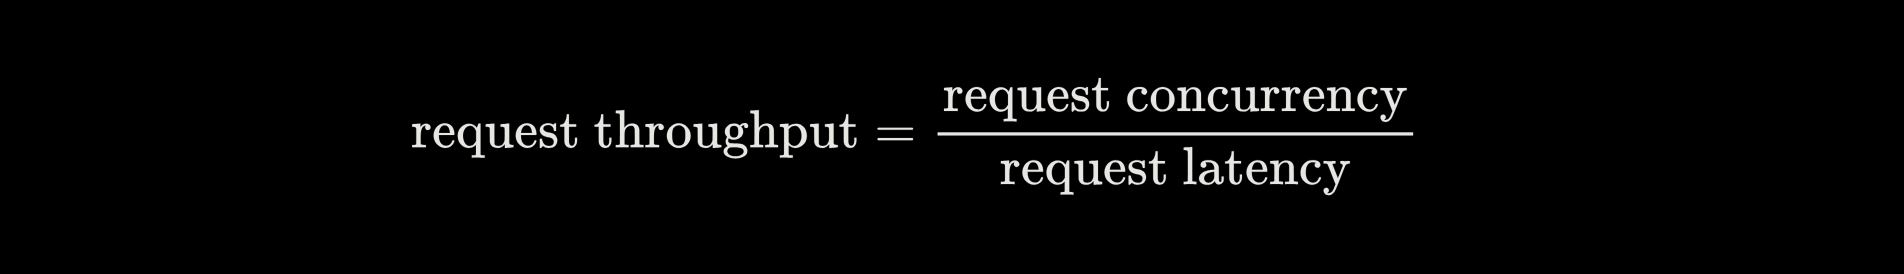
44. 초기 지연시간 병목은 디코딩 중 HBM 대역폭이었으며, 텐서 병렬화(tensor parallelism, TP)와 맞춤형 DFlash 추측 디코딩(speculative decoding)으로 메모리 읽기당 연산량을 늘려 완화했음.
45. 이후 병목은 HBM 용량에 따른 동시성 제한으로 옮겨갔으며, 중간 데이터 정리·저정밀 양자화·CPU RAM까지 확장하는 HiCache로 대응했음.
46. 캐싱 개선 지표로 캐시 적중률(cache hit rate, CHR)을 사용했으며, 대부분의 코딩 에이전트 워크로드에서 90~99% 수준이 실현 가능하다고 봄.
### 먼저 상호작용성을 최대화함
47. 코딩 에이전트 사용자는 더 빠른 토큰 생성을 선호하고 더 높은 가격도 지불하므로, 상호작용성을 먼저 개선했음.
48. 추측 디코딩은 학습 기반 기법이어서 연산량과 데이터에 따라 성능 이익이 확장되며, 머신러닝의 ‘쓰라린 교훈(bitter lesson)’이 성능 엔지니어링에도 적용되는 사례임.
49. 상호작용성 우선 전략은 수천 개 GPU를 동적으로 자동 확장하는 환경에서 작은 복제본을 운영하기 쉽고 처리량도 간접적으로 높인다는 추가 이점이 있었음.
**상호작용성을 최대화하는 복제본은 더 작고 서빙하기 쉬움**
50. 여러 GPU를 함께 사용하려면 인터커넥트(interconnect)가 필요하며, Nvidia GPU에서 가장 낮은 지연시간과 높은 대역폭을 제공하는 연결은 NVLink임.
51. 단일 호스트 운영체제는 최대 8개 GPU의 NVLink 도메인을 지원하며, 일반적으로 확보할 수 있는 가장 큰 도메인은 다중 노드 IMEX 도메인의 72개 가속기임.
52. 72개보다 많은 가속기를 묶으면 IB/RoCE나 일반 이더넷 같은 더 느린 연결이 필요해 통신 비용이 요청 지연시간 개선을 압도할 가능성이 높음.
53. 그렇다고 상호작용성을 위해 반드시 72개 가속기를 사용해야 하는 것은 아니며, 같은 NVFP4 Kimi K2.6를 비교한 SemiAnalysis InferenceX에서는 복제본당 8개 GPU 구성이 가장 높은 상호작용성을 보였음.
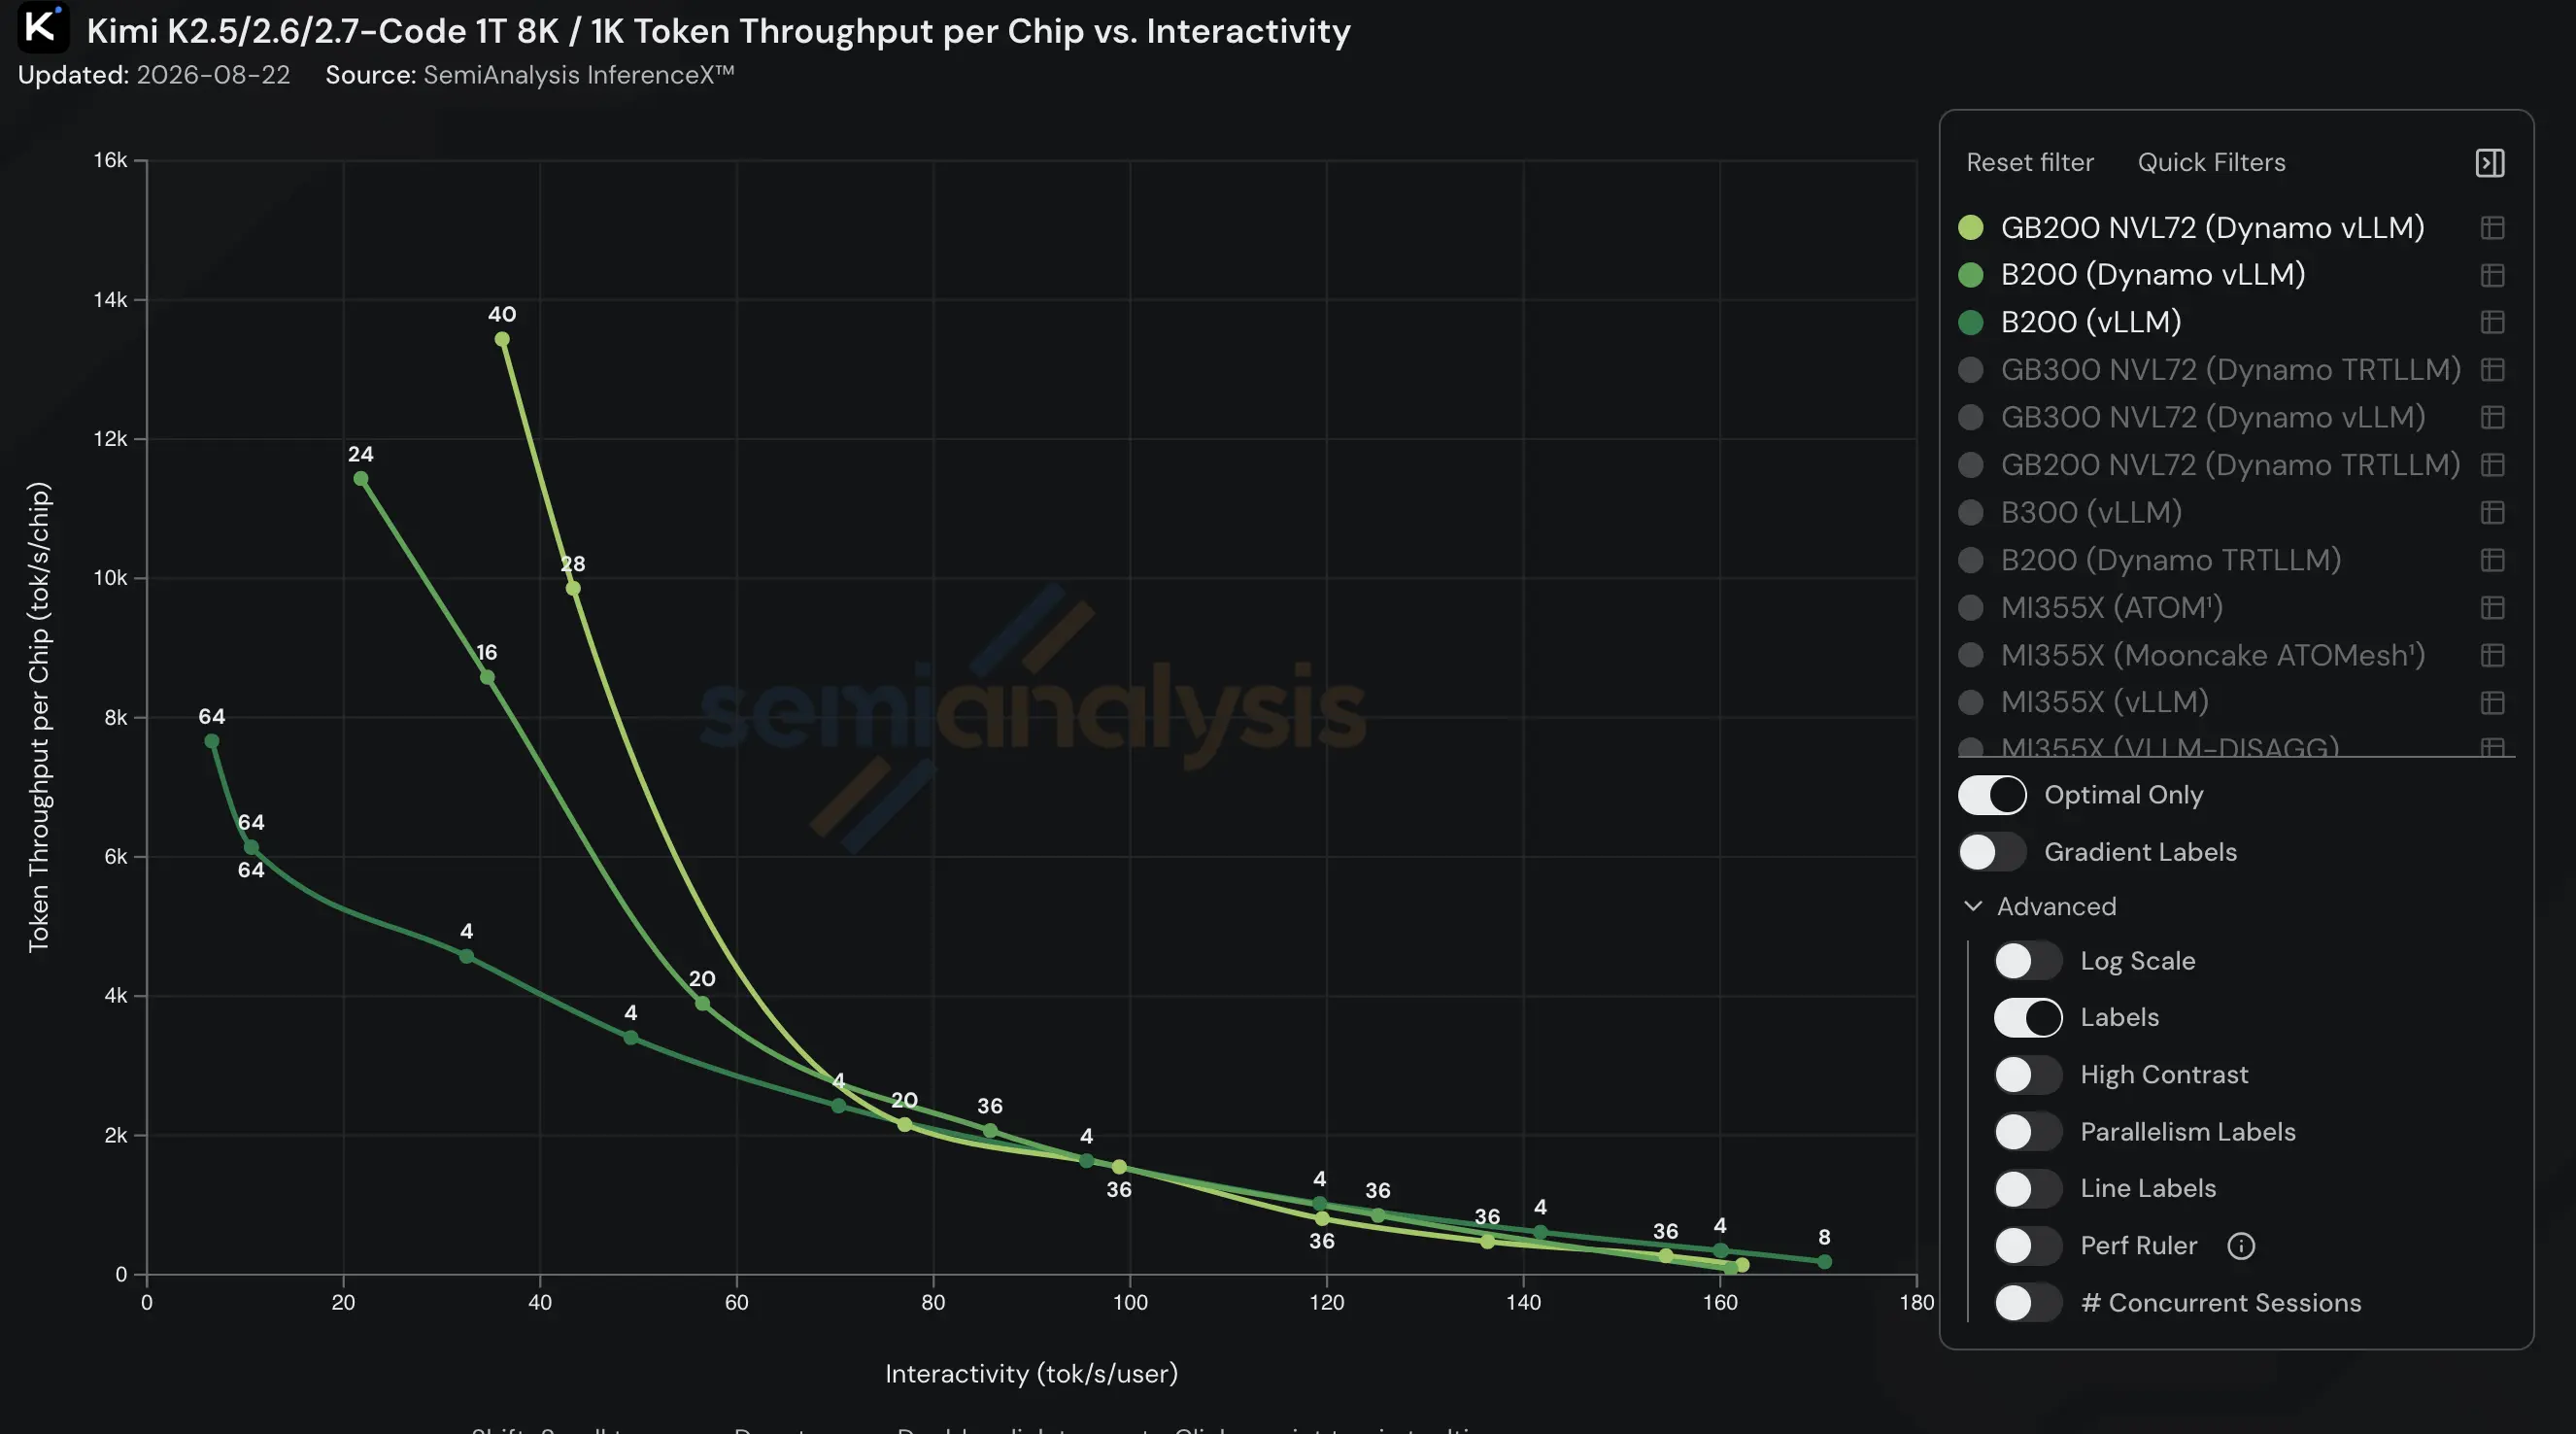
54. 8개 GPU 구성은 GPU당 처리량도 비슷했으며, 더 다양한 가속기·모델에서도 대체로 4개 또는 8개 GPU로 높은 상호작용성과 유사한 GPU당 처리량을 얻는 패턴이 나타났음.
55. 따라서 작은 복제본을 여러 개 확장해 전체 처리량을 확보할 수 있으며, Modal의 서버리스 플랫폼이 이 확장을 지원함.
56. 8개 GPU는 단일 호스트 운영체제 커널로 관리할 수 있지만 NVL72는 주소 공간을 공유하는 9개 하위 시스템으로 구성되며, 공급 제약과 장기적·경직된 계약이라는 운영 부담이 있음.
57. 8개 GPU Blackwell 시스템은 온디맨드·스폿 시장에서 확보하기 쉬워 변동 부하에 경제적으로 대응할 수 있음.
58. GPU 1·2·4개짜리 복제본은 8개 GPU 물리 머신 안에 배치할 수 있으며, 모델 가중치와 JIT 산출물 등 추가 복제본 시작에 필요한 자원도 이미 갖춰져 있음.
59. 연산 자원 공급과 사용자 요구가 달라지면 이러한 구성 선택도 재검토할 예정임.
**상호작용성을 높이면 처리량도 간접적으로 증가함**
60. 개별 요청을 더 빨리 끝내면 새 요청에 사용할 자원을 빨리 확보하므로 처리량이 간접적으로 개선됨.
61. 코딩 에이전트 세션은 대체로 이전 응답이 끝난 뒤 도구나 사용자의 반응을 기다리는 폐쇄 루프(closed-loop) 구조임.
62. 도구 호출 대기는 수십 밀리초에서 수초이며 긴 경우 수분이고, 사용자 응답 대기는 수초에서 수분이며 긴 경우 수시간 이상임.
63. 이 대기 중 같은 노드는 다른 요청을 처리할 수 있으며, 빠른 자동 확장은 활성 용량에 충분한 요청이 공급되거나 활성 부하에 충분한 노드가 확보되도록 지원함.
#### 맞춤형 추측 디코딩으로 상호작용성 병목에 도달할 때마다 더 많은 작업을 수행함
64. 자기회귀 모델은 기본적으로 토큰을 순차 생성하므로 암달의 법칙(Amdahl’s Law)에 따른 제약을 받음.
65. 토큰 하나를 생성할 때마다 수 GB 이상의 가중치와 KV 캐시를 HBM에서 스트리밍 멀티프로세서의 L1 캐시로 읽어야 하며, 이 시간이 실제 다음 토큰 연산보다 긴 경우가 많음.
66. 병렬화는 가용 대역폭을 늘리지만 긴 시퀀스의 토큰 간 연산에서는 한계가 있으므로, 추측 디코딩으로 병목을 완화했음.
67. 추측 디코딩은 순차 의존성 때문에 남는 연산 능력을 실제로 사용되지 않을 수도 있는 작업에 투입한다는 점에서 프로세서의 추측 실행(speculative execution)과 같은 절충을 이용함.
68. 더 작고 빠른 초안 모델(draft 또는 speculator)이 다음 여러 토큰을 예상하고, 실제 서빙 모델(target 또는 verifier)이 이를 병렬 검증함.
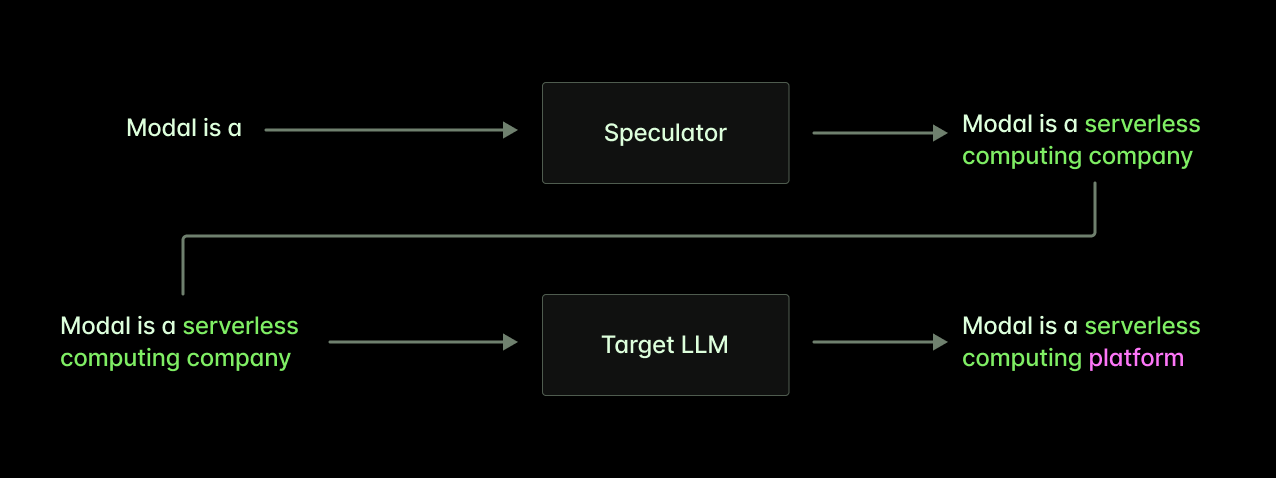
69. 이 가속은 대상 모델의 출력 확률분포를 바꾸지 않으며, 성능 향상도 수십 퍼센트가 아니라 몇 배 수준에 이를 수 있음.
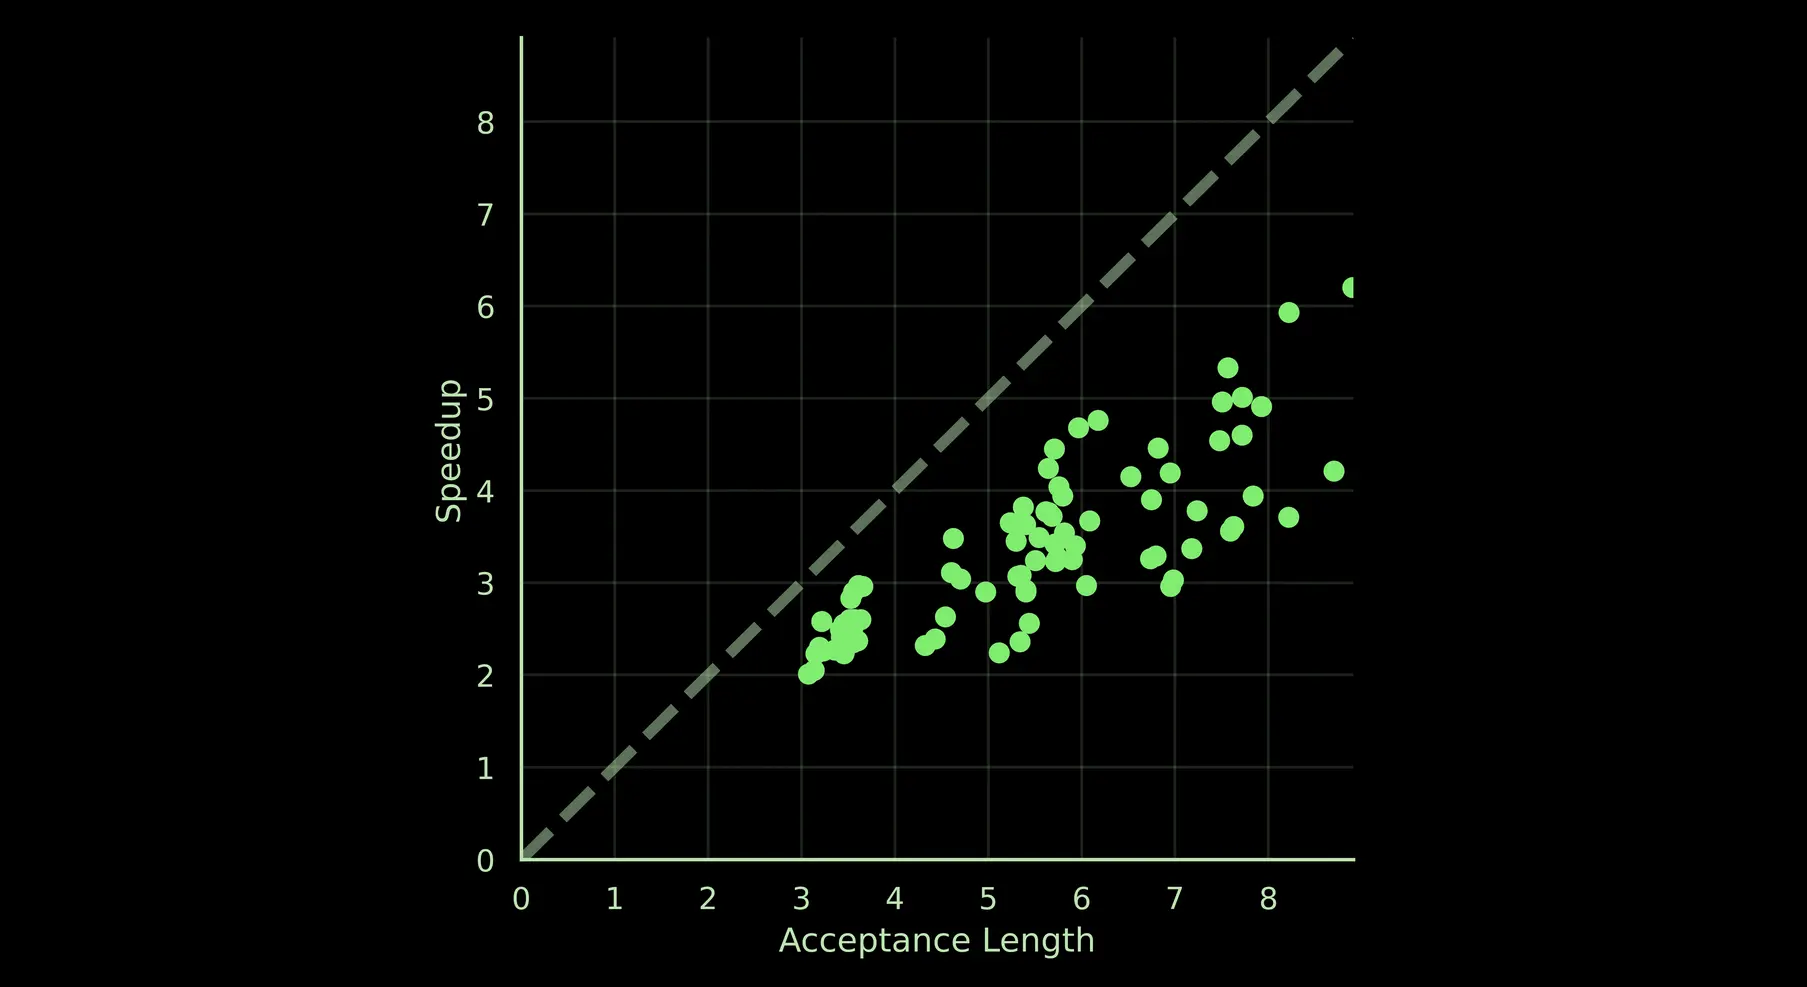
70. 특히 코딩 에이전트에서는 초안 모델이 평균적으로 다음 4개·8개 이상의 토큰을 맞히는 일이 비교적 쉬우며, 대상 모델의 내부 표현을 재사용할 수 있고 상당수 토큰에 대상 모델의 전체 지능이 필요하지 않기 때문임.
##### 초안 모델은 대상 모델의 작업을 재사용할 수 있음
71. 대상 모델은 정적 토큰 임베딩을 각 계층에서 점차 풍부한 표현으로 바꾼 뒤 마지막 언어 모델링 헤드에서 다음 토큰 확률분포로 변환하며, 유용한 내부 상태는 이미 KV 캐시에 저장되어 있음.
72. [DFlash](https://www.lmsys.org/blog/2026-06-15-next-generation-speculative-decoding-dflash-v2/)와 [DSpark](https://arxiv.org/abs/2607.05147) 같은 구조는 이 상태를 입력으로 재사용하므로 대상 모델보다 수십·수백 배 이상 작고 빠른 초안 모델을 구성할 수 있음.
##### 토큰 시퀀스는 반복적이고 정보 밀도가 낮음
73. 최근 모델의 출력에서 `You’re absolutely` 뒤에 이어질 내용이나 사용자의 앞선 입력을 인용하는 부분은 쉽게 예측할 수 있음.
74. 채팅 템플릿(chat template)의 특수 제어 토큰까지 고려하면 높은 지능 없이도 생성 가능한 구조가 상당 부분을 차지하지만, 구조 내부의 세부 정확성에는 여전히 대상 모델의 능력이 중요함.
75. 대상 모델의 용량 상당 부분은 여러 단계 뒤의 토큰을 예측하는 데 필요한 표현을 풍부하게 만드는 데 사용될 가능성이 있으며, 다음 토큰들을 미리 알면 해당 표현을 병렬 계산할 수 있음.
76. 병렬·순차 순전파를 함께 지원하는 성질은 전통적인 순환 신경망과 구별되는 현대 시퀀스 모델의 근본적 특성이며, 일반 트랜스포머와 선형·하이브리드 어텐션 모델 모두에 존재함.
77. Modal은 이러한 이유로 추측 디코딩에 크게 투자하고 있으며 다른 개발자에게도 같은 접근을 권장함.
##### 맞춤형 초안 모델은 채택 길이를 크게 늘릴 수 있음
78. 작은 초안 모델은 표현 용량이 제한되므로 일반적인 대상 모델의 행동보다 실제 운영 데이터에서 나타나는 행동을 예측하도록 학습하는 것이 효과적임.
79. 원문은 초안 모델의 손실을 대상 모델과의 쿨백-라이블러 발산(Kullback–Leibler divergence)으로 설명하며, 넓은 행동 범위의 포괄보다 주요 모드의 추적을 강조함.
80. 실험에서는 강한 범용 기반 모델을 먼저 학습한 뒤 특정 작업에 미세조정(fine-tuning)하는 방식이 더 좋았음.
81. Kimi K2.6용 DFlash를 범용 데이터 혼합으로 학습한 후 대상 모델이 출력한 코딩 실행 기록으로 미세조정했으며, 운영 중에도 대상 모델 출력으로 계속 학습할 수 있음.
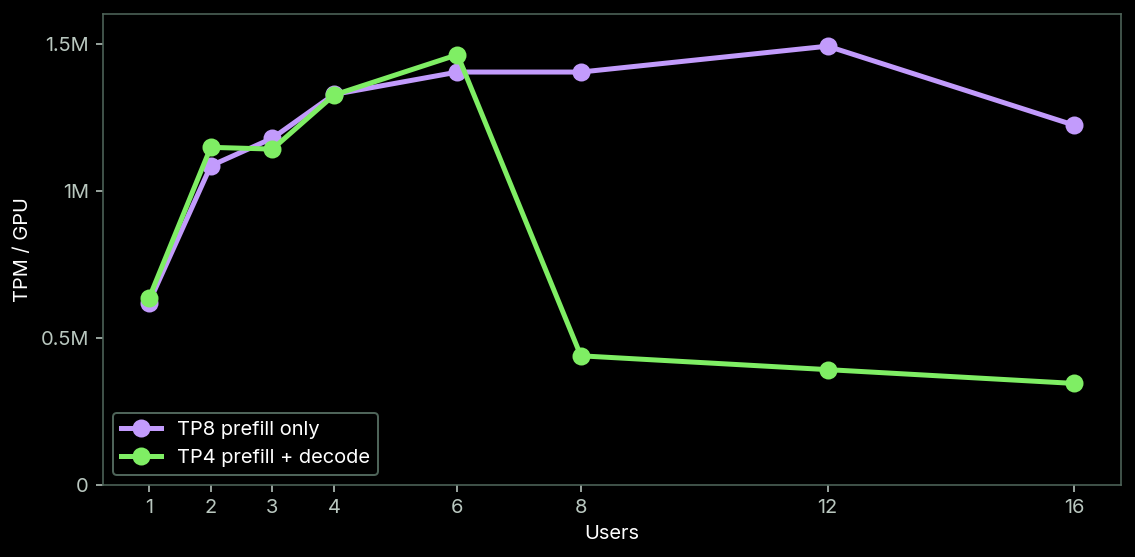
82. 토큰을 문자열로 바꿨다가 다시 토큰화하면 원래 토큰열이 보존되지 않지만 일반 HTTP 로그는 문자열을 저장하므로, `sglext`에서 원시 토큰 ID를 내보내도록 SGLang을 수정하고 [업스트림에 기여](https://github.com/sgl-project/sglang/pull/34488)했음.
83. 미세조정 결과 대표 실행 기록에서 단계당 평균 채택 길이가 5.00토큰에서 5.84토큰으로 늘었으며, 추가로 약 20%의 속도 향상을 얻었음.
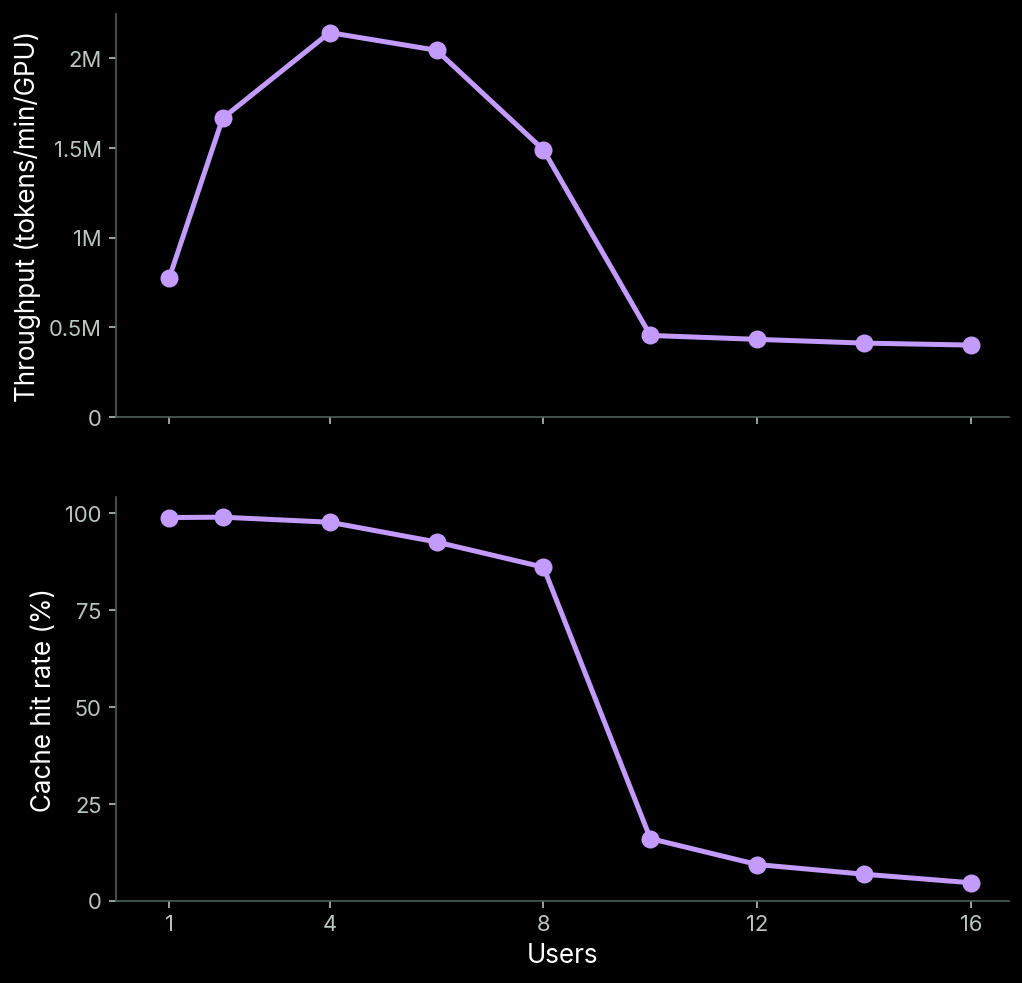
#### 상호작용성을 최대화하는 데는 텐서 병렬화가 가장 적합했음
84. 추론 병렬화는 요청 안의 순전파를 나누는 프리필·디코딩 분리(prefill-decode disaggregation), 계층을 나누는 파이프라인 병렬화(pipeline parallelism), 배치의 시퀀스를 나누는 데이터 병렬화(data parallelism)로 구분할 수 있음.
85. 이외에도 시퀀스의 토큰을 나누는 컨텍스트 병렬화(context parallelism), 계층 내부 행렬곱을 나누는 전문가 병렬화(expert parallelism), 행렬곱의 행·열을 나누는 텐서 병렬화가 있음.
86. 이 가운데 단일 요청 내부의 작업을 나누어 상호작용성을 직접 높이는 방식은 컨텍스트·전문가·텐서 병렬화임.
87. TP는 커널 내부 병렬화를 제외하면 가장 낮은 수준의 병렬화이므로 다른 전략과 조합하기 쉬워 첫 최적화 대상으로 적합함.
88. TP는 행렬곱 출력의 계산을 여러 작업자에게 나누고 필요한 모델 가중치도 분할하며, 자세한 원리는 [Megatron 논문](https://arxiv.org/abs/1909.08053)에 설명되어 있음.
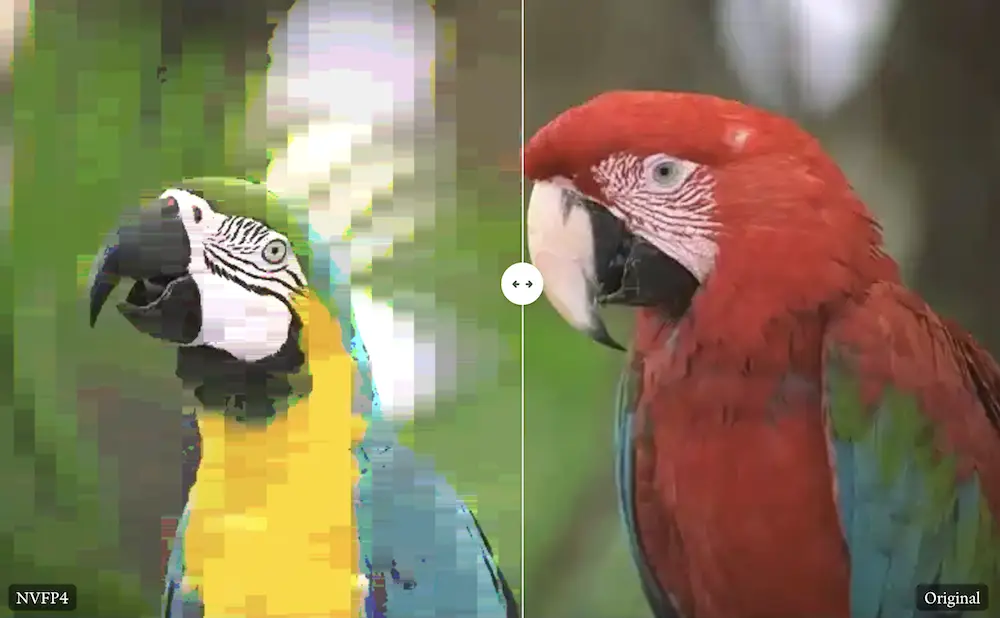
89. 다른 병렬화도 조사했지만 해당 워크로드에서는 TP만으로 상호작용성을 가장 잘 높일 수 있었음.
90. 예를 들어 데이터 병렬 어텐션은 KV 캐시를 분할해 동시성을 높였지만 지연시간이 크게 늘어 GPU당 전체 처리량은 오히려 감소했음.
91. B200에서 수십만 토큰 길이의 Kimi K2.6를 실행할 때 실현 가능한 구성은 GPU 4개를 쓰는 TP4와 8개를 쓰는 TP8이었음.
92. B200 하나의 HBM은 180GB이고 모델 가중치는 약 595GB이므로 TP1·TP2는 가중치를 담지 못하며, CPU RAM이나 디스크로 넘기면 지연시간이 크게 악화됨.
93. BF16 KV 항목은 576개 원소와 61개 계층을 기준으로 토큰당 약 72KB가 필요하며, 원문이 제시한 구성별 용량 추정은 다음 표와 같음.
| 구성 | 전체 HBM | 가중치 제외 HBM | GPU당 대략적 KV 공간 | 대략적 KV 토큰 용량 |
|---|---:|---:|---:|---:|
| TP1 | 180GB | -415GB | 해당 없음 | 해당 없음 |
| TP2 | 360GB | -235GB | 해당 없음 | 해당 없음 |
| TP4 | 720GB | 125GB | 31.3GB | 45만 토큰 |
| TP8 | 1.44TB | 845GB | 105.6GB | 300만 토큰 |
94. TP8은 하드웨어가 두 배일 때 캐시 용량이 약 여섯 배여서 유리해 보이지만, 목표 상호작용성을 만족하는 동시성에서 프리필만 실행해도 TP4가 프리필과 디코딩을 함께 실행할 때와 GPU당 처리량이 비슷했음.
95. TP8에 유리한 조건에서도 비용 효율상 우위를 얻지 못했으므로 TP4를 선택했으며, 대신 매우 제한적인 KV 캐시 용량을 개선해야 했음.
### KV 캐싱 개선으로 처리량의 동시성 병목을 제거함
96. 입력이 요청당 최대 약 10만 토큰인 TP4 환경에서는 사용자 약 4명의 대화까지만 상호작용성 저하 없이 배치할 수 있었음.
97. 이를 넘으면 CHR이 급락하고 긴 입력을 재계산하면서 상호작용성과 처리량이 무너졌으며, 재계산은 HBM에서 KV를 읽는 것보다 훨씬 느렸음.
#### HBM에서 불필요한 데이터를 정리함
98. 가장 직접적인 개선은 낭비되는 HBM을 찾아 KV 캐시에 돌려주는 것이었음.
99. SGLang의 DFlash 구현은 대상 모델의 중간 데이터를 포인터 목록으로 모은 뒤 순전파 끝에 연속 메모리로 복사하여 필요한 양의 두 배에 달하는 HBM을 사용했음.
100. 연속 버퍼를 미리 할당하고 순전파 중 직접 기록하도록 바꾸어 해당 중간 데이터의 최대 HBM 사용량을 절반으로 줄였으며, 기존 `append` 기반 로직은 유지했음.
101. 변경 사항은 [SGLang PR #28956](https://github.com/sgl-project/sglang/pull/28956)으로 업스트림에 반영했음.
#### 양자화로 HBM 공간을 확보함
102. 다음으로 쉬운 공간 절감 방법은 더 낮은 정밀도의 부동소수점을 사용하는 양자화(quantization)이지만, 추측 디코딩이나 낭비 제거와 달리 출력과 애플리케이션 품질을 나쁘게 바꿀 수 있음.
103. 아래 그림은 블록 양자화 결과와 원본을 비교한 것이며, [LLM Engineer’s Almanac 시각화 도구](https://modal.com/llm-almanac/block-quants/nvidia-fp4)에서 영향을 확인할 수 있음.
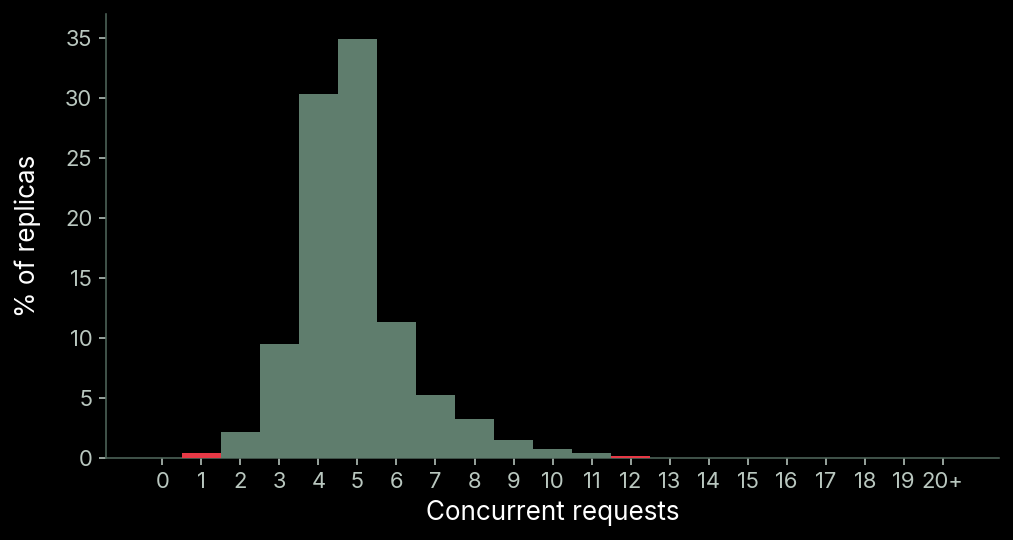
104. 손실이 있는 변경이라도 대상 애플리케이션의 결과에는 영향이 없음을 검증하는 능력이 중요하며, 이는 맞춤형 자체 호스팅 추론이 범용 다중 테넌트 API와 차별화되는 지점임.
105. 초안 모델의 정확성은 최종 출력의 정확성보다 속도에 영향을 주고 성능 저하도 비교적 점진적이므로 양자화하기 쉬우며, DFlash의 FP8 지원을 [SGLang PR #28957](https://github.com/sgl-project/sglang/pull/28957)로 기여했음.
106. 실제 애플리케이션 결과에 영향을 줄 수 있는 최적화에는 평가(evaluation)가 필수이므로, Modal은 자체 평가 역량에 투자하고 Moonshot의 [Kimi Vendor Verifier](https://www.kimi.ai/blog/kimi-vendor-verifier) 같은 품질 검증도 지원함.
107. 평가 결과 KV 캐시를 BF16에서 FP8로 바꾸어 토큰 기준 캐시 용량을 두 배로 늘릴 수 있었음.
108. 대부분의 전문가 행렬곱은 이미 NVFP4였지만 모든 토큰에서 활성화되는 공유 전문가(shared expert)는 FP8이었으므로, 이를 NVFP4로 바꾸어 추가 HBM을 확보했음.
109. KV 캐시와 공유 전문가의 양자화 모두 평가에서 실행 간 비결정성에 비해 유의미한 품질 저하를 보이지 않았음.
#### HiCache로 KV 캐시 용량을 확장함
110. HBM만 사용하면 입력 상태를 매우 빠르고 비싼 GPU 메모리에 유지하거나 버리는 두 선택지만 남으며, 필요한 KV가 HBM을 넘는 순간 CHR과 성능이 급격히 하락함.
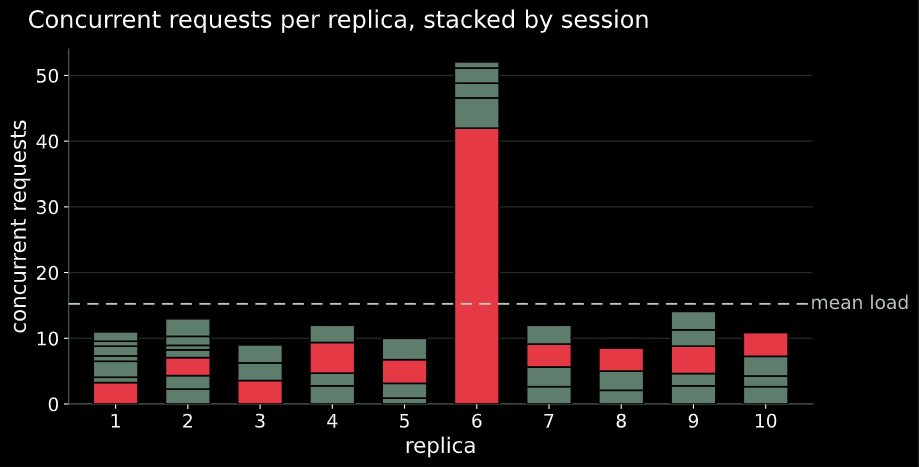
111. 다층 캐시는 부하 증가에 따른 성능 하락을 더 완만하게 만들며, SGLang의 [HiCache](https://www.lmsys.org/blog/2025-09-10-sglang-hicache/)는 호스트 메모리를 L2, 분산 저장소를 L3로 추가함.
112. 상위 캐시 계층은 더 느려 지연시간과 처리량을 악화시킬 수도 있으므로, Modal은 CPU RAM 기반 L2만으로 상당한 효과를 얻고 주로 초과 부하를 흡수하는 용도로 사용했음.
113. HiCache가 없을 때는 최적 동시성을 조금만 넘어도 성능이 급락해 최대 성능 지점 자체를 운영 목표로 삼기 어려웠지만, 적용 후에는 일시적 과부하에서도 성능 변화가 완만해졌음.
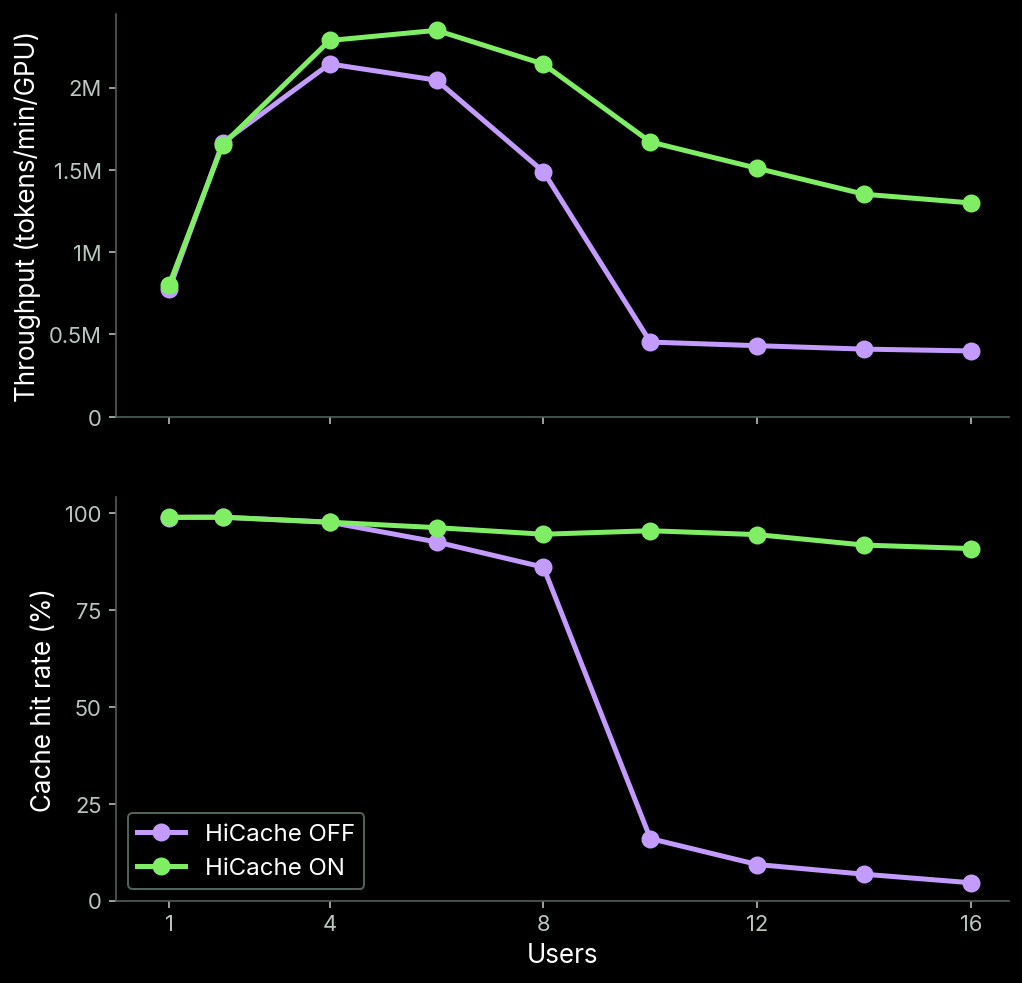
114. 사용자·에이전트 행동의 비결정성과 복제본 간 요청 라우팅 때문에 각 복제본이 항상 목표 부하를 정확하게 유지할 수는 없음.
## 마지막으로 여러 복제본으로 확장함
115. 단일 복제본 최적화 후에는 [Modal Server](https://modal.com/blog/serverless-servers) 뒤에 추론 엔진 복제본의 자동 확장 풀을 배치했음.
116. 확장 시점 결정, 자원 확보, 호스트 준비, 복제본의 빠른 시작, 장애 복구, 관측 가능성, 자원 반환은 Modal의 기반 플랫폼이 처리했으므로 대부분의 추가 작업은 라우팅 계층에 집중되었음.
117. KV 캐시는 복제본에 상태를 만들지만, 캐시 미스 시 재계산할 수 있고 애플리케이션 정확성에는 필수가 아닌 일시적 상태임.
118. 다만 재계산의 성능 비용이 크므로 라우팅이 중요해졌으며, 실제로 대기 요청·꼬리 TTFT·종단간 지연시간의 반복 급증과 예상보다 낮은 복제본당 처리량이 관찰되었음.
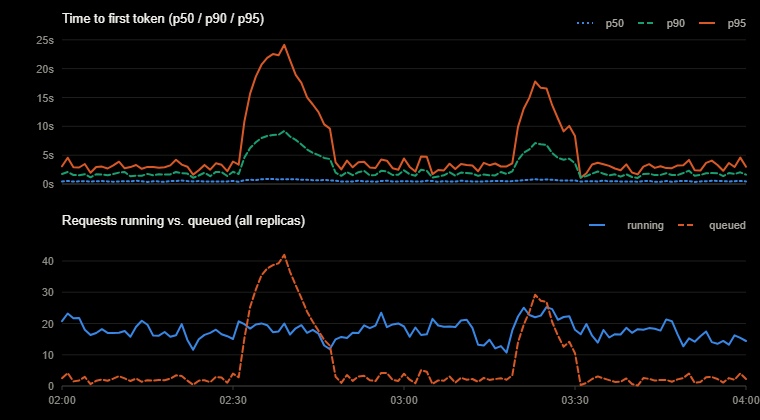
119. 두 문제의 직접 원인은 이전에 본 입력과 겹치는데도 KV 전체를 다시 계산하는 콜드 프리필(cold prefill)이었으며, 근본 원인은 세션 내부 동시성과 불운한 해싱에 취약한 무상태 라우팅이었음.
120. 이를 계기로 상태와 KV 캐시를 인식하는 라우팅 알고리즘을 추가했으며, Modal Server에서 사용하려는 고객에게 문의를 안내함.
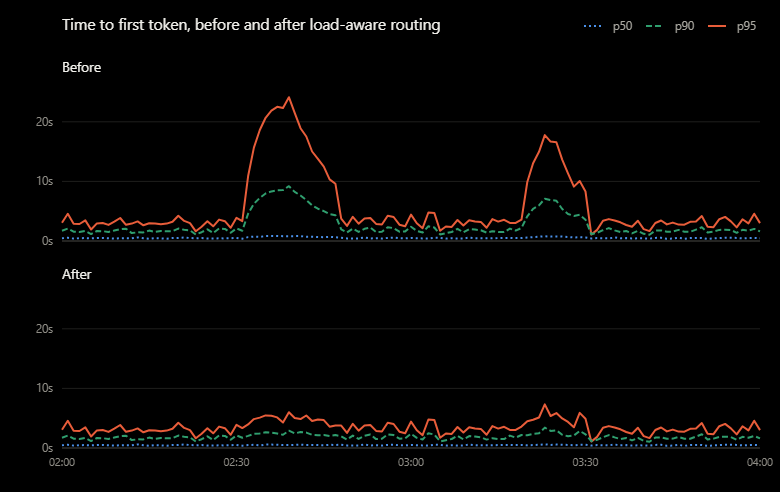
### 처음에는 무상태 세션 친화성 라우팅을 사용했음
121. Modal Server의 기본 동작은 요청별 균등 무작위 라우팅이며, 클라이언트가 `Modal-Session-Id` 헤더를 제공하면 이를 해싱하여 특정 복제본으로 연결함.
122. 같은 에이전트 세션에서 ID를 재사용하면 이전 입력을 처리한 복제본의 KV 캐시를 활용할 수 있어 대체로 성능이 좋아짐.
#### 규모가 커져도 불운한 해싱은 사라지지 않음
123. 균등 무작위 세션 라우팅은 동시 사용자가 많고 복제본별 세션 수의 편차를 넓게 허용할 때는 잘 작동하지만, 높은 상호작용성을 위해 낮은 동시성을 정밀하게 유지해야 하는 환경에는 부적합함.
124. 복제본별 세션 수는 전체 세션 수를 N, 복제본 수의 역수를 p로 하는 이항분포를 따르며, 빠르게 평균이 Np인 포아송분포(Poisson distribution)에 가까워짐.
125. 자동 확장이 평균 동시성을 일정하게 유지하더라도 포아송분포의 분산은 평균과 같으므로, 규모를 키워도 복제본별 부하의 분산이 줄지 않음.
126. 복제본 50개로 250개 세션을 처리하여 평균을 5로 유지할 때, 특정 복제본이 세션 1개 이하를 담당할 확률은 약 4%, 12개 이상을 담당할 확률은 약 0.5%이며 이 비율은 규모와 무관함.
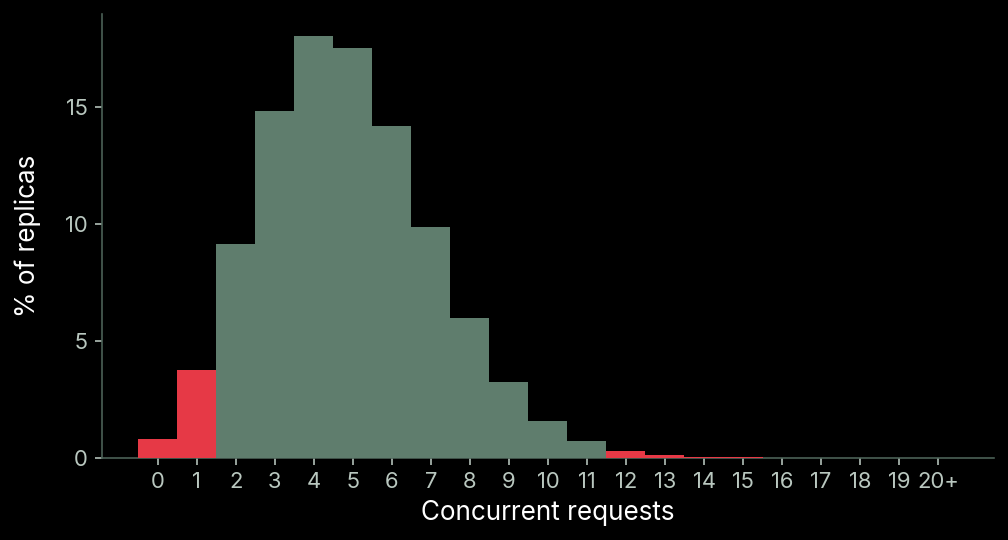
127. 적은 부하는 전체 효율을 낮추고 많은 부하는 꼬리 지연시간을 늘리며, 코딩 에이전트 워크로드는 이러한 분산을 감당하기 어려움.
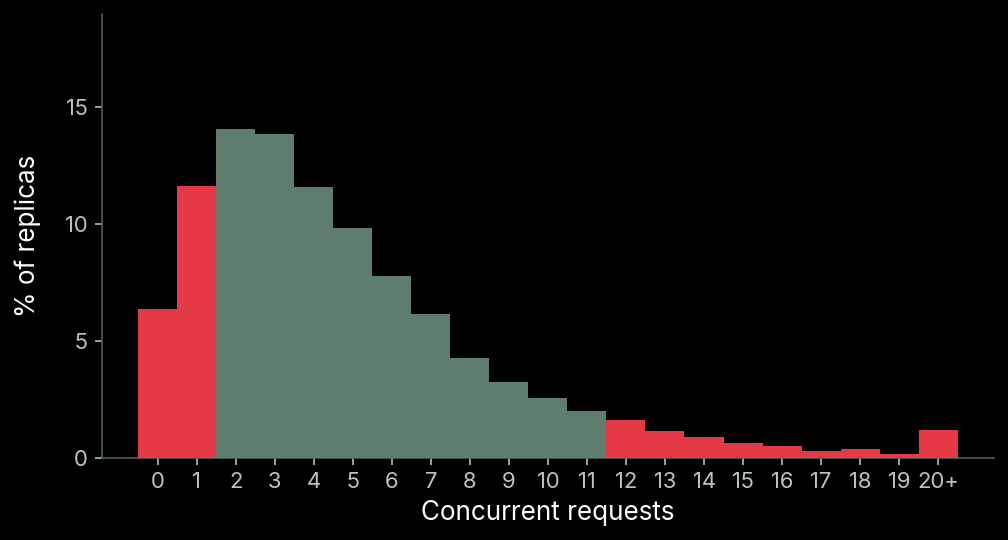
128. 실제 환경은 모델의 가정에서 벗어나므로 분산이 평균의 몇 배에 달하고 오른쪽 꼬리도 훨씬 두꺼웠으며, 이것이 관찰된 TTFT 꼬리 지연과 처리량 부족의 원인이었음.
### 코딩 에이전트에 맞게 라우팅 시스템을 다시 작성함
129. 최종 라우터는 목표 동시 요청 수가 5인 배포에서 부하 분산을 평균의 절반 미만으로 낮춰, 포아송분포보다 훨씬 작은 편차를 달성했음.
130. 핵심 변경은 동시 요청이 많은 세션을 여러 복제본에 분할하고, 세션별 작업량 차이를 반영해 부하 기반으로 배치하며, 확장 시 새 세션을 새 복제본에 우선 배정하는 것이었음.
#### 동시 요청 세션을 분리해 과열된 복제본을 완화함
131. 부하 과분산과 꼬리 지연의 가장 큰 원인은 세션 하나가 요청을 한 번에 하나씩만 보낸다는 폐쇄 루프 가정의 위반이었음.
132. 세션 ID는 클라이언트가 제어하므로 동일 ID로 여러 요청을 동시에 보낼 수 있으며, 항상 같은 컨테이너로 보내면 전체 부하는 늘지 않아도 특정 복제본만 과부하가 됨.
133. 일반적인 코딩 에이전트 세션은 하위 에이전트가 있어도 동시 요청끼리 같은 ID를 공유할 필요가 없지만, [`/btw`](https://gist.github.com/ZhangHanDong/a123f194fc0e68c9d408355bd10746c6)처럼 세션이 트리 형태로 분기하면 공통 접두사를 가진 요청이 동시에 발생할 수 있음.
134. 실제 관찰에서는 복제본 6의 가장 큰 세션 하나가 목표 부하의 몇 배에 해당하는 동시 요청을 만들었음.
135. 이런 대형 동시성 세션은 완벽한 캐시 지역성을 지키는 것보다 일부 캐시를 중복하더라도 여러 복제본으로 분산하는 편이 성능에 유리함.
136. 라우터는 배정된 복제본으로 요청을 보내기 전에 해당 세션의 부하 임계치를 확인하고, 초과하면 다른 복제본으로 보냄.
#### 세밀한 부하 인식 배치로 불운한 라우팅과 세션별 차이를 해결함
137. 무작위 배치는 불운한 집중을 피하지 못하며, 부하가 많은 복제본에서는 요청 처리도 느려져 높은 부하가 오래 유지되는 악순환이 발생함.
138. 세션별 요청 길이도 수천 토큰에서 수십만 토큰까지 달라 세션 수만으로 작업량을 추정할 수 없음.
139. 새 세션은 할당된 세션 수가 아니라 실제 실행 중인 요청 수와 KV 사용률 등 세밀한 부하 신호를 기준으로 배정함.
140. 최초 배정 이후에는 세션 친화성을 유지하여 CHR을 보존함.
#### 확장 시 캐시 이동을 최소화함
141. 부하 증가로 복제본을 추가할 때 기존 복제본에는 진행 중인 세션의 따뜻한 캐시가 있으므로, 기존 세션을 가능한 한 그대로 유지하는 것이 유리함.
142. 랑데부 해싱(rendezvous hashing)은 복제본 추가 시 새 세션뿐 아니라 진행 중인 세션도 일부 재배치하며, 이동량을 약 1/N로 제한하더라도 상당한 KV 재계산과 지연을 유발함.
143. 새 세션을 부하가 낮은 복제본에 우선 배정하면 아직 부하가 쌓이지 않은 새 복제본으로 자연스럽게 유입됨.
144. 새 세션과 새 복제본의 생성 속도가 맞지 않아 추가 균형 조정이 필요할 때도 부하를 고려하여 세션을 재할당함.
## 배포하고 활용함
145. 라우팅 개선 후 다중 복제본 성능은 단일 복제본 결과에서 예상한 수준에 가까워졌으며, 배포 규모가 커져도 TTFT가 안정되고 복제본당 처리량이 유지되었음.
146. 전체 최적화로 여러 Kimi K2.6 서비스를 하루 수천억 토큰 규모로 운영하면서 초기 기준선과 다른 서비스보다 높은 상호작용성·비용 효율을 달성했음.
147. 이후 축적한 경험과 재사용 도구·인프라를 활용해 같은 과정을 다른 모델에 더 빠르게 적용했으며, Kimi K3도 포함되었음.
148. Modal은 서비스 품질에 따라 수요를 분배하는 OpenRouter 시장에서 Kimi K3 토큰 공급의 최다 점유율을 여러 차례 기록했음.
## “과학은 때때로 거짓말을 함”
149. 서비스 자체를 최적화하는 것만큼 벤치마크와 워크로드를 이해하는 데도 많은 시간을 썼으며, 벤치마킹은 어려운 작업임.
150. 중요한 지표 대부분은 시스템과 입력 워크로드 모두의 함수이므로, 시스템 변경 없이 데이터만 바꿔도 결과가 달라질 수 있음.
151. 항상 동일한 운영 데이터로 측정하는 방법이 단순한 해법이지만, 운영 데이터의 민감성과 요청별·시간별 변동 때문에 그것만으로는 충분하지 않음.
152. 제대로 된 성능 엔지니어링에는 평균 성능뿐 아니라 특정 상황의 동작도 이해해야 하므로, 일반적인 운영 범위를 벗어난 통제 실험으로 이론을 세우고 변경 효과를 분리해 측정해야 함.
153. TP8을 프리필 전용으로 실행하여 해당 환경에서 TP4보다 불리함을 확인한 것이 이런 실험의 예임.
154. GPU당 분당 토큰 수(TPM/GPU)는 출력 길이에 의존하며, 폐쇄 루프에서는 긴 시퀀스 하나를 생성하는 동안 일반적인 요청 여러 개가 완료될 수 있음.
155. 추측 디코딩의 채택 길이도 데이터에 의존하며, 코드는 산문보다 대략 두 배의 채택 길이를 보일 수 있음.
156. CHR은 개별 세션의 진행 경로에 의존하며, 이전 메시지를 사후 편집하는 등 캐시 친화적이지 않은 패턴은 캐싱 개선 효과를 없어 보이게 만들 수 있음.
## 그다음은 무엇인지 살펴봄
157. 이 작업은 한 고객의 특정 모델에 대한 코딩 에이전트 최적화로 시작했지만, 지연시간과 처리량에 민감한 분석 처리 등 다양한 추론 워크로드로 확대되었음.
158. Modal은 실제 운영에 추론을 배포하는 기업들과 협력하고 있으며, [문의 페이지](https://modal.com/blog/trillion-tokens-trillion-parameters#)를 통해 추가 협업을 안내함.
159. 성능 논의의 일반성 덕분에 다른 고객과 [Kimi K3](https://modal.com/blog/kimi-k3-by-moonshot-now-available-on-modal), [Qwen3.8](https://modal.com/blog/qwen3-8-2-4t-a95b-now-available-on-modal), [Inkling](https://modal.com/blog/inkling-by-thinking-machines-labs-now-available-on-modal) 등 다른 모델에도 적용할 수 있었음.
160. 이 경험은 자체 평가 플랫폼, 새로운 라우팅 시스템, 개선된 벤치마킹 기법 등 장기적인 서빙·평가 인프라 개선으로 이어졌음.
161. Modal은 핵심 자동 확장 클라우드 플랫폼이 이 글의 여러 저수준 엔지니어링 선택을 가능하게 했다고 평가함.
162. 플랫폼이 고성능 추론 실행에 가장 적합하다고 믿기 때문에 성능 노하우를 숨기지 않으며, 같은 이유로 오픈소스 기여도 지속함.
163. 추론 엔진 변경을 업스트림에 기여했을 뿐 아니라 Modal Auto Endpoints의 기반 코드와 설정도 공개했음.
164. `modal endpoint create`로 Kimi K2.6용 Dedicated Endpoint를 생성하면 구성을 직접 확인하거나 목적에 맞게 수정할 수 있음.
165. 추론에 관심 있는 시스템 엔지니어와 추론 전문가에게 [Modal 채용 페이지](http://modal.jobs/)를 안내함.
## 감사의 말
166. 이 작업은 [Moonshot AI](https://www.moonshot.ai/) 같은 공개 가중치 모델 제공자, [SGLang](https://github.com/sgl-project/sglang) 같은 오픈소스 추론 엔진, 연구와 구현을 공유한 연구자·엔지니어 공동체의 기여 덕분에 가능했음.